Блог

  • Свій сервер vs хмара: вважаємо TCO за 3 роки

    Свій сервер vs хмара: вважаємо TCO за 3 роки

    Кожен CTO, IT-директор чи техлід рано чи пізно стикається з цим питанням. Коли інфраструктура потребує оновлення, бізнес росте або потрібно запускати нові сервіси, дилема «хмара чи власний сервер» стає предметом палких суперечок між технічним відділом та фінансовим директором.

    Скептики традиційно стверджують, що «залізо» під столом або в локальному дата-центрі в довгостроковій перспективі обходиться дешевше. На перший погляд, порівняння рахунку за купівлю стійки серверів та щомісячного інвойсу від AWS, Microsoft Azure або Google Cloud Platform (GCP) може підтвердити цю теорію. Але диявол криється в деталях.

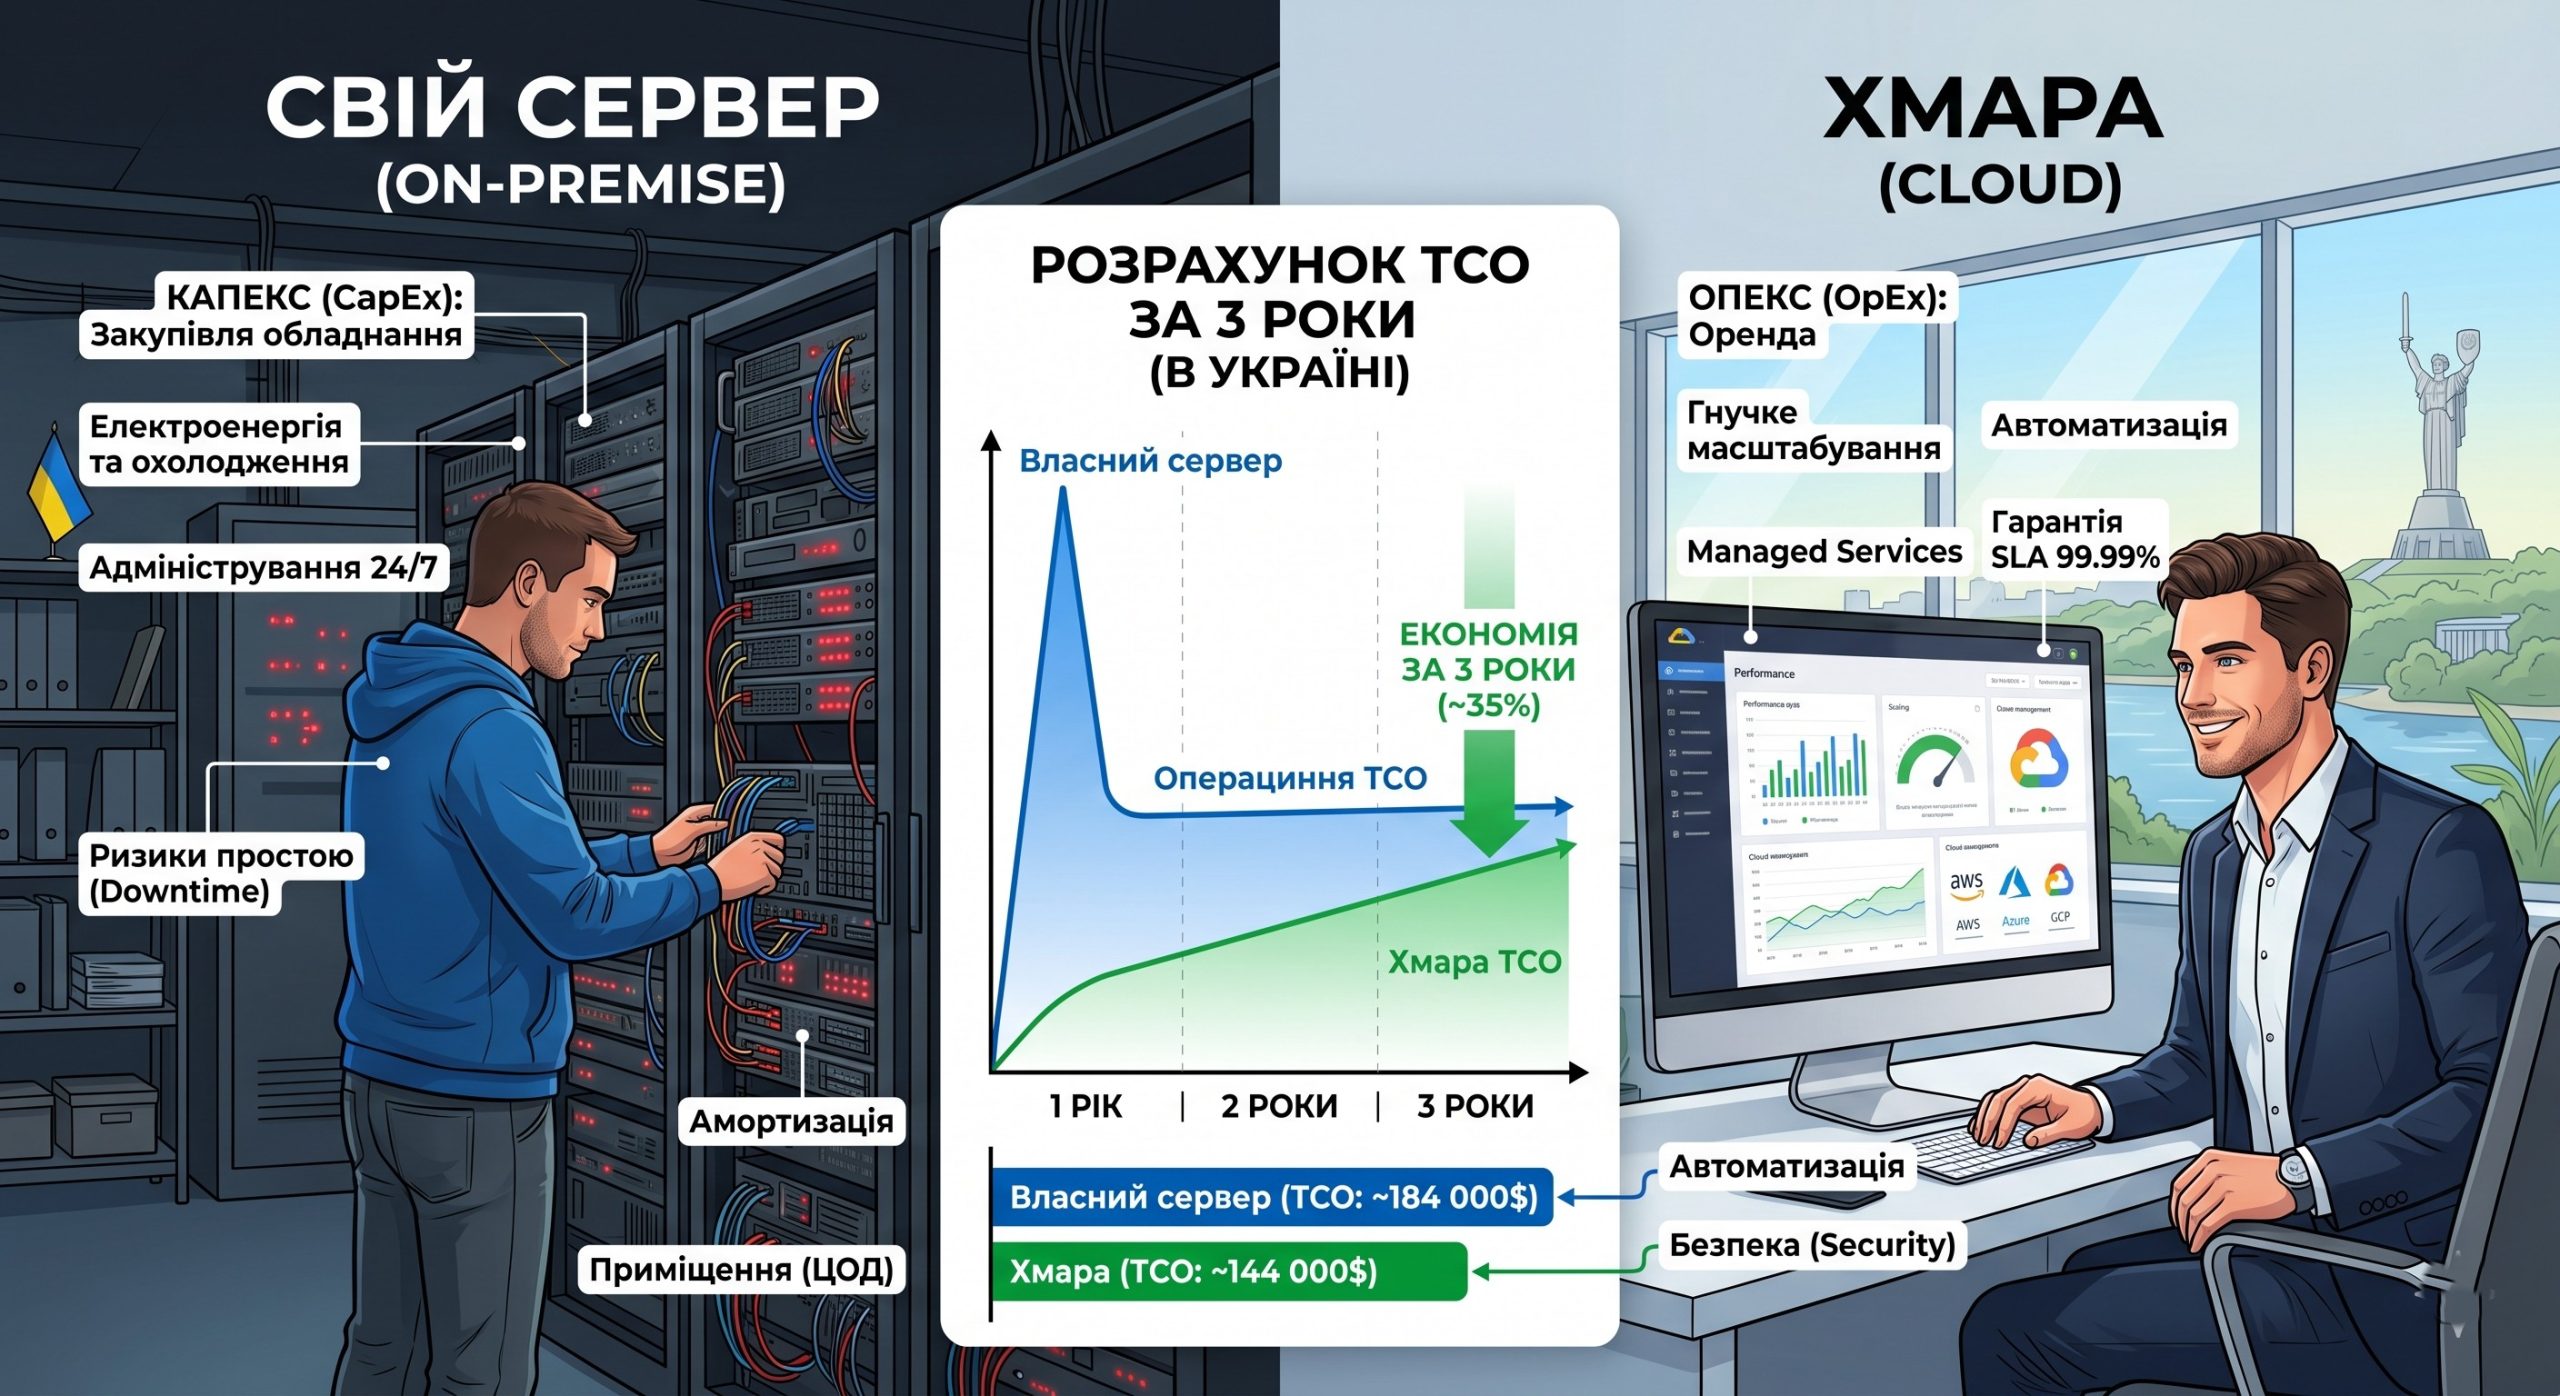
    Якщо ви хочете прийняти виважене рішення про інфраструктуру, вам необхідно розрахувати TCO хмари (Total Cost of Ownership — сукупну вартість володіння) і порівняти її з реальним TCO локального рішення на дистанції мінімум у 3 роки. У цій статті ми крок за кроком розберемо, за що ви справді платите в обох випадках, які витрати часто «забувають» включити до кошторису сисадміни, і чому для бізнесу в Україні хмарна міграція стала не просто трендом, а питанням виживання.Порівняння витрат CapEx на свій сервер та OpEx у хмарі при розрахунку TCO
    Що таке TCO і чому CapEx vs OpEx — це лише початок?

    Total Cost of Ownership (TCO) — це фінансова метрика, яка оцінює прямі та непрямі витрати на придбання, розгортання, використання та виведення з експлуатації IT-інфраструктури.

    Традиційно вибір між On-Premise (власним сервером) та Cloud (хмарою) зводиться до протистояння двох фінансових моделей:

    • CapEx (Capital Expenditure) / Капітальні витрати: Купівля фізичних серверів, СГД (систем зберігання даних), мережевого обладнання, ліцензій на віртуалізацію. Ви платите велику суму відразу.
    • OpEx (Operational Expenditure) / Операційні витрати: Оренда обчислювальних потужностей за моделлю Pay-as-you-go (плати за те, що використовуєш). Витрати розподіляються рівномірно за місяцями.

    Однак розрахунок лише вартості «заліза» проти вартості інстансів (віртуальних машин) у хмарі — це груба помилка, яка викривляє картину TCO мінімум на 40-50%.

    Приховані витрати на власний сервер (On-Premise), про які мовчать

    Коли захисники On-Premise інфраструктури доводять її дешевизну, вони часто ігнорують цілий пласт витрат. Давайте порахуємо, у що реально обходиться утримання свого обладнання протягом 3 років.

    1. Амортизація та життєвий цикл обладнання

    Сервери не працюють вічно. Стандартний цикл життя корпоративного «заліза» становить 3–5 років. До кінця третього року зростає ризик виходу з ладу компонентів (дисків, блоків живлення, оперативної пам’яті). Вам доведеться закладати бюджет на ЗІП (запасні частини та приладдя) або планувати новий масштабний CapEx на модернізацію.

    2. Витрати на дата-центр (Colocation) та електрику

    Якщо сервери стоять не в коморі вашого офісу (що неприпустимо для Enterprise-рівня), ви платите за оренду місця в стійці (Unit) у сертифікованому ЦОД. Сюди входять:

    • Плата за електроживлення (яке постійно дорожчає).
    • Охолодження (HVAC системи споживають до 40% енергії ЦОДу).
    • Резервування каналів зв’язку.

    3. Ліцензування ПЗ та віртуалізації

    Вам купили сервери? Чудово. Тепер потрібно купити ліцензії на VMware vSphere, Microsoft Windows Server, SQL Server тощо. У хмарі ліцензії на багато ОС та базове ПЗ вже включені в щохвилинну тарифікацію (або працюють за моделлю BYOL — Bring Your Own License), що дозволяє гнучко керувати витратами.

    4. Людський фактор та фонд оплати праці (ФОП)

    Це найбільша прихована стаття витрат. Для обслуговування своєї інфраструктури вам потрібен штат інженерів: системні адміністратори, мережеві інженери, фахівці з баз даних.

    У хмарі значну частину рутини (PaaS та SaaS рішення, керовані бази даних на кшталт Azure Cosmos DB або Amazon RDS, керований Kubernetes — AKS/EKS) бере на себе провайдер. Ваші DevOps-інженери фокусуються на автоматизації (наприклад, пишуть інфраструктурний код на Bicep або Terraform) та доставці цінності бізнесу, а не на заміні згорілих жорстких дисків о 2-й годині ночі.

    5. Ризики простою (Downtime Costs)

    Що станеться, якщо у ваш локальний ЦОД прийде з обшуком податкова? Або через аварію на підстанції відключаться резервні генератори? Вартість 1 години простою для великого e-commerce проєкту або SaaS-платформи може обчислюватися десятками тисяч доларів. Хмарні провайдери рівня AWS та Azure пропонують SLA з гарантією доступності 99.99% та катастрофостійкістю на рівні розподілених регіонів (Multi-Region, Availability Zones).

    TCO хмари: за що ми платимо AWS, Azure та GCP?

    Розраховуючи TCO хмари, скептики часто лякаються потенційних рахунків. Так, якщо ви просто перенесете віртуальні машини 1-в-1 за моделлю «Lift-and-Shift» (перенесення без оптимізації), хмара може виявитися дорожчою. Ефективність хмари розкривається при використанні Cloud-Native підходів.

    З чого складається вартість хмари:

    1. Обчислювальні ресурси (Compute): Віртуальні машини, контейнери (Kubernetes), Serverless-функції. Ви можете налаштувати автоскейлінг — на ніч відключати тестові середовища і знижувати потужності, заощаджуючи до 60% бюджету. Зі своїм сервером ви заплатили за 100% потужності, навіть якщо використовуєте 10%.
    2. Зберігання даних (Storage): Блокові сховища, об’єктні сховища (S3, Blob Storage), холодні архіви за копійчаними тарифами.
    3. Мережевий трафік (Egress): Важливий нюанс. Вхідний трафік у хмарі безкоштовний, а ось за вихідний доведеться платити. Це потрібно ретельно прораховувати архітекторам.
    4. Керовані сервіси (Managed Services): Так, керована база даних коштує дорожче, ніж «гола» віртуалка. Але ви заощаджуєте тисячі доларів на зарплаті DBA (адміністратора баз даних), оскільки патчинг, бекапи та реплікація робляться в 1 клік.

    Порівняльна таблиця: Власний сервер vs Хмара (Розрахунок на 3 роки)

    Нижче наведено спрощене порівняння сукупної вартості володіння для інфраструктури середнього бізнесу (умовно: 10 серверів, 2 ТБ RAM, 50 ТБ SSD Storage, 1 база даних SQL).

    Стаття витрат (за 3 роки) Власний сервер (On-Premise у ЦОД України) Хмара (AWS/Azure у Європі, з оптимізацією)
    Капітальні витрати (Сервери, СГД, Мережа) $35,000 (купівля + логістика) $0 (CapEx відсутній)
    Оренда місця у надійному ЦОД (Tier III) $25,000 (~$700/міс за стійку та базове живлення) $0
    Енергонезалежність (Націнки за роботу ДГУ) $4,000 – $6,000 (компенсація за паливо під час блекаутів) $0 (ризики провайдера)
    Амортизація та ЗІП (заміна дисків та БЖ) $3,000 $0
    Ліцензії (ОС, СУБД, Віртуалізація) $25,000+ (особливо з урахуванням нових підписок VMware by Broadcom) Включено у вартість інстансів або PaaS
    ФОП інфраструктурного персоналу $90,000 (1.5 ставки Сисадміна/Мережевика, ~$2500/міс з податками) $54,000 (0.5 ставки DevOps або послуги Managed Service Provider)
    Хмарні ресурси (Compute, Storage, Network) $0 $90,000 (~$2500/міс при купівлі Reserved Instances на 3 роки)
    Ризики фізичного знищення/вилучення Високі (обладнання знаходиться на території України) Нульові (дані в юрисдикції ЄС)
    Підсумкова розрахункова вартість (TCO) ~ $184,000 + постійні ризики ~ $144,000 + абсолютна гнучкість

    Примітка: Цифри орієнтовні. Використання Reserved Instances (резервування інстансів на 3 роки) у хмарі може знизити вартість Compute ресурсів ще на 40-70%.

    Вплив українських реалій на вибір інфраструктури

    Для бізнесу в Україні питання «хмара чи власний сервер» останніми роками набуло зовсім іншого контексту. Класичні розрахунки TCO відійшли на другий план перед обличчям форс-мажорів.

    • Енергетична безпека (Блекаути): Локальні серверні й навіть багато українських ЦОДів зіткнулися з безпрецедентними проблемами забезпечення живлення. Використання генераторів, Starlink, систем EcoFlow та закупівля палива експоненціально збільшили OpEx локальної інфраструктури.
    • Фізична безпека даних: Ризик фізичного знищення серверів або вилучення обладнання змусив практично весь Enterprise і середній сегмент мігрувати в європейські регіони хмарних провайдерів (Frankfurt, Warsaw, Ireland).
    • Дефіцит кадрів: Знайти кваліфікованих інженерів для підтримки складної legacy-інфраструктури в Україні стало складніше. Водночас експертиза в галузі DevOps та Cloud-інженерії залишається на високому рівні, що полегшує управління хмарою.

    Кейс: Як міграція в хмару окупилася за 18 місяців

    Розглянемо реальний сценарій компанії зі сфери FinTech. Історично вони використовували власний кластер серверів для процесингу транзакцій. База даних працювала на потужному фізичному сервері.

    Проблеми почалися, коли знадобилося впровадити мікросервісну архітектуру та оновити Microsoft Exchange з 2010 на 2019 версію. Локальне «залізо» не тягнуло нові середовища для тестування (Side-by-Side запуск на Linux та Windows середовищах), а купівля нових серверів означала CapEx у розмірі $30,000 та очікування поставки обладнання 3 місяці.

    Рішення:

    Компанія прийняла рішення мігрувати в Microsoft Azure.

    1. Монолітні додатки були запаковані в контейнери та перенесені в Azure Kubernetes Service (AKS).
    2. База даних мігрувала в керовану Azure Cosmos DB та Azure SQL.
    3. Розгортання інфраструктури було автоматизовано через Bicep шаблони, що дозволило піднімати тестові середовища за хвилини та знищувати їх після тестів (оплата тільки за години роботи).

    Результат TCO:

    Так, щомісячний рахунок за Azure склав близько $1,000. Однак компанія відмовилася від закупівлі серверів (-$30к), скоротила витрати на ліцензії Windows Server Datacenter і звільнила 2 DBA інженерів, делегувавши їхні завдання автоматиці хмари. Час виведення нових фіч на ринок (Time-to-Market) скоротився з 3 тижнів до 2 днів. TCO хмарної інфраструктури виявився на 35% нижчим за локальну на горизонті трьох років.

    Як правильно порахувати TCO хмари для своєї компанії?

    Щоб не бути голослівним перед керівництвом, виконайте 4 кроки:

    1. Інвентаризація (Assessment): Зберіть точні дані про ваші сервери, CPU, RAM, IOPS дисків та мережевий трафік. Не забудьте інвентаризувати ліцензії.
    2. Оптимізація до розрахунків (Rightsizing): Не рахуйте віртуальні машини 1-в-1. Якщо ваш локальний сервер завантажений на 15%, у хмарі вам потрібен інстанс у 4 рази менший.
    3. Використання калькуляторів: Зайдіть в офіційні інструменти провайдерів — AWS Pricing Calculator, Azure TCO Calculator або Google Cloud Pricing Calculator. Введіть свої дані.
    4. Облік знижок: Обов’язково включіть у розрахунок опції Reserved Instances (RI) або Savings Plans. Зобов’язання використовувати хмару 1 або 3 роки знижує базові тарифи у 2-3 рази!

    FAQ (Часті запитання)

    1. Чи правда, що хмара дешевша лише в перший рік, а потім ціни різко зростають?

    Ні. Вартість хмари зростає лише в одному випадку: якщо росте ваш бізнес і інфраструктура масштабується. Питома вартість обчислювальних потужностей у хмарних провайдерів з часом лише знижується. Ба більше, при грамотному FinOps підході ви зможете постійно оптимізувати ресурси.

    2. Чи захищені наші дані в публічній хмарі краще, ніж на власному сервері?

    Однозначно так. Бюджети Microsoft, Amazon та Google на кібербезпеку обчислюються мільярдами доларів. Вони відповідають найжорсткішим стандартам (ISO, PCI DSS, GDPR). Досягти такого ж рівня ізоляції, шифрування у спокої та в транзиті, контролю доступу та захисту від DDoS-атак у локальній серверній практично неможливо.

    3. Що таке Vendor Lock-in і чи варто його боятися?

    Vendor Lock-in — це прив’язка до конкретного провайдера (наприклад, ви використовуєте пропрієтарні бази даних AWS DynamoDB, і переїхати в Azure буде складно). Щоб уникнути цього, архітектори рекомендують використовувати Cloud-Agnostic технології: контейнеризацію (Docker, Kubernetes), Terraform для інфраструктури та open-source бази даних (PostgreSQL, MySQL), розгорнуті у вигляді керованих сервісів.

    4. Що вибрати для малого бізнесу: On-Premise чи Хмару?

    Для стартапів та малого бізнесу, що росте, відповідь однозначна — хмара. Вона дозволяє не заморожувати капітал у «залізі», швидко тестувати гіпотези та платити лише за реальних користувачів. Власний сервер виправданий лише для специфічних вузьких завдань з величезним вихідним трафіком (наприклад, локальний рендеринг відео або стрімінг всередині корпоративної мережі).

    Висновок: Час приймати рішення

    Вибір «хмара чи власний сервер» у сучасних реаліях — це вже не питання економії кількох сотень доларів на жорстких дисках. Це питання виживання, гнучкості та здатності бізнесу швидко адаптуватися до змін.

    Ретельний розрахунок TCO за 3 роки доводить: коли ви враховуєте вартість простою, зарплати інженерів, приховані витрати на дата-центр, ліцензії та необхідність катастрофостійкості, On-Premise програє хмарним рішенням у переважній більшості бізнес-сценаріїв. Особливо гостро це відчувається в Україні, де незалежність від фізичної локації стала головним критерієм безперервності бізнесу.

    Готові дізнатися реальну вартість міграції вашої IT-інфраструктури в AWS, Azure або GCP?

    Досить гадати на кавовій гущі. Зверніться до сертифікованих Cloud-архітекторів для проведення аудиту вашої системи. Ми допоможемо зібрати дані, зробити детальний розрахунок TCO під ваш проєкт та спланувати безшовну міграцію без простою сервісів.
    Залишити заявку на розрахунок TCO хмари

  • Міграція інтернет-магазину в AWS – від падінь VPS до аптайму 99.9%

    Міграція інтернет-магазину в AWS – від падінь VPS до аптайму 99.9%

    Уявіть ситуацію: запускається довгоочікувана маркетингова кампанія, трафік на сайті виростає у п’ять разів, і рівно в момент пікових продажів сервер перестає відповідати. Кошик висить, база даних лягає під кількістю транзакцій, а бізнес втрачає десятки тисяч доларів на годину. Знайомий біль?

    Для багатьох зростаючих e-commerce проєктів настає момент, коли стара архітектура стає головним гальмом розвитку бізнесу. У цьому матеріалі ми детально розберемо наш кейс міграції в AWS — історію про те, як великий український інтернет-магазин відмовився від орендованих віртуальних серверів. Ми покажемо крок за кроком, чому переїзд у хмару став єдиним правильним рішенням, яку архітектуру ми обрали та як нам вдалося досягти показника доступності 99.9% (SLA) без космічних рахунків за інфраструктуру.міграція в AWS кейс позбавляє downtime

    Вихідні дані: чому VPS більше не справлявся

    Нашим клієнтом виступив ритейлер із топ-20 українського e-commerce сегмента (одяг та аксесуари). До початку проєкту інфраструктура базувалася на двох потужних, але статичних VPS-серверах у локального провайдера.

    Стек технологій до міграції:

    • Frontend/Backend: Монолітний PHP-застосунок (Laravel)
    • База даних: MySQL (на тому ж сервері, що й бекенд)
    • Кешування: Redis (базові налаштування)
    • Медіафайли: Зберігалися локально на дисках сервера

    Головні “болі” IT-відділу та бізнесу

    1. Downtime у періоди розпродажів (Black Friday, Cyber Monday). Вертикальне масштабування (додавання CPU та RAM) потребувало перезавантаження машин і займало години. У моменти піків сервери просто не витримували I/O операцій.
    2. Відсутність відмовостійкості (High Availability). Падіння основного сервера означало повну зупинку бізнесу до ручного відновлення бекапів.
    3. Повільне завантаження статики. Користувачі з інших регіонів та країн скаржилися на довге завантаження фотографій товарів.
    4. Проблеми з безпекою. Відсутність сучасного WAF (Web Application Firewall) робила сайт вразливим до DDoS-атак на рівні застосунку (Layer 7).

    Технічному директору (CTO) стало очевидно: класичний хостинг вичерпав себе. Потрібен був повноцінний переїзд у хмару.

    Цілі проєкту: чого ми хотіли досягти при переїзді у хмару?

    Перед тим як розпочати планування, ми разом із бізнесом зафіксували KPI для нової інфраструктури:

    • Доступність (Uptime): Не нижче 99.9% за підсумками року.
    • Масштабованість: Автоматичне підняття нових інстансів при зростанні CPU > 70% протягом 2-х хвилин.
    • Швидкість роботи (Performance): Час відповіді сервера (TTFB) < 200 мс.
    • Безпека: Захист від ботів, парсерів та DDoS-атак “з коробки”.
    • Оптимізація витрат (FinOps): Інфраструктура має масштабуватися вниз вночі та в періоди спаду активності, щоб не платити за простійні потужності.

    Вибір архітектури: які сервіси AWS ми задіяли

    Успішна міграція у хмару — це не просто перенесення віртуальних машин “один до одного” (підхід Lift-and-Shift). Щоб отримати реальну вигоду від Amazon Web Services, ми використали підхід Re-platforming, адаптувавши архітектуру під cloud-native сервіси.

    1. Обчислювальні потужності (Compute)

    Замість “голих” серверів ми впровадили Auto Scaling Groups (ASG) на базі Amazon EC2. Застосунок був упакований у Docker-контейнери, а оркестрація налаштована через Amazon ECS (Elastic Container Service). Це дозволило нам забути про ручне керування машинами. Трафік між контейнерами розподіляв балансувальник Application Load Balancer (ALB).

    2. База даних (Database)

    Самостійне керування MySQL — це завжди ризики. Ми перевели базу даних на Amazon Aurora (MySQL Compatible).

    • Чому Aurora? Вона автоматично розподіляє дані по трьох зонах доступності (Availability Zones) і забезпечує швидкість I/O до 5 разів вищу, ніж стандартна MySQL. Ми налаштували Read Replicas для зняття навантаження з майстра під час складних пошукових запитів у каталозі.

    3. Зберігання медіа та кешування

    Усі зображення товарів (понад 500 ГБ) переїхали в об’єктне сховище Amazon S3. Для їх швидкої роздачі по всьому світу ми підключили CDN — Amazon CloudFront. Роль Redis взяв на себе повністю керований сервіс Amazon ElastiCache, що зняло з команди DevOps завдання щодо моніторингу оперативної пам’яті кешу.

    4. Безпека та мережа

    Уся інфраструктура була розгорнута всередині ізольованої Amazon VPC (Virtual Private Cloud). Публічний доступ мали лише балансувальники (ALB), а бази даних та application-сервери знаходилися у приватних підмережах. На вході трафік фільтрувався через AWS WAF.

    Покрокова міграція в AWS: кейс у деталях

    Будь-який переїзд у хмару великого бізнесу пов’язаний із ризиком втратити дані або “впустити” сайт у процесі. Ми розбили проєкт на 4 етапи, щоб мінімізувати ризики.

    Етап 1: Інфраструктура як код (Infrastructure as Code)

    Ми категорично відмовилися клікати ресурси руками в консолі AWS. Уся архітектура була описана за допомогою Terraform. Це дало нам колосальну перевагу: ми могли підняти точну копію production-оточення для тестування всього за 15 хвилин, а після тестів — так само швидко її видалити, не переплачуючи за оренду.

    Етап 2: Налаштування CI/CD та контейнеризація

    Щоб розробники клієнта могли деплоїти код кілька разів на день без простоїв (Zero-Downtime Deployment), ми налаштували пайплайни у GitLab CI. Збірка Docker-образів відбувалася автоматично, образи пушилися в Amazon ECR (Elastic Container Registry), після чого ECS плавно оновлював контейнери.

    Етап 3: Підготовка до перенесення даних (Data Migration)

    Найкритичніша частина — перенесення бази даних без зупинки продажів. Ми використали сервіс AWS Database Migration Service (DMS). Спочатку ми зробили повний дамп старої БД на VPS і розгорнули його в Amazon Aurora. Потім AWS DMS підключився до старого сервера в режимі Continuous Data Replication (CDC). Він перехоплював кожну нову транзакцію (купівлю, реєстрацію) на старому сайті та миттєво копіював її у хмару. Таким чином, обидві бази були синхронізовані із затримкою менше секунди.

    Етап 4: Час X — фінальне перемикання

    Фінальний переїзд зайняв всього 15 хвилин глибокої ночі:

    1. Ми перевели старий сайт у режим “Тільки читання” (Read-Only), щоб користувачі не могли створювати нові замовлення в момент перемикання.
    2. Дочекалися, поки AWS DMS допише останні байти даних в Amazon Aurora.
    3. Змінили DNS-записи в Amazon Route 53, спрямувавши весь світовий трафік на новий балансувальник (ALB) в AWS.
    4. Вимкнули режим “Тільки читання”.

    Жодне замовлення не було втрачено. Користувачі навіть не помітили, що магазин “переїхав”.

    Результати: цифри, які говорять самі за себе

    Через 3 місяці після міграції в AWS, ми провели аудит результатів. Переїзд у хмару перевершив очікування бізнесу.

    Метрика До міграції (VPS) Після міграції (AWS) Поліпшення
    Доступність (Uptime) 98.5% (близько 10 годин простою на міс.) 99.99% Простій зведений до нуля
    Час відповіді (TTFB) 600 – 800 мс 120 – 150 мс Прискорення у ~4 рази
    Масштабування Ручне (займало від 2 до 4 годин) Автоматичне (до 2 хв) Вирішена проблема Black Friday
    Швидкість розгортання фіч 1-2 рази на тиждень (вночі) За вимогою (до 10 разів на день) Зростання Time-to-Market

    Найважливіший бізнес-показник: У період найближчого великого розпродажу магазин витримав х10 навантаження від звичайного трафіку. Інфраструктура автоматично розгорнула 15 додаткових контейнерів, впоралася з потоком, а потім згорнулася до базових 3-х контейнерів.

    FinOps: Як ми оптимізували витрати на AWS

    Частий страх IT-директорів: “Хмара — це дорого. Ми розоримося на рахунках від Amazon”. Так, якщо переносити сервери “в лоб”, вартість може зрости. У нашому кейсі міграції ми застосували три стратегії зниження костів:

    1. Rightsizing (Правильний підбір інстансів): Ми відмовилися від купівлі ресурсів “із запасом”. Базове навантаження забезпечувалося мінімальним набором серверів, а решта докуповувалася автоматично лише в міру необхідності.
    2. Reserved Instances & Savings Plans: Проаналізувавши постійне навантаження (бази даних, кеш), ми зарезервували обчислювальні потужності на 1 рік вперед. Це дало знижку до 40% порівняно з оплатою On-Demand (за вимогою).
    3. Використання Spot Instances: Для фонових завдань (обробка відео, генерація важких звітів для бухгалтерії) ми використовували спотові інстанси — вільні потужності AWS, які продаються зі знижкою до 90%.

    У результаті загальна вартість володіння (TCO) хмарною інфраструктурою виявилася на 15% нижчою, ніж підтримка старого парку VPS з урахуванням зарплат адміністраторів на цілодобову підтримку.

    FAQ: Часті питання про переїзд у хмару

    1. Скільки часу займає повноцінна міграція в AWS? Терміни залежать від монолітності застосунку та обсягу даних. У середньому, для великого e-commerce проєкту аудит, підготовка IaC, тестування та сам переїзд займають від 2 до 4 місяців.

    2. Чи безпечно зберігати клієнтські дані у публічній хмарі? Так, якщо архітектура спроєктована правильно. Amazon Web Services відповідає найсуворішим стандартам (PCI DSS, HIPAA, GDPR). Використання приватних підмереж (VPC), шифрування даних у стані спокою (KMS) і в транзиті гарантує безпеку на рівні банківських систем.

    3. Чи потрібен нам постійний штат DevOps після переїзду? Використання керованих сервісів (PaaS/SaaS) на кшталт Amazon RDS, ElastiCache та ECS знімає рутину щодо оновлення ОС та патчингу серверів. Вам буде потрібно менше “рук” для підтримки, а фокус інженерів зміститься на розвиток продукту та CI/CD.

    4. Чи підходить AWS для невеликих стартапів? Безумовно. Головний плюс хмари — модель Pay-as-You-Go (плати тільки за те, що використовуєш). На старті інфраструктура коштуватиме копійки, але при вибуховому зростанні вона не впаде, а легко масштабується слідом за бізнесом.

    Висновок

    Розбираючи цей кейс міграції в AWS, ми бачимо головну тенденцію: сьогодні серверні потужності — це не залізо, це гнучкий інструмент для заробітку. Використання статичних серверів для динамічного бізнесу, такого як e-commerce, подібне до спроби виграти гонку “Формули-1” на тракторі. Ви можете їхати, але на поворотах конкуренти вас обійдуть.

    Перехід на хмарну інфраструктуру дозволив нашому клієнту забути про безсонні ночі під час релізів, повністю позбутися падінь сайту та прискорити завантаження сторінок по всій країні.

    Готові трансформувати свою IT-інфраструктуру? Досить втрачати клієнтів через повільну роботу бази даних і падіння серверів. Довірте аудит і переїзд у хмару професіоналам. Залиште заявку на технічний консалтинг, і ми розрахуємо вартість міграції та потенційну економію для вашого бізнесу вже сьогодні!

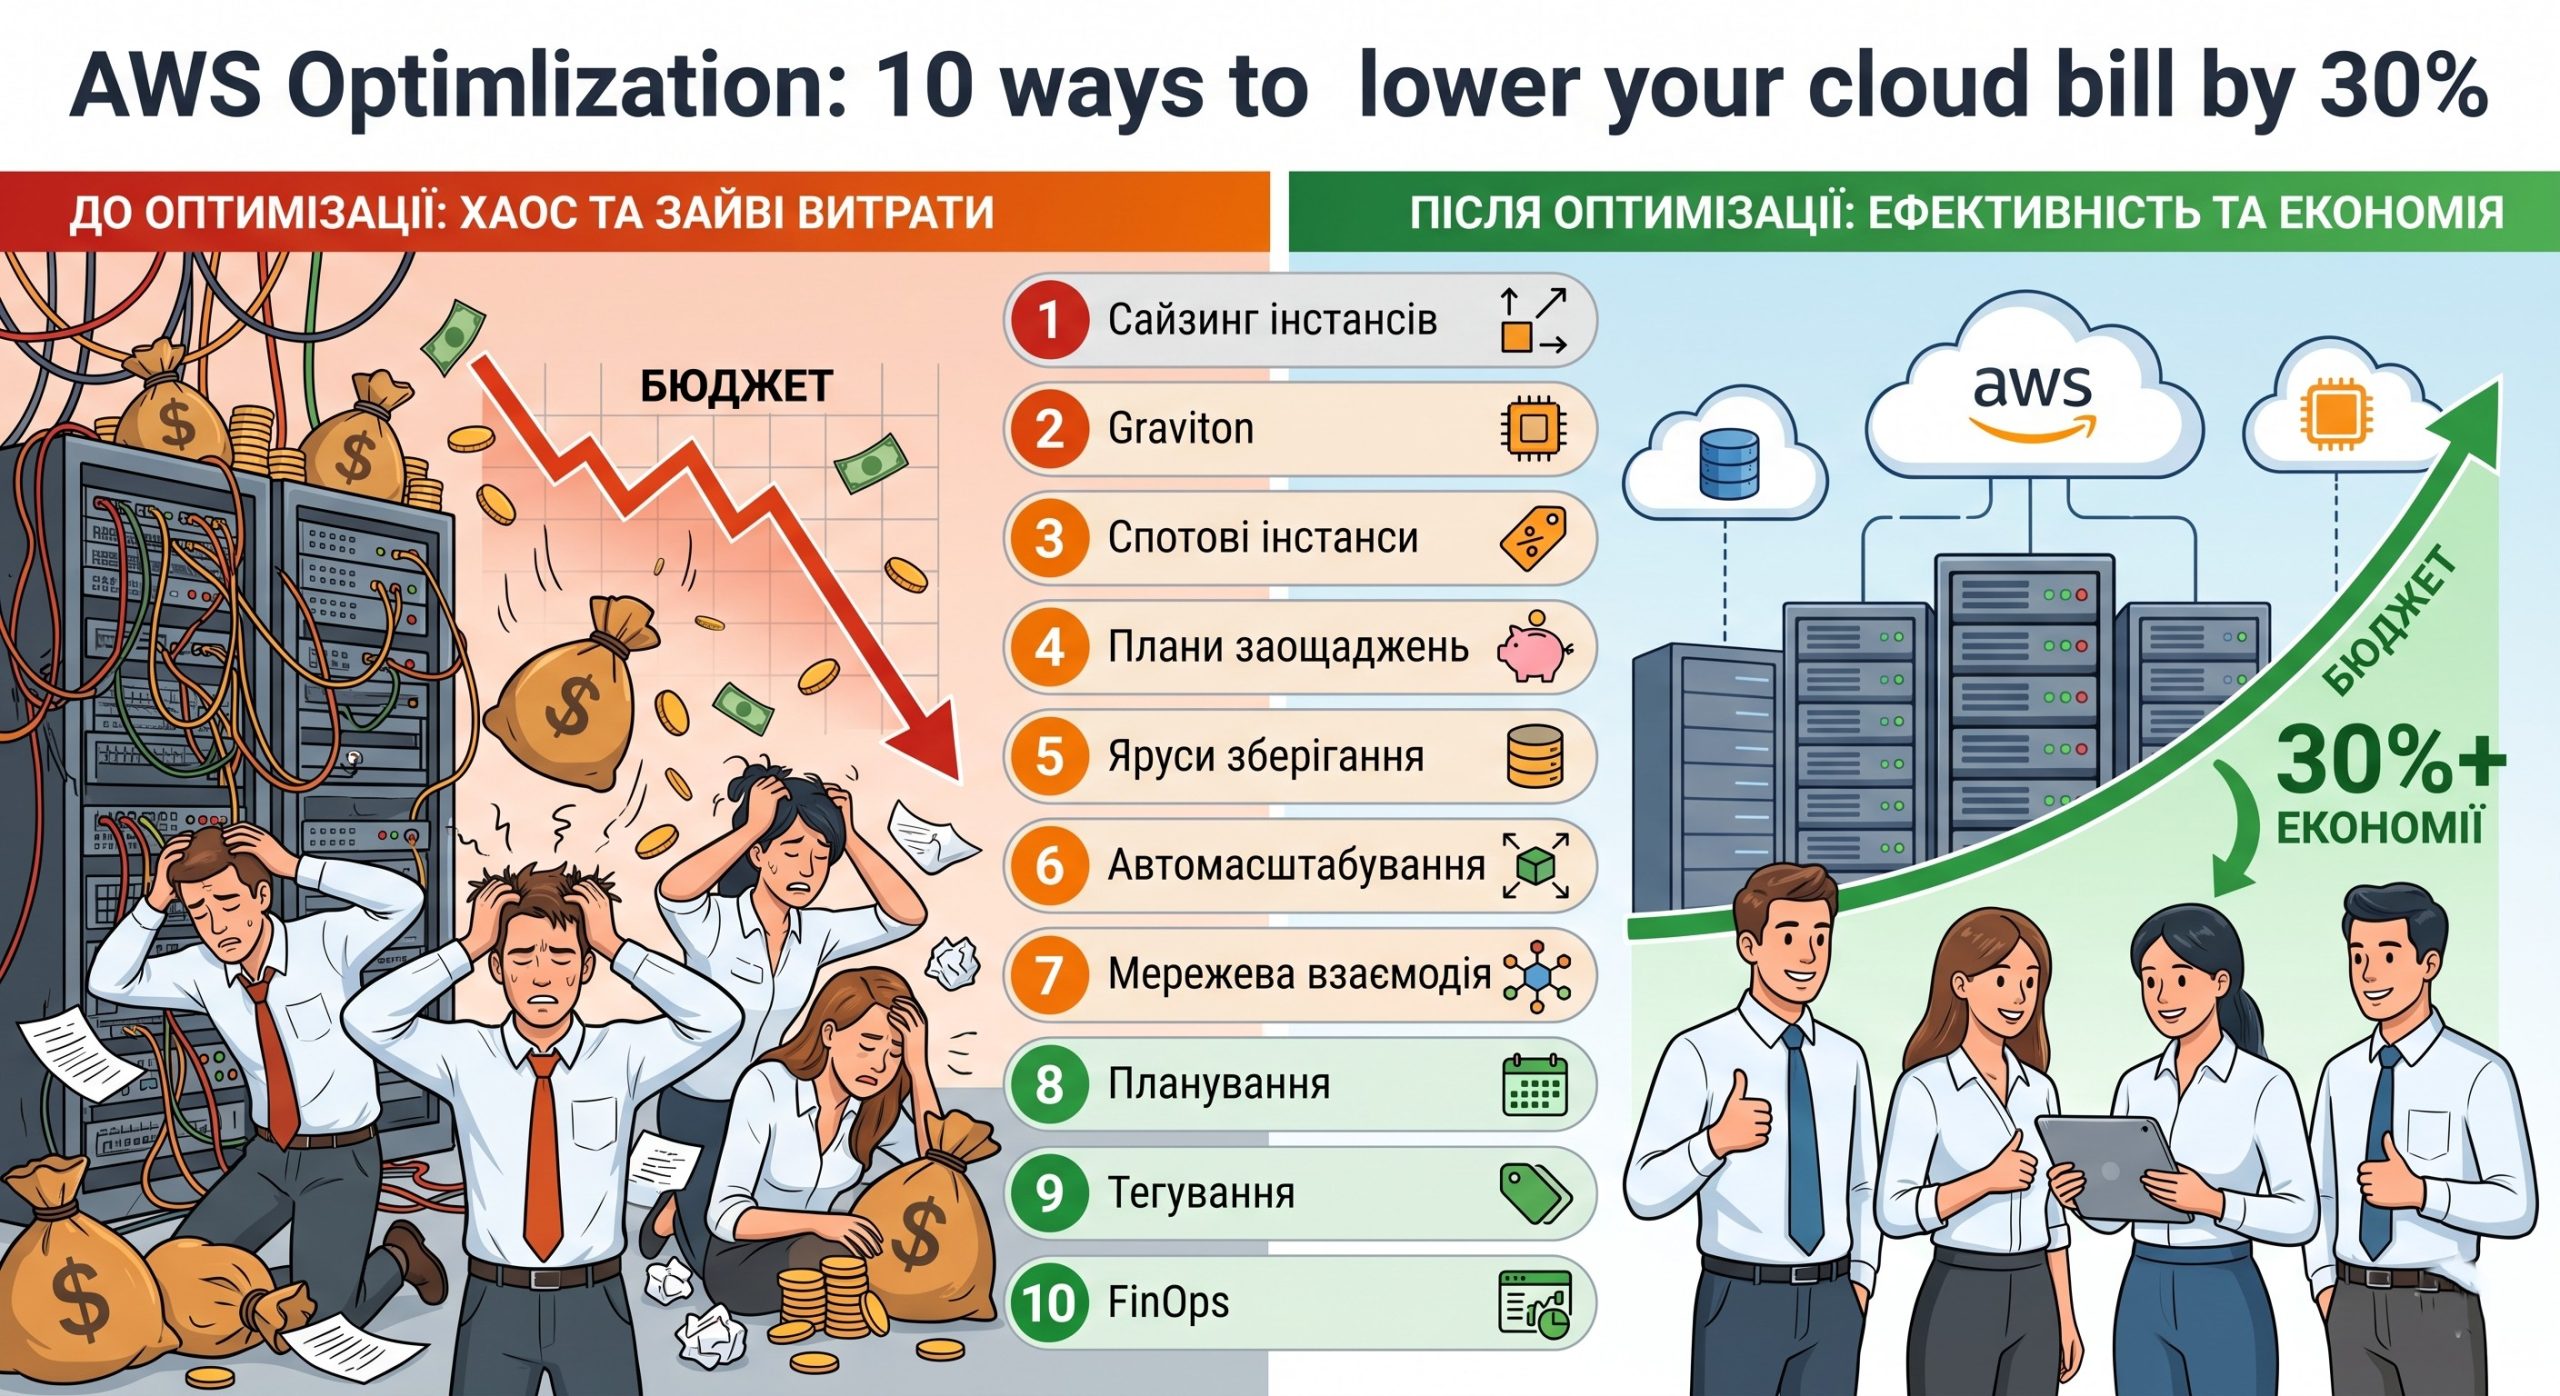
  • Оптимізація вартості AWS: 10 способів знизити рахунок на 30%

    Оптимізація вартості AWS: 10 способів знизити рахунок на 30%

    Масштабування IT-інфраструктури — це завжди баланс між продуктивністю, відмовостійкістю та бюджетом. Для CTO, IT-директорів та керівників інженерних команд хмарні платформи дають неймовірну гнучкість. Але без належного контролю ця гнучкість перетворюється на фінансову чорну діру. Оптимізація AWS — це не разова акція, а системний процес, що дозволяє перенаправити вивільнені бюджети на інновації, а не на оплату серверів, що простоюють.

    Якщо ваша компанія активно зростає або ви тільки завершуєте міграцію, вам необхідно знати, як грамотно знизити вартість хмари. У цій статті ми розберемо 10 глибоко опрацьованих, архітектурних та управлінських методів, які допоможуть скоротити щомісячний рахунок від Amazon Web Services мінімум на 30%, зберігаючи надійність ваших сервісів.Впровадження культури FinOps як стратегія оптимізації витрат на AWS.

    Чому рахунки за AWS виходять з-під контролю?

    Перехід від традиційного DevOps до повноцінного IT-менеджменту потребує зміни парадигми. Інженери часто мислять категоріями аптайму та швидкості деплою, закладаючи надлишкові потужності “про всяк випадок”. Бізнес же мислить категоріями ROI.

    Основні причини перевитрат:

    • Оверпровіжинінг (Overprovisioning): Виділення ресурсів із величезним запасом.
    • “Осиротілі” ресурси (Zombie resources): Забуті EBS-томи, невикористовувані Elastic IP.
    • Помилки архітектури: Неправильний роутинг трафіку (наприклад, через дорогі NAT Gateways замість VPC Endpoints).
    • Ігнорування програм лояльності AWS: Відмова від довгострокового резервування.

    Давайте перейдемо до практичних кроків, які має впровадити кожен технічний лідер.

    1. Практикуйте жорсткий Rightsizing (Підбір оптимального розміру інстансів)

    Rightsizing — це процес аналізу продуктивності обчислювальних ресурсів (EC2, RDS) та баз даних із подальшою зміною їхнього типу або розміру до мінімально необхідного рівня.

    Як показує практика, більшість інстансів у неоптимізованій інфраструктурі утилізують CPU менш ніж на 20%.

    Як реалізувати:

    1. Використовуйте AWS Compute Optimizer. Цей інструмент на базі машинного навчання аналізує метрики CloudWatch за останні 14 днів і рекомендує оптимальні типи інстансів.
    2. Переходьте на сучасні покоління інстансів. Заміна старих m4 на m6i або m7i часто дає приріст продуктивності при зниженні ціни.
    3. Оптимізація баз даних. Бази даних (наприклад, PostgreSQL в Amazon RDS) часто споживають левову частку бюджету. Перевірте метрики: можливо, вам не потрібен db.r5.4xlarge, і з поточними запитами впорається db.m6g.2xlarge.

    2. Модернізація архітектури: Перехід на процесори AWS Graviton

    Один із найелегантніших способів знизити вартість хмари, не змінюючи бізнес-логіку — міграція на ARM-архітектуру. Процесори AWS Graviton (зокрема, Graviton2 та Graviton3) пропонують краще співвідношення ціни та продуктивності.

    Вигода: Інстанси на базі Graviton коштують на 20% дешевше за аналоги на x86 (Intel/AMD), а продуктивність для багатьох робочих навантажень вища до 40%.

    Де застосовувати:

    • Managed-сервіси: Amazon RDS, ElastiCache, OpenSearch. Міграція тут зводиться до зміни типу інстанса та перезавантаження (з мінімальним даунтаймом при Multi-AZ).
    • Контейнеризовані застосунки: Якщо ваші мікросервіси написані на Go, Python, Node.js або Java, збірка multi-arch образів у CI/CD пайплайні дозволить легко запускати їх на Graviton-вузлах в EKS або ECS.

    3. Впровадьте AWS Savings Plans та Reserved Instances (RIs)

    Платити за моделлю On-Demand (за вимогою) для базового, прогнозованого навантаження — це недозволена розкіш для сформованого бізнесу.

    Модель оплати Опис Економія Ідеально для…
    On-Demand Оплата посекундно. Немає зобов’язань. 0% Спайкові, непередбачувані навантаження, R&D.
    EC2 Reserved Instances Бронювання конкретного типу інстанса в конкретній зоні на 1 або 3 роки. До 72% Стабільні бази даних (RDS RIs), legacy-системи.
    Compute Savings Plans Зобов’язання витрачати $X/годину на будь-які обчислювальні потужності (EC2, Fargate, Lambda). До 66% Динамічних команд, що переходять між типами інстансів та регіонами.

    Порада IT-директору: Починайте з Compute Savings Plans. Вони дають максимальну гнучкість. Якщо ваша команда вирішить переїхати з EC2 на serverless-контейнери AWS Fargate, ваша знижка продовжить діяти.

    4. Використовуйте Spot Instances для fault-tolerant навантажень

    Спот-інстанси дозволяють використовувати незатребувані обчислювальні потужності AWS зі знижкою до 90% порівняно з On-Demand. Головний нюанс: AWS може забрати цей інстанс, попередивши вас лише за 2 хвилини (Spot Instance Interruption Notice).

    Найкращі сценарії використання для зниження витрат:

    • CI/CD Pipeline: Раннери GitLab або GitHub Actions ідеально лягають на споти.
    • Big Data & Machine Learning: Обробка черг повідомлень (RabbitMQ, SQS), де зупинка воркера не призводить до втрати даних.
    • Kubernetes (Amazon EKS): Використовуйте змішані Node Groups (On-Demand для критичних компонентів Ingress/Control Plane та Spot для stateless мікросервісів). Налаштуйте AWS Node Termination Handler для graceful shutdown подів.

    5. Оптимізація блочного сховища: Зачистка та міграція EBS

    Рахунки за Elastic Block Store (EBS) часто ігноруються, накопичуючись сніговою грудкою. Оптимізація AWS у розрізі сховища дає швидкі перемоги.

    • Перехід з gp2 на gp3: Це фундаментальне правило. Томи gp3 на 20% дешевші, ніж gp2, і дозволяють налаштовувати IOPS та пропускну здатність незалежно від обсягу. Міграція відбувається на льоту, без даунтайму.
    • Видалення невикористовуваних томів (Unattached Volumes): При видаленні EC2 інстанса EBS том часто залишається жити, якщо не стояла галочка “Delete on Termination”. Налаштуйте скрипт AWS Lambda, який щотижня знаходитиме томи у статусі Available і або видалятиме їх, або робитиме дешевий Snapshot і видалятиме оригінал.
    • Видалення старих Snapshot-ів: Політика зберігання бекапів (Lifecycle Manager) має бути суворо регламентована. Зберігати щоденні снепшоти 3-річної давності — марна трата грошей.

    6. Розумний тиринг в Amazon S3

    Об’єктне сховище S3 здається дешевим ($0.023 за ГБ), але на терабайтних та петабайтних масштабах суми стають суттєвими.

    Для оптимізації витрат увімкніть S3 Intelligent-Tiering. Це клас зберігання, який автоматично переміщує об’єкти між рівнями доступу (Frequent, Infrequent, Archive) на основі патернів використання. Якщо до логів або старих медіафайлів ніхто не звертається 30 днів, AWS сам перенесе їх на дешевший рівень, заощадивши вам до 60% вартості зберігання.

    7. Приховані вбивці бюджету: Оптимізація мережевих витрат (Data Transfer & NAT Gateway)

    Для керівників IT-відділів мережеві рахунки часто стають найбільшим і найнеприємнішим сюрпризом. Передача даних всередині AWS (між зонами доступності) та назовні (в інтернет) тарифікується.

    Як боротися з мережевими витратами:

    • Архітектура NAT Gateways: NAT Gateway тарифікується не тільки за години роботи, а й за кожен гігабайт обробленого трафіку. Якщо ваші приватні інстанси качають терабайти даних з S3 або DynamoDB через NAT, ви втрачаєте гроші.
      • Рішення: Налаштуйте VPC Endpoints (Gateway Endpoints) для S3 та DynamoDB. Трафік піде в обхід NAT безпосередньо через внутрішню мережу AWS — це безкоштовно.
    • Використання CloudFront: Передача даних (Data Transfer Out) безпосередньо з EC2 або S3 в інтернет коштує дорожче, ніж через CDN Amazon CloudFront. Кешуйте статику!

    8. Автоматичне вимкнення невиробничих середовищ (Development / Staging)

    Розробники не пишуть код 24 години на добу 7 днів на тиждень. У середньому, тестові оточення потрібні 40-50 годин на тиждень із 168 можливих. Кластери Dev/QA, що працюють ночами та вихідними, спалюють до 70% своєї вартості марно.

    Впровадьте AWS Instance Scheduler. Це готове рішення від Amazon, яке дозволяє за тегами (наприклад, Environment = Development) автоматично вимикати EC2 та RDS інстанси о 19:00 та вмикати їх о 08:00 по робочих днях.

    9. Налаштування Cost Explorer, бюджетів та виявлення аномалій

    Оптимізація AWS неможлива без прозорої аналітики. IT-директор має бачити структуру витрат у реальному часі.

    1. Tagging Policy (Політика тегування): Впровадьте обов’язкові теги для всіх ресурсів: Project, Environment, Owner, CostCenter. Без цього ви не зрозумієте, який саме мікросервіс чи команда “з’їли” бюджет.
    2. AWS Budgets: Встановіть жорсткі ліміти. Налаштуйте алерти (через SNS або інтеграцію зі Slack) при досягненні 80% від запланованого бюджету.
    3. AWS Cost Anomaly Detection: Увімкніть цей безкоштовний сервіс на базі ML. Якщо розробник випадково запустить цикл, який генерує терабайти логів у CloudWatch, система виявить аномальний сплеск витрат і надішле сповіщення не наприкінці місяця, а протягом кількох годин.

    10. Впровадження культури FinOps

    Інструменти марні без правильних процесів. Як керівник, що вибудовує довгострокову IT-стратегію, ви повинні інтегрувати управління витратами в ДНК вашої інженерної культури. Це суть методології FinOps (Financial Operations).

    У класичному DevOps фокус зміщений на швидкість та стабільність. У FinOps — вартість ресурсу стає такою ж важливою метрикою якості системи, як Latency або Error Rate.

    Кроки для керівництва:

    • Регулярно проводьте рев’ю архітектури спільно з лідами команд (Well-Architected Framework Reviews, секція Cost Optimization).
    • Дайте розробникам видимість їхніх витрат. Коли команда розуміє, скільки коштує в грошах їхній неоптимальний SQL-запит, що потребує величезної бази даних, код починає переписуватися набагато швидше.

    Блок FAQ (Часті запитання)

    Як швидко можна побачити результат від оптимізації AWS?

    Деякі дії дають миттєвий результат. Переказ EBS томів з gp2 на gp3, очищення осиротілих ресурсів та налаштування Instance Scheduler для тестових середовищ скоротять рахунок вже в поточному місяці. Більш глибокі архітектурні зміни (перехід на Graviton або Spot-інстанси) можуть зайняти від кількох тижнів до місяців.

    Чи варто відразу купувати Savings Plans для стартапу?

    Якщо ваш продукт знаходиться на стадії MVP і навантаження непередбачуване — ні. Використовуйте On-Demand. Але як тільки ви намацали стабільну базову лінію (baseline) споживання (наприклад, ви точно знаєте, що 2 бази даних і 5 воркерів працюватимуть 24/7 у найближчий рік), резервування цієї “бази” за допомогою Compute Savings Plans обов’язкове.

    Чи потрібно наймати окремого FinOps-інженера?

    Для компаній із хмарними витратами до $10,000–$15,000 на місяць виділений спеціаліст зазвичай не окупається; цю роль має брати на себе Технічний лід або IT-директор спільно з DevOps-командою. При рахунках від $50,000/міс компетенція FinOps стає критично необхідною інвестицією.

    Чому рахунок за мережу (Data Transfer) такий великий і як його перевірити?

    AWS не бере гроші за вхідний трафік, але тарифікує вихідний (Outbound) та міжзональний. Використовуйте AWS Cost and Usage Report (CUR) разом з Amazon Athena, щоб проаналізувати трафік побайтово. Найчастіше проблема криється в “спілкуванні” мікросервісів з різних Availability Zones або неправильному кешуванні статики без CDN.

    Висновок

    Знизити вартість хмари на 30% — це не магія, а результат системного IT-менеджменту та інженерної дисципліни. Оптимізація AWS починається з наведення базового порядку (видалення сміття, rightsizing, апгрейд EBS), продовжується фінансовими інструментами (Savings Plans) і закріплюється архітектурними рішеннями (Serverless, Spot-інстанси, Graviton).

    Ваші хмарні рахунки продовжують зростати непропорційно доходам бізнесу? Не чекайте наступного інвойсу. Делегуйте технічний аудит експертам. Наша команда допоможе провести глибокий аналіз вашої інфраструктури, виявити витоки бюджету та впровадити практики FinOps. Зв’яжіться з нами сьогодні для попередньої оцінки вашої інфраструктури в AWS!

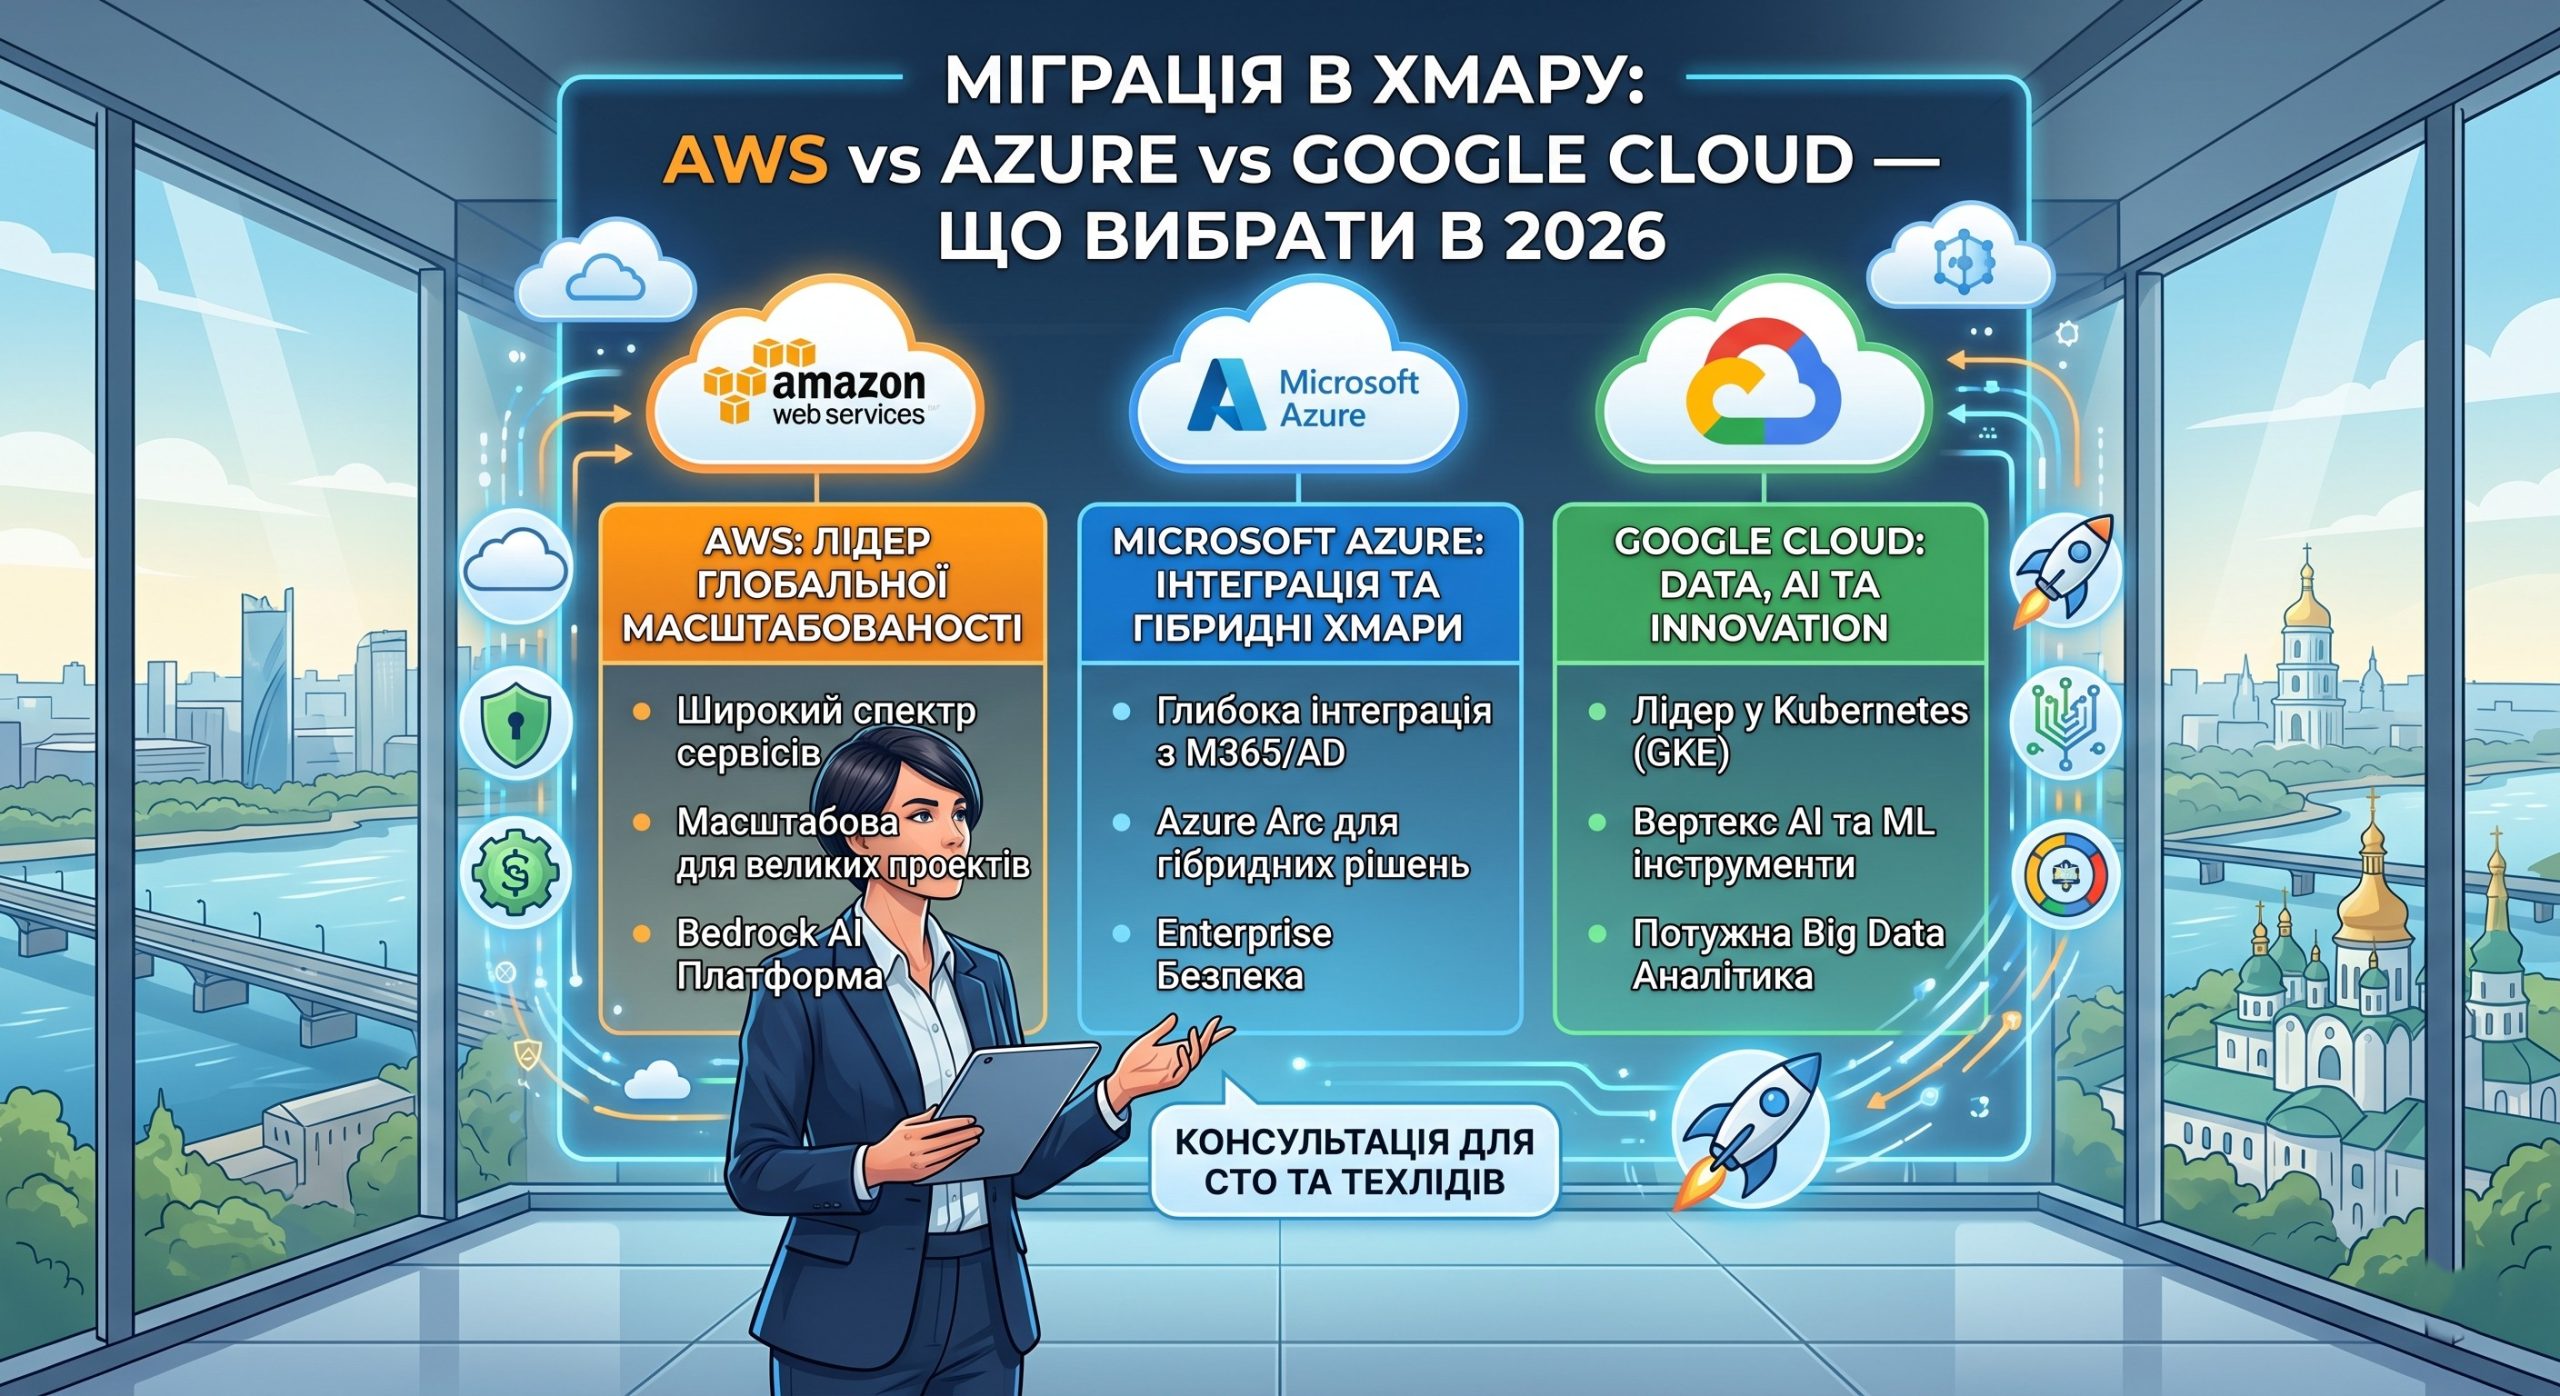
  • Міграція в хмару: AWS vs Azure vs Google Cloud – що вибрати в 2026

    Міграція в хмару: AWS vs Azure vs Google Cloud – що вибрати в 2026

    У 2026 році питання «чи потрібно переходити в хмару?» остаточно змінилося питанням «як зробити це максимально ефективно?». Для сучасного бізнесу в Україні, особливо в умовах необхідності високої відмовостійкості та інтеграції в європейський ринок, вибір провайдера стає стратегічним рішенням. Міграція в хмару — це не просто зміна серверів, це зміна парадигми управління даними, витратами та безпекою.

    Якщо ви стоїте перед дилемою — AWS чи Azure, або, можливо, Google Cloud (GCP) — цей матеріал допоможе вам прийняти зважене рішення на основі актуальних даних 2026 року.Міграція в хмару: AWS vs Azure vs Google Cloud - що вибрати в 2026

    1. Поточний ландшафт хмарних технологій 2026

    Ринок хмарних обчислень у 2026 році характеризується трьома мегатрендами:

    1. AI-First Інфраструктура: Хмари тепер оцінюються за якістю їхніх LLM-сервісів та потужністю GPU.
    2. FinOps 2.0: Управління витратами стало автоматизованим, але складнішим через динамічне ціноутворення.
    3. Суверенні хмари: Для українських компаній критично важливою є локація дата-центрів у Європі (Варшава, Франкфурт) для мінімізації затримок та дотримання GDPR.

    Чому вибір хмари такий важливий саме зараз?

    Помилка у виборі провайдера на старті може призвести до «vendor lock-in» — залежності від екосистеми, вихід з якої через пару років коштуватиме у 3-5 разів дорожче за саму міграцію.

    2. Порівняння титанів: AWS, Azure та Google Cloud

    Amazon Web Services (AWS) — Масштабованість та досвід

    AWS залишається лідером ринку з найширшим набором сервісів (понад 250). У 2026 році їхній фокус зміщений на Amazon Bedrock та кастомні чипи Trainium для навчання нейромереж.

    • Плюси: Неймовірна гнучкість, зріла екосистема, величезна спільнота інженерів в Україні.
    • Мінуси: Складна система ціноутворення (можна легко вийти за межі бюджету), інтерфейс консолі часто здається перевантаженим.
    • Кому підходить: Великим ентерпрайз-проєктам зі складною мікросервісною архітектурою та стартапам, яким потрібен швидкий доступ до інновацій.

    Microsoft Azure — Вибір корпорацій та .NET спільноти

    Якщо ваш бізнес щільно сидить на продуктах Microsoft (Active Directory, SQL Server, Office 365), Azure — ваш природний вибір.

    • Плюси: Безшовна інтеграція з Windows-екосистемою, найкращі гібридні рішення (Azure Stack), ексклюзивний доступ до новітніх моделей OpenAI.
    • Мінуси: Іноді спостерігається відставання у продуктивності Linux-інстансів порівняно з AWS.
    • Кому підходить: Середньому та великому бізнесу, який цінує безпеку, звичне середовище управління та планує будувати гібридну інфраструктуру.

    Google Cloud Platform (GCP) — Дані та Kubernetes

    GCP у 2026 році — це «розумна» хмара. Вони історично сильні в аналітиці даних та контейнеризації (нагадаємо, що Kubernetes народився в Google).

    • Плюси: Найкраща в класі підтримка K8s (GKE), потужні інструменти BigQuery та Vertex AI, найінтуїтивніша мережа (Global VPC).
    • Мінуси: Менша кількість сервісів порівняно з AWS, менше сертифікованих фахівців на ринку праці.
    • Кому підходить: Data-driven компаніям, розробникам мобільних застосунків та всім, чия робота зав’язана на високонавантажених кластерах Kubernetes.

    3. Технічне порівняння сервісів (Таблиця 2026)

    Параметр AWS Microsoft Azure Google Cloud
    Обчислення EC2, Lambda, Fargate Virtual Machines, Functions Compute Engine, Cloud Run
    Сховище S3, EBS, Glacier Blob Storage, Disk Storage Cloud Storage, Filestore
    Бази даних RDS, Aurora, DynamoDB Azure SQL, Cosmos DB Cloud SQL, Spanner
    Контейнери EKS, ECS AKS GKE (Gold Standard)
    AI/ML SageMaker, Bedrock Azure OpenAI Service Vertex AI
    Регіони (ЄС) 8+ регіонів (вкл. Польщу) 10+ регіонів (вкл. Польщу) 7+ регіонів

    4. Специфіка для України: Зв’язок, Швидкість, Закони

    При виборі хмари для українського бізнесу у 2026 році потрібно враховувати три фактори:

    1. Latency (Затримка): Найнижчі затримки з Києва зазвичай спостерігаються до дата-центрів у Варшаві (Azure) та Франкфурті (AWS/GCP). У 2026 році Azure розширив присутність у Східній Європі, що робить його фаворитом за пігом.
    2. Захист даних: Україна активно гармонізує законодавство з ЄС. Використання європейських регіонів (EU regions) гарантує відповідність GDPR, що критично для аутсорсингових компаній та фінтеху.
    3. Гібридні рішення: Враховуючи ризики для фізичної інфраструктури, багато компаній в Україні використовують хмару як гарячий резерв (DR Site) для своїх наземних серверів.

    5. Економіка міграції: Як не розоритися?

    Міграція в хмару часто лякає прихованими платежами. У 2026 році важливо стежити за:

    • Egress Traffic (Вихідний трафік): Вартість виводу даних із хмари може складати до 20% рахунку. GCP часто пропонує вигідніші умови для міжрегіонального трафіку.
    • Spot-інстанси: Використання невикористаних потужностей AWS може заощадити до 90% вартості обчислень.
    • Reserved Instances (RI) / Savings Plans: Зобов’язання використовувати потужності на 1-3 роки вперед знижує ціну вдвічі.

    Порада експерта: Починайте з аудиту. Якщо у вас багато Windows-ліцензій, Azure Hybrid Benefit дозволить заощадити до 40% за рахунок їхнього перенесення в хмару.

    6. Стратегії міграції (The 7 R’s)

    Процес перенесення інфраструктури у 2026 році зазвичай слідує одній із методологій:

    1. Rehost (Lift-and-Shift): Перенесення «як є». Швидко, але не використовує переваги хмари.
    2. Replatform: Невеликі зміни (наприклад, перенесення SQL-сервера в керований сервіс RDS або Azure SQL).
    3. Refactor: Переписування коду під хмарні нативні архітектури (Serverless, Microservices). Дорого, але максимально ефективно в довгостроковій перспективі.

    7. Безпека у 2026: Shared Responsibility Model

    Важливо пам’ятати: хмара забезпечує безпеку інфраструктури, але за безпеку даних всередині відповідаєте ви.

    • AWS Shield — найкращий захист від DDoS.
    • Azure Sentinel — потужний хмарний SIEM на базі AI.
    • Google IAM — еталон управління доступом.

    Висновок: Що ж обрати у 2026 році?

    Універсальної відповіді не існує, але є чіткі маркери:

    • Обирайте AWS, якщо вам потрібна максимальна екосистема, ви розробляєте складний продукт «з нуля» і вам важлива перевірена часом надійність.
    • Обирайте Azure, якщо ваш стек — .NET/C#, ви активно використовуєте продукти Microsoft і шукаєте найкраще рішення для корпоративного сектору в Україні.
    • Обирайте Google Cloud, якщо ваша компанія сфокусована на Big Data, аналітиці, машинному навчанні або якщо ви хочете найкращий досвід роботи з Kubernetes.

    Міграція в хмару — це марафон, а не спринт. Почніть з невеликого PoC (Proof of Concept) і оберіть того провайдера, чия консоль та модель витрат здадуться вашій команді найпрозорішими.

    FAQ

    Яка хмара дешевша у 2026 році?

    У середньому ціни вирівнялися. AWS вигідніший при використанні Reserved Instances, GCP — при довгостроковому навантаженні без передоплати (Sustained Use Discounts).

    Чи можна використовувати кілька хмар одночасно?

    Так, стратегія Multi-cloud популярна у 2026 році для підвищення відмовостійкості, але вона вимагає високого рівня DevOps-експертизи.

    Чи допомагає хмара при відключеннях електрики в Україні?

    Так, перенесення сервісів у європейські дата-центри гарантує їхню доступність для ваших клієнтів, незалежно від ситуації з локальною інфраструктурою.

    Готові до масштабування?

    Не дозволяйте старій інфраструктурі гальмувати ваш ріст. Розберемо ваш кейс: оберемо оптимальний стек, визначимо ризики та складемо покроковий план переходу в хмару 2026 року.

    [Отримати консультацію]

  • Чек-лист безпеки сервера: 15 пунктів, які потрібно перевірити зараз

    Чек-лист безпеки сервера: 15 пунктів, які потрібно перевірити зараз

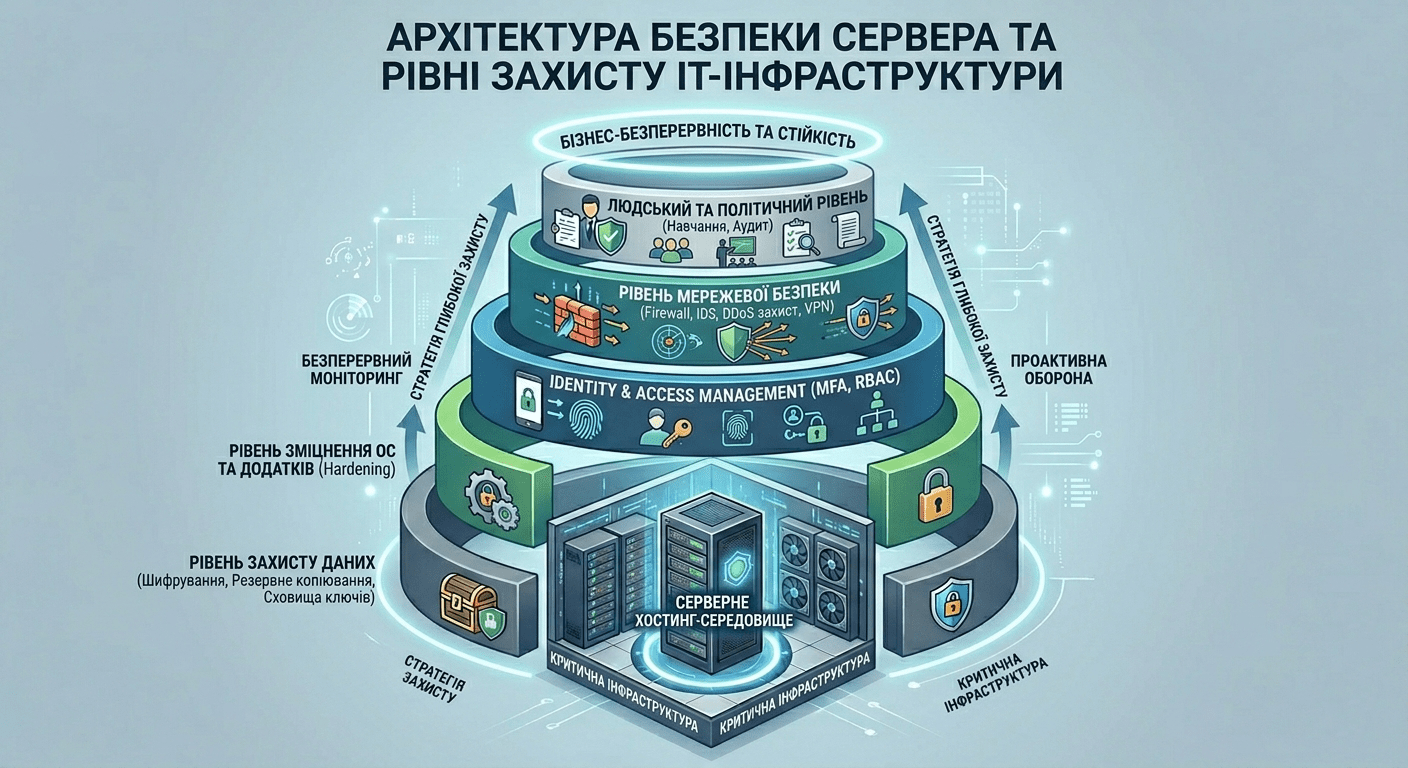
    Безпека ІТ-інфраструктури в сучасних реаліях — це не «налаштування один раз», а безперервний процес управління ризиками. Для CTO та технічних лідів компаній, що працюють на ринку України та за кордоном, ціна помилки вимірюється не лише простоєм, а й втратою репутаційного капіталу. Цей чек-ліст безпеки сервера складений на основі практичного досвіду міграцій в Azure/AWS та аудиту високонавантажених систем. Ми розберемо 15 етапів, які дозволять провести комплексний аудит сервера та закрити вразливості до того, як ними скористаються зловмисники.Архітектура безпеки сервера та шари захисту ІТ-інфраструктури

    Чому стандартних налаштувань «із коробки» більше недостатньо?

    Більшість інцидентів ІБ у середньому та великому бізнесі стаються не через надскладні атаки, а через банальні помилки конфігурації. Залишений відкритим порт бази даних, використання стандартного порту SSH або відсутність ротації ключів — це запрошення для ботнетів. Згідно зі статистикою за 2025 рік, автоматизовані сканери знаходять незахищений сервер у мережі в середньому за 15–20 хвилин після його появи онлайн.

    Чек-ліст безпеки сервера: 15 етапів глибокого аудиту

    1. Управління доступом та SSH (Hardening)

    Перша лінія оборони — обмеження шляхів входу.

    • Відключення Root-логіну: Прямий доступ під суперкористувачем — критична вразливість. Використовуйте sudo для виконання адміністративних завдань.
    • Аутентифікація за ключами (SSH Keys): Паролі вразливі до брутфорс-атак. SSH-ключі з алгоритмом Ed25519 забезпечують значно вищий рівень захисту.
    • Зміна стандартного порту: Перенесення SSH з порту 22 на нестандартний (наприклад, у діапазоні 40000–50000) знижує обсяг «шумових» атак від ботів на 90%.

    2. Політика мінімальних привілеїв (PoLP)

    Кожен сервіс або співробітник повинен мати доступ лише до тих ресурсів, які необхідні для виконання конкретного завдання.

    • Ізоляція сервісів: Запуск вебсервера (Nginx/Apache) або бази даних під виділеними системними користувачами з обмеженими правами.
    • Контроль sudoers: Регулярний аудит файлу /etc/sudoers на предмет наявності зайвих акаунтів.

    3. Налаштування міжмережевого екрана (Firewall)

    Правило «заборонено все, що не дозволено явно» має бути фундаментальним.

    • UFW/IPTables/Firewalld: Налаштуйте фільтрацію вхідного трафіку.
    • Білі списки (Whitelisting): Для адміністративних панелей та портів управління доступ має бути відкритий лише для конкретних IP-адрес компанії або через VPN.

    4. Регулярне оновлення ПЗ та Patch Management

    Вразливості нульового дня (0-day) — реальність.

    • Автоматичні оновлення безпеки: В Ubuntu/Debian використовуйте unattended-upgrades.
    • Аудит залежностей: Перевірка бібліотек (особливо в Docker-контейнерах) на наявність відомих CVE.

    5. Безпека на рівні ОС (Hardening ядра)

    Для високонавантажених систем важливо обмежити можливості експлуатації ядра.

    • SELinux або AppArmor: Використовуйте системи примусового контролю доступу (MAC). Вони запобігають поширенню атаки, навіть якщо сервіс був зламаний.
    • Обмеження доступу до /proc та /sys: Запобігання збору інформації про систему непривілейованими користувачами.

    6. Захист мережевого рівня та DDoS-захист

    Для компаній в Україні актуальний захист від транскордонних атак.

    • Fail2Ban: Автоматичне блокування IP-адрес після кількох невдалих спроб авторизації.
    • Використання CDN: Cloudflare або AWS Shield для поглинання L7-атак на вебдодатки.

    7. Аудит та логування (SIEM/Logging)

    Ви не можете захистити те, чого не бачите.

    • Централізований збір логів: Налаштуйте передачу системних логів та логів додатків в ELK Stack (Elasticsearch, Logstash, Kibana) або Graylog.
    • Auditd: Використовуйте демон аудиту для відстеження змін у критичних файлах конфігурації.

    8. Шифрування даних (Data-at-Rest & In-Transit)

    • TLS 1.3: Відмова від застарілих протоколів SSL та TLS 1.0/1.1.
    • HSTS: Примусове використання HTTPS для всіх з’єднань.
    • Шифрування дисків: Використання LUKS або хмарних інструментів шифрування (Azure Disk Encryption) для захисту фізичних даних.

    9. Резервне копіювання та Disaster Recovery (DRP)

    Бекап — це остання лінія захисту від програм-вимагачів (Ransomware).

    Параметр Вимога
    Гео-розподіл Зберігання копій в іншому регіоні (наприклад, Київ -> Франкфурт)
    Immutable Backups Незмінні бекапи, які не можна видалити навіть з правами адміна
    Тестування Перевірка відновлення даних не рідше разу на місяць

    10. Безпека контейнеризації (Docker/Kubernetes)

    Якщо ви використовуєте мікросервіси, фокус зміщується на runtime-безпеку.

    • Запуск без Root: Контейнери ніколи не повинні працювати від імені суперкористувача хоста.
    • Read-only File System: Налаштування контейнерів на роботу з файловою системою «тільки для читання» там, де це можливо.

    11. Управління секретами

    Ніколи не зберігайте паролі, токени API та ключі в коді (Hardcoding) або .env файлах у Git.

    • Vault-рішення: Використовуйте HashiCorp Vault, AWS Secrets Manager або Azure Key Vault.

    12. Сканування на вразливості (Vulnerability Scanning)

    Автоматизований аудит сервера має бути частиною вашого CI/CD процесу.

    • Інструменти: OpenVAS, Nessus або хмарні сканери (Azure Defender). Перевіряйте систему на наявність відкритих портів та застарілих пакетів щотижня.

    13. Захист баз даних

    База даних — головна мета зловмисника.

    • Слухайте тільки localhost: За замовчуванням БД не має бути доступна ззовні.
    • Розподіл прав: Додаток повинен мати права тільки на DML операції (SELECT, INSERT, UPDATE), але не на DDL (DROP, ALTER).

    14. Моніторинг цілісності файлів (FIM)

    • AIDE / Tripwire: Ці інструменти створюють базу контрольних сум системних файлів і сповіщають про будь-які несанкціоновані зміни.

    15. Людський фактор та 2FA

    Навіть найбільш захищена інфраструктура падає через фішинг.

    • Двофакторна аутентифікація (MFA): Обов’язкова для всіх панелей управління (Cloud Console, VPN, SSH).

    FAQ: Часті запитання щодо безпеки серверів

    1. Як часто потрібно проводити повний аудит сервера?

    Мінімум раз на квартал. Однак автоматизоване сканування на наявність CVE має відбуватися щодня при збірці образів або оновленні системи.

    2. Чи допоможе хмарний провайдер (Azure/AWS) захистити мій сервер повністю?

    Ні. Існує модель розділеної відповідальності (Shared Responsibility Model). Провайдер захищає «хмару» (фізичні сервери, мережу), а ви відповідаєте за безпеку «всередині хмари» (ОС, додатки, дані).

    3. Чи варто використовувати безкоштовні антивіруси для Linux-серверів?

    Для серверів важливіші системи виявлення вторгнень (IDS/IPS) та Hardening, ніж класичний антивірус. Але ClamAV може бути корисним для перевірки користувацького контенту.

    4. Чи потрібно закривати ICMP (ping)?

    Це не панацея, але приховування сервера від простих сканерів “ping-sweeps” може трохи знизити видимість для примітивних ботів.

    Висновок

    Безпека — це не статичний стан, а динамічний процес. Впровадження цього чек-ліста дозволить вам значно знизити ймовірність успішної атаки та мінімізувати збитки у разі інциденту.

    Якщо ви відчуваєте, що ваша інфраструктура потребує професійного погляду зі сторони, або ви плануєте безпечну міграцію в хмару — наша команда готова провести глибокий аудит та налаштувати захист «під ключ». Не чекайте інциденту, щоб почати діяти.

    [Зв’язатися з експертом з безпеки]

  • Моніторинг серверів 24/7: навіщо він потрібний і як працює

    Моніторинг серверів 24/7: навіщо він потрібний і як працює

    В умовах сучасної цифрової економіки, де кожна хвилина простою сайту або корпоративного додатка конвертується в тисячі доларів збитків та втрату репутації, моніторинг серверів перестає бути просто “технічним завданням”. Сьогодні це стратегічна необхідність. Якщо ваша інфраструктура недоступна, для клієнта вашого бізнесу просто не існує.

    Для CTO, IT-директорів та власників компаній в Україні, що зростають, питання стабільності стоїть особливо гостро. Враховуючи міграцію в хмари (Azure, AWS, GCP) та гібридні моделі роботи, 24/7 підтримка серверів стає фундаментом, на якому будується довіра користувачів.

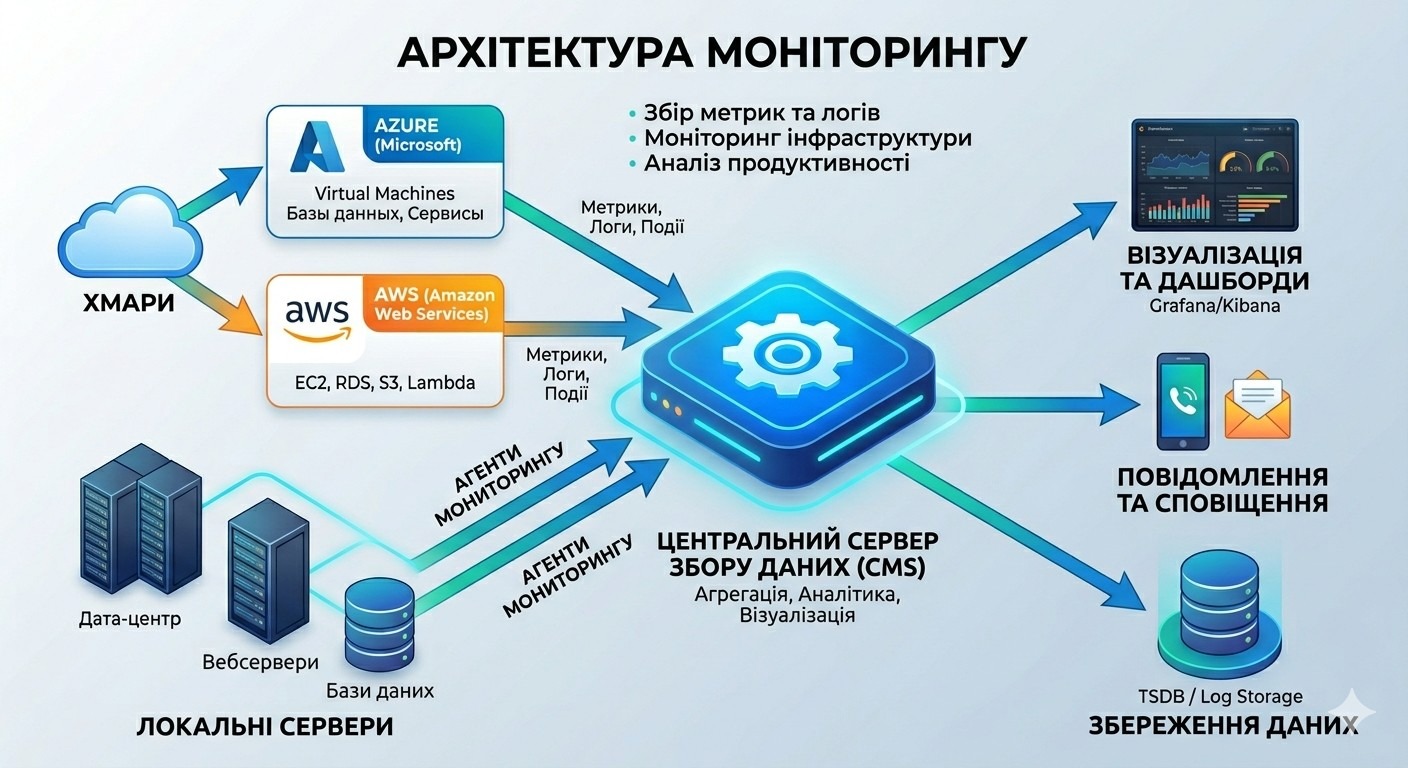
    У цій статті ми глибоко розберемо, як працює сучасний моніторинг, які метрики є критичними для бізнесу та як побудувати систему, яка попереджає проблему до того, як її помітить клієнт.Схема роботи цілодобового моніторингу серверів 24/7 для бізнесу.

    Що таке моніторинг серверів і чому «перевірки раз на годину» більше не працюють

    Моніторинг серверів — це процес безперервного збору, аналізу та візуалізації даних про стан апаратного та програмного забезпечення. Це “пульс” вашої IT-системи.

    Раніше системним адміністраторам було достатньо періодично перевіряти доступність сервера за допомогою PING. У 2026 році цього катастрофічно замало. Сучасний додаток — це складна екосистема мікросервісів, баз даних та зовнішніх API. Якщо сервер “пінгується”, це не означає, що користувачі можуть здійснити покупку.

    Чому 24/7 — це стандарт, а не розкіш?

    1. Глобалізація: Ваші клієнти можуть перебувати в різних часових поясах.
    2. Складність інфраструктури: Контейнеризація (Kubernetes/AKS) вимагає миттєвої реакції на падіння подів.
    3. Безпека: Підозрілі сплески трафіку вночі можуть бути ознакою початку DDoS-атаки або спроби зламу.

    Навіщо бізнесу потрібен цілодобовий моніторинг: 5 ключових причин

    1. Мінімізація збитків від простоїв (Downtime)

    Згідно з дослідженнями Gartner, середня вартість години простою ІТ-систем для великого бізнесу становить близько $300,000. Для середнього бізнесу в Україні цифри скромніші, але не менш болючі. Цілодобовий моніторинг дозволяє скоротити час реакції (MTTR — Mean Time To Recovery) з годин до хвилин.

    2. Дотримання SLA (Service Level Agreement)

    Якщо ви надаєте послуги іншим компаніям, у вашому контракті напевно прописаний аптайм (наприклад, 99.9%). Без системи контролю 24/7 ви не зможете гарантувати виконання цих зобов’язань і ризикуєте отримати штрафні санкції.

    3. Оптимізація ресурсів та планування бюджету

    Моніторинг показує не лише помилки, а й навантаження. Ви бачите, коли процесор завантажений на 90%, а коли пам’ять простоює. Це дозволяє вчасно проводити масштабування (наприклад, в Azure або AWS) і не переплачувати за потужності, що не використовуються.

    4. Раннє виявлення аномалій

    Багато проблем мають накопичувальний ефект. Витік пам’яті в додатку на Java або Python не обвалить сервер миттєво. Але моніторинг зафіксує плавне зростання споживання ресурсів і надішле повідомлення до того, як станеться “OOM Killer” (Out Of Memory).

    5. Безпека та комплаєнс

    Постійний аудит логів та мережевої активності допомагає виявити несанкціонований доступ. У контексті українського законодавства та вимог GDPR, захист персональних даних неможливий без контролю доступу до серверів у реальному часі.

    Як працює моніторинг серверів: рівні та метрики

    Ефективна система будується за принципом багатошарового пирога. Не можна дивитися тільки на “залізо”, ігноруючи бізнес-логіку.

    Рівень 1: Інфраструктурний моніторинг

    Тут ми стежимо за базовими показниками:

    • CPU Load (Завантаження процесора): Чи є черги на обробку завдань?
    • RAM (Оперативна пам’ять): Наскільки близька межа?
    • Disk I/O та вільне місце: Забитий логами диск — найчастіша причина падіння баз даних.
    • Network Traffic: Вхідний та вихідний трафік, затримки (latency).

    Рівень 2: Мониторинг сервісів та БД

    На цьому етапі перевіряється працездатність конкретних інструментів:

    • Web-сервери (Nginx, Apache): Кількість активних з’єднань, час відповіді.
    • Бази даних (PostgreSQL, SQL Server, Cosmos DB): Тривалість транзакцій, кількість заблокованих процесів.
    • Черги (RabbitMQ, Redis): Довжина черги та швидкість обробки повідомлень.

    Рівень 3: Application Performance Monitoring (APM)

    Це найглибший рівень. Ми аналізуємо, як швидко виконується код самого додатка, які запити до БД найповільніші та на яких етапах користувач стикається з помилками 500.

    Золоті сигнали моніторингу (Google SRE)

    Якщо ви не знаєте, з чого почати, зосередьтеся на чотирьох “золотих сигналах”:

    Сигнал Опис Чому це важливо
    Latency (Затримка) Час, необхідний для обслуговування запиту. Зростання затримки — перша ознака деградації сервісу.
    Traffic (Трафік) Попит на систему (HTTP запити/сек). Допомагає зрозуміти навантаження та відрізнити реальних користувачів від ботів.
    Errors (Помилки) Частота запитів, які завершилися невдачею. Дозволяє миттєво побачити баги після деплою.
    Saturation (Насиченість) Наскільки “повна” ваша система. Показує, скільки ресурсів залишилося до критичної точки.

    Інструментарій для 24/7 підтримки серверів у 2026 році

    Ринок пропонує десятки рішень. Вибір залежить від масштабу вашого проекту та бюджету.

    1. Open Source рішення (Self-hosted)

    • Zabbix: Універсальний комбайн. Чудово підходить для моніторингу фізичних серверів, мережевого обладнання та віртуальних машин на Linux/Ubuntu. Потребує глибокого налаштування.
    • Prometheus + Grafana: Стандарт де-факто для хмарних середовищ та Kubernetes. Prometheus збирає метрики, а Grafana перетворює їх на красиві та зрозумілі дашборди.
    • Netdata: Ідеально для моніторингу в реальному часі з точністю до секунди.

    2. Хмарні інструменти (Cloud-Native)

    Якщо ваш бізнес у хмарі, логічно використовувати вбудовані рішення:

    • Azure Monitor: Глибока інтеграція з ресурсами Microsoft, моніторинг AKS, SQL Database та Entra ID.
    • AWS CloudWatch: Потужний інструмент для екосистеми Amazon.
    • Google Stackdriver: Оптимально для GCP.

    3. SaaS-платформи (Enterprise рівень)

    • Datadog: Лідер ринку APM. Дорого, але дає максимально повну картину “з коробки”.
    • New Relic: Чудова візуалізація шляхів користувача та налагодження коду в реальному часі.

    Організація процесу: Своя команда vs Аутсорсинг

    Найскладніше питання для CTO: хто дивитиметься в монітори о 3 годині ночі в суботу?

    Варіант А: Власний відділ моніторингу (NOC)

    Щоб забезпечити покриття 24/7, вам потрібно як мінімум 4-5 співробітників (з урахуванням змін, відпусток та лікарняних).

    • Плюси: Повний контроль, глибоке знання продукту.
    • Мінуси: Величезні витрати на зарплати, податки та менеджмент.

    Вариант Б: Чергування інженерів (On-call)

    Розробники або DevOps-інженери по черзі беруть “тривожну кнопку”.

    • Плюси: Економія.
    • Мінуси: Вигорання співробітників, ризик того, що інженер не почує дзвінок вночі.

    Вариант В: Аутсорсинг моніторингу 24/7

    Передача функції спеціалізованій компанії.

    • Плюси: Дешевше, ніж власний штат; гарантований час реакції за договором; наявність готових процесів.
    • Мінуси: Потрібен час на передачу знань про архітектуру системи.

    Моніторинг серверів в Україні: Специфіка та реалії 2026 року

    Для українського бізнесу моніторинг сьогодні включає аспекти, про які рідко замислюються на Заході:

    1. Канали зв’язку: Моніторинг доступності через різних провайдерів та супутниковий зв’язок (Starlink).
    2. Енергонезалежність: Якщо ваш сервер стоїть “на місці”, необхідно моніторити стан ДБЖ та генераторів.
    3. Локальні ЦОД vs Хмари: Багато компаній мігрують з локальних дата-центрів до Європи (Польща, Німеччина) через Azure/AWS. Моніторинг допомагає контролювати затримки (latency) між українськими офісами та європейськими серверами.

    FAQ: Часті питання

    1. Чи достатньо просто налаштувати алерти в Telegram?

    Для невеликого проекту — так. Для бізнесу — ні. Потрібна система управління інцидентами (наприклад, Opsgenie або PagerDuty), яка телефонуватиме, якщо повідомлення в месенджері проігноровано.

    2. Чи впливає моніторинг на продуктивність сервера?

    Правильно налаштований агент споживає менше 1-3% ресурсів CPU та RAM. Це мізерна плата за спокій.

    3. З чого почати впровадження, якщо бюджету майже немає?

    Встановіть Netdata для швидкого старту та UptimeRobot (безкоштовний рівень) для зовнішньої перевірки доступності сайту.

    4. Чим моніторинг відрізняється від логування?

    Метрики (моніторинг) говорять вам, що “системі погано”. Логи говорять вам, “чому саме їй погано”. Вам потрібно і те, і інше.

    5. Чи потрібно моніторити тестові середовища (Staging)?

    Так, це дозволяє виявити витоки ресурсів ще до того, як код потрапить у Production.

    Висновок: Інвестуйте в стабільність

    Моніторинг серверів 24/7 — це не лише про код та залізо. Це про спокій ваших клієнтів та передбачуваність вашого бізнесу. У світі, де конкуренція за увагу користувача йде на секунди, ви не можете дозволити собі бути “офлайн”.

    Хочете переконатися, що ваша інфраструктура готова до будь-яких навантажень? Почніть з аудиту поточної системи моніторингу. Визначте критичні точки відмови та налаштуйте сповіщення вже сьогодні.

    Потрібна допомога в налаштуванні професійного моніторингу? Наші експерти допоможуть розгорнути систему на базі Zabbix, Prometheus або Azure Monitor, адаптовану під потреби вашого бізнесу. Забезпечте своєму IT-департаменту спокійні ночі, а клієнтам — бездоганний сервіс!

  • Резервне копіювання MS SQL Server в Azure: Повний гайд

    В епоху хмарних трансформацій питання «як робити бекап» змінилося на «як робити його максимально дешево, швидко та без навантаження на локальні диски». Якщо ваш сервер в Azure або on-premise забитий даними вщент, а вільне місце прагне до нуля, стандартні методи можуть підвести.

    У цій статті ми розберемо 4 перевірені способи бекапу MS SQL у хмару Azure, їхні плюси, мінуси та конкретні сценарії використання.

    1. SQL Server Backup to URL (Native)

    Це «рідний» спосіб для SQL Server, починаючи з версії 2012 SP1 CU2. Суть проста: сервер спілкується безпосередньо з Azure Blob Storage через HTTPS.

    • Як працює: Ви створюєте SQL Credential з ключем від Storage Account і вказуєте шлях URL = 'https://storage.blob.core.windows.net/...'.
    • Кому підходить: Ідеально для SQL Server 2016+ за наявності підтримки TLS 1.2 у системі.
    • Головний плюс: Не потребує проміжного місця на диску. Дані «стрімляться» відразу в хмару.
    • Критичний нюанс: Вимагає ідеального налаштування TLS. Якщо ваша ОС стара (Windows 2012), ви можете зіткнутися з помилками автентифікації.

    2. Azure File Share (SMB 3.0) — «Хмарний диск»

    Якщо Backup to URL вередує через налаштування безпеки або стару версію SQL, на допомогу приходить монтування мережевого диска через протокол SMB.

    • Як працює: Ви створюєте File Share в Azure і підключаєте його як диск Z: або використовуєте UNC-шлях \\mystorage.file.core.windows.net\backups.
    • Кому підходить: Тим, кому потрібна простота. Для SQL Server це виглядає як звичайний бекап на диск.
    • Приклад команди:

      1. Увімкнути xp_cmdshell

      Виконайте цей скрипт у SSMS. Він дозволить серверу виконувати консольні команди:

      -- 1. Дозволяємо зміну розширених налаштувань 
      EXEC sp_configure 'show advanced options', 1;
      RECONFIGURE; 
      GO 
      -- 2. Вмикаємо саму процедуру 
      EXEC sp_configure 'xp_cmdshell', 1; 
      RECONFIGURE; 
      GO

      2. Тепер пробуємо підключити диск і зробити бекап

      Після виконання кроку вище спробуйте знову підключити диск для служби SQL Server:

      -- Підключаємо Azure File Share 
      EXEC xp_cmdshell 'net use Z: \\mystorage.file.core.windows.net\backups\ /u:AZURE\backup [ВАШ_КЛЮЧ] /persistent:yes';
      -- Перевіряємо, чи бачить SQL вміст диска 
      EXEC xp_cmdshell 'dir Z:';

      Якщо в результаті виконання dir Z: ви побачили список папок — перемога! Можна запускати бекап:

      BACKUP DATABASE [MainDB] TO DISK = '\\mystorage.file.core.windows.net\backups\db.bak' WITH COMPRESSION, BLOCKSIZE = 65536;

      Важливо: Для стабільної роботи в Azure Files обов’язково використовуйте параметр BLOCKSIZE = 65536.

    3. Стрімінг через AzCopy (Pipe)

    Найпотужніший і найгнучкіший метод, коли на сервері 0 байт вільного місця, а порти SMB (445) заблоковані провайдером.

    • Як працює: Дані передаються через «трубу» (Pipe). SQL Server видає потік даних, а утиліта AzCopy підхоплює його і відправляє в Blob Storage через порт 443 (HTTPS).
    • Кому підходить: Складні інфраструктури, закриті фаєрволи, системи з критичним дефіцитом місця.
    • Плюс: AzCopy — найшвидша утиліта для передачі даних в Azure.
      # --- НАЛАШТУВАННЯ ПІДКЛЮЧЕННЯ ---
      $DatabaseName = "YOUR_DATABASE_NAME"      # Ім'я бази даних
      $StorageAccount = "yourstorageaccount"    # Ім'я вашого Storage Account в Azure
      $Container = "your-container-name"        # Ім'я контейнера для бекапів
      $SasToken = "?sv=2022-..."                # SAS Token з правами Write/Create
      
      # --- ФОРМУВАННЯ ШЛЯХІВ ---
      $Timestamp = Get-Date -Format "yyyyMMdd_HHmm"
      $BlobName = "${DatabaseName}_full_${Timestamp}.bak"
      $UploadUrl = "https://$StorageAccount.blob.core.windows.net/$Container/$BlobName$SasToken"
      
      Write-Host ">>> Запуск процесу резервного копіювання: $DatabaseName" -ForegroundColor Cyan
      
      # --- ПРЯМА ПЕРЕДАЧА ДАНИХ (PIPE) ---
      # 1. sqlcmd ініціює бекап і виводить потік даних у STDOUT (стандартний вивід)
      # 2. Оператор '|' передає цей потік на вхід AzCopy
      # 3. AzCopy приймає потік і завантажує його в Azure як PipeBlob
      
      & sqlcmd -S "." -E -Q "BACKUP DATABASE [$DatabaseName] TO DISK = 'STDOUT' WITH COMPRESSION, STATS = 10" `
      | & azcopy copy "$UploadUrl" --from-to PipeBlob
      
      if ($LASTEXITCODE -eq 0) {
          Write-Host ">>> Бекап успішно завантажено в Azure: $BlobName" -ForegroundColor Green
      } else {
          Write-Error ">>> Помилка під час виконання бекапу або завантаження."
      }


    4. Azure Backup (Recovery Services Vault)

    Це рішення рівня Enterprise. Не просто скрипт, а повноцінний сервіс управління бекапами.

    • Як працює: Усередині віртуальної машини Azure встановлюється розширення, яке робить моментальні знімки (snapshots) бази даних.
    • Кому підходить: Великим компаніям із сотнями баз, де важливий централізований моніторинг.
    • Плюс: Можливість відновлення на певний момент часу (Point-in-time recovery).

    Зведена таблиця: що вибрати?

    Метод Складність налаштування Порти Вимоги до дислокації
    Backup to URL Середня 443 (HTTPS) SQL 2016 + TLS 1.2
    Azure File Share Низька 445 (SMB) Будь-який SQL, відкритий порт 445
    AzCopy (Pipe) Висока 443 (HTTPS) Будь-яка версія, критичний дефіцит місця
    Azure Backup Низька (PaaS) Внутрішні Тільки для Azure VM

    Вердикт

    Для оптимізації IT-витрат і забезпечення відмовостійкості, ми рекомендуємо:

    1. Якщо сервер в Azure — використовуйте Azure Backup.
    2. Якщо сервер on-premise і місця немає — використовуйте AzCopy.
    3. Якщо потрібно швидко “скинути” копію вручну — Azure File Share.

    Пам’ятайте: бекап вважається виконаним тільки тоді, коли ви спробували його відновити.

    Потрібна допомога в налаштуванні конкретного скрипта під вашу інфраструктуру?

  • Штатний сісадмін vs аутсорсинг: порівняння витрат за рік

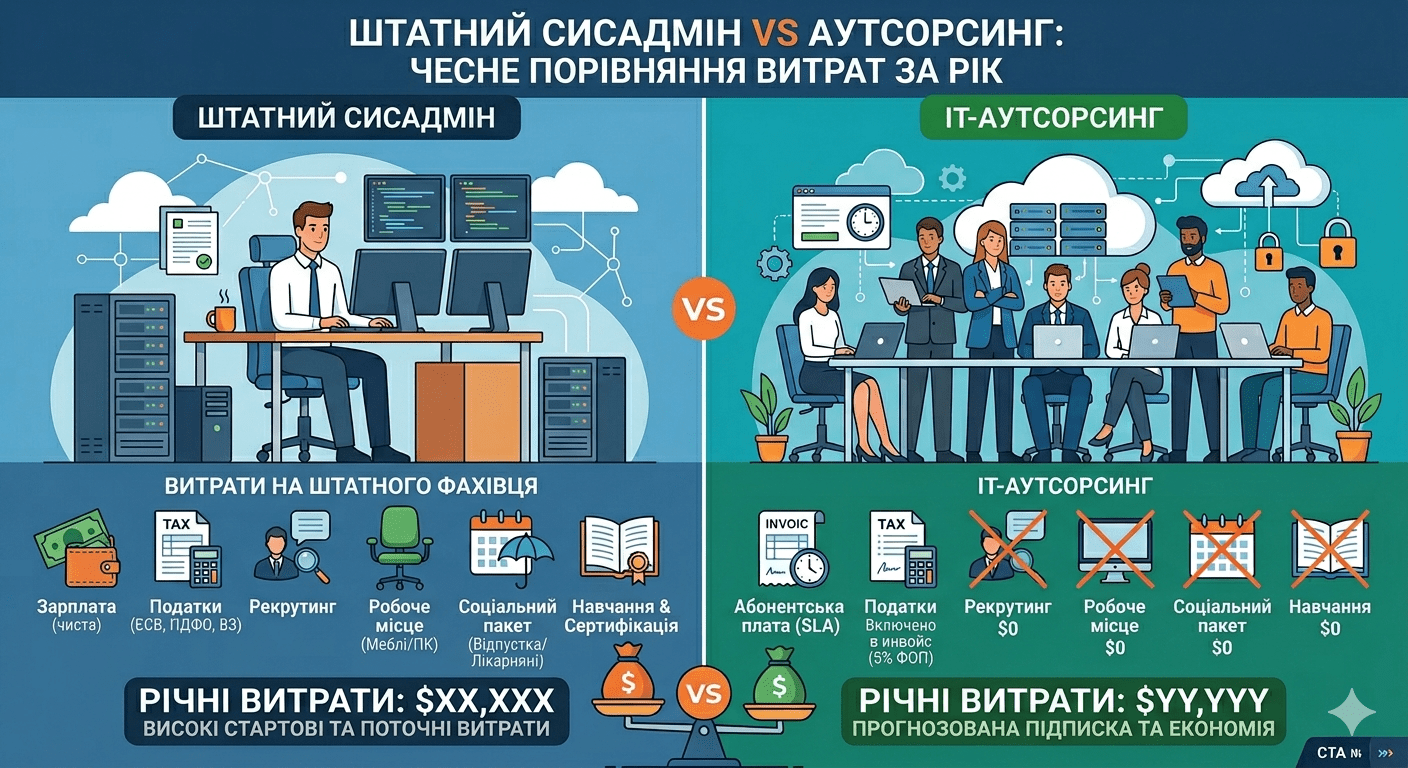
    Штатний сісадмін vs аутсорсинг: порівняння витрат за рік

    Вибір між наймом співробітника в штат і залученням зовнішньої команди — це не просто питання симпатії до певної моделі управління. Для CTO, власника бізнесу або IT-директора в Україні це, перш за все, математична задача. На одній шальці терезів — зрозумілий (на перший погляд) щомісячний оклад, на іншій — гнучкість і експертиза цілої компанії.

    Коли бізнес росте, питання «сисадмін або аутсорсинг» постає руба. Часто керівники дивляться лише на цінник у вакансії та порівнюють його з щомісячним інвойсом аутсорсингової компанії. Це критична помилка. Реальна вартість сисадміна включає в себе податки, вартість робочого місця, ризики «людського фактора» та витрати на навчання.

    У цій статті ми проведемо глибокий фінансовий аудит обох моделей, розберемо приховані витрати і визначимо, яка конфігурація буде найбільш ефективною для вашої інфраструктури (особливо якщо ви використовуєте Azure, AWS або гібридні хмари) у розрізі 12 місяців.

    1. Прямі та приховані витрати на штатного системного адміністратора

    Найняти «свою» людину здається безпечним рішенням: вона завжди під рукою, знає всі нюанси локальної мережі та лояльна до бренду. Однак фінансова сторона питання в реаліях українського ринку виглядає інакше.

    Зарплата та податкове навантаження

    Середня зарплата системного адміністратора рівня Middle/Senior у Києві або віддалено по Україні коливається від $1500 до $3500 залежно від стека (Windows Server, Linux, DevOps-практики, Cloud Infrastructure).

    Але зарплата «на руки» — це лише верхівка айсберга.

    • Податки: Якщо співробітник оформлений у штат, компанія платить 22% ЄСВ. Якщо через ФОП (що частіше для IT), компанія бере на себе супровід, виплату податків (5% + ЄСВ) та банківські комісії.
    • Рекрутинг: Вартість послуг кадрового агентства зазвичай становить 10–20% від річного доходу фахівця. Якщо ви шукаєте самі, закладіть десятки годин роботи HR та техліда на співбесіди.

    Організація робочого місця

    Для ефективної роботи адміністратору потрібен не просто «ноутбук», а продуктивна станція, мінімум два монітори, ліцензійне ПЗ та комфортне крісло.

    1. Залізо та меблі: ~$2000–3000 (одноразово).
    2. Оренда офісу: У середньому 10–15 кв.м на співробітника з урахуванням загальних зон. При ставці $15/м² — це ще $150–225 щомісяця.

    Соціальний пакет та розвиток

    • Відпустка та лікарняні: 24 календарних дні відпустки + 10 днів лікарняних на рік. У цей час робота або стоїть, або її робить хтось інший (якому теж потрібно платити).
    • Навчання та сертифікація: Щоб ваш адмін не перетворився на «енікейника» з 2010-х, йому потрібно проходити курси по Azure, AWS або Kubernetes. Це додаткові $500–1500 на рік.

    2. IT-аутсорсинг: структура ціноутворення

    Розглядаючи сисадмін або аутсорсинг, важливо розуміти, что у другому випадку ви купуєте не «людину», а «функцію» та «результат», закріплений у SLA (Service Level Agreement).

    Моделі оплати

    1. Managed Services (Абонентська плата): Фіксована сума на місяць за підтримку певної кількості серверів, робочих місць та мережевого обладнання.
    2. Time & Material (Погодинна оплата): Ви платите за фактично відпрацьовані години. Підходить для разових проєктів (наприклад, міграція у хмару).

    Що включено у вартість аутсорсингу?

    • Колективний досвід: Замість однієї людини ви отримуєте доступ до команди, де є фахівці з баз даних, мережевої безпеки, хмарні архітектори та DevOps.
    • Цілодобовий моніторинг: Системи моніторингу (Zabbix, Prometheus, Grafana) вже розгорнуті та налаштовані.
    • Замінність: Вам не важливо, хто з інженерів пішов у відпустку або захворів — контракт гарантує виконання робіт 24/7/365.

    3. Порівняльна таблиця витрат за рік (Case Study)

    Для прикладу візьмемо середню компанію в Україні з інфраструктурою на 50 робочих місць та 10 серверів (суміш локальних потужностей та Azure).

    Стаття витрат Штатний сисадмін (Middle) IT-аутсорсинг (Команда)
    Зарплата / Абонплата (міс.) $2,000 $1,200
    Податки та банківські комісії $150 (ФОП 5% + ЄСВ) $0 (включено в інвойс)
    Рекрутинг (одноразово) $2,000 $0
    Робоче місце та офіс (рік) $2,500 $0
    Відпускні / Лікарняні $2,500 (прихована вартість) $0
    ПЗ, моніторинг, інструменти $500 (ліцензії на тулзи) $0 (використовують свої)
    РАЗОМ за 1 рік $31,600 $14,400

    Висновок: У перший рік штатний фахівець обходиться більш ніж у 2 рази дорожче за рахунок стартових інвестицій та податків. У наступні роки різниця зберігається на рівні 40–60%.

    4. Глибокий аналіз ризиків: «Людський фактор» проти SLA

    Коли ми обговорюємо вартість сисадміна, не можна ігнорувати нематеріальні ризики, які в один момент можуть стати цілком матеріальними збитками.

    Проблема «Bus Factor» (Фактор автобуса)

    Якщо всю вашу мережу знає лише одна людина («Василь»), і завтра її «зіб’є автобус» (або вона просто вирішить звільнитися перед важливим релізом), ваш бізнес паралізує. Знання замкнені в одній голові.

    Аутсорсинг: Документація ведеться централізовано. У проєкті завжди задіяно мінімум 2–3 інженери.

    Компетенції та спеціалізація

    Один сисадмін не може бути експертом у всьому. Він може чудово налаштовувати Mikrotik, але «плавати» в оптимізації SQL Server або налаштуванні CI/CD пайплайнів в Azure.

    Аутсорсинг: Компанія-підрядник направляє на конкретну задачу вузького спеціаліста. Потрібно налаштувати кластер Kubernetes? Прийде DevOps-інженер. Проблеми з поштою Exchange? Підключиться експерт з Microsoft 365.

    Швидкість реакції

    Штатний адмін працює з 9:00 до 18:00. Якщо сервер упав у суботу ввечері, ви або доплачуєте за понаднормові (і сподіваєтеся, що він тверезий і в нього є інтернет), або чекаєте ранку понеділка.

    Аутсорсинг: SLA чітко прописує час реакції (наприклад, 15 хвилин для критичних інцидентів) у будь-який час доби.

    5. Синергія: Коли штатний адмін дійсно потрібен?

    Незважаючи на фінансову вигоду аутсорсингу, є сценарії, коли штатна одиниця (або відділ) виправдані:

    1. Надвеликий бізнес (Enterprise): Коли кількість завдань вимагає 40+ годин роботи на тиждень для кількох людей.
    2. Специфічне виробництво: Де потрібна фізична присутність інженера біля верстата або специфічного обладнання 24/7.
    3. R&D центри: Де IT-інфраструктура є частиною продукту і вимагає глибокого занурення в код.

    Оптимальна модель для середнього бізнесу: Гібридна схема. У штаті залишається IT-менеджер (CTO), який керує стратегією та бізнес-логікою, а вся операційка (сервери, хмари, техпідтримка) віддається на аутсорсинг.

    6. Як правильно мігрувати на аутсорсинг в Україні?

    Якщо ви вирішили, що сисадмін або аутсорсинг — вибір на користь останнього, дотримуйтесь цього алгоритму:

    1. Аудит: Перед передачею справ проведіть інвентаризацію активів. Що у нас в Azure? Які ліцензії активні?
    2. Фіксація SLA: Не підписуйте «порожній» договір. Вимагайте чітких термінів реакції та відповідальності за простій.
    3. Передача доступів: Використовуйте менеджери паролів (Bitwarden, 1Password) для безпечної передачі облікових даних.
    4. Тестовий період: Оцініть якість підтримки на простих задачах у перший місяць.

    FAQ: Часті питання

    1. Аутсорсинг — це безпечно? У них же будуть всі мої дані.

    Безпека при аутсорсингу часто вища, ніж усередині компанії. Серйозні компанії підписують NDA (угоду про нерозголошення), мають страховку професійної відповідальності та використовують системи логування дій інженерів. Штатний співробітник може піти з базою даних, і притягнути його до відповідальності буде складніше.

    2. Скільки коштує мінімальний пакет аутсорсингу в Україні?

    Для невеликого офісу (до 10 осіб) підтримка може коштувати від $300–500 на місяць. Для компаній, що активно використовують хмари (Azure/AWS), ціна формується виходячи зі складності інфраструктури.

    3. Чи може аутсорсинг замінити DevOps-інженера?

    Так. Багато компаній в Україні надають послугу «DevOps as a Service». Це набагато вигідніше, ніж наймати штатного DevOps із зарплатою $5000+.

    4. Що робити, якщо нам потрібно «прийти і вставити кабель»?

    Професійні аутсорсери мають виїзних інженерів. Для віддалених філій в Україні (Львів, Одеса, Дніпро) зазвичай залучаються локальні партнери або використовуються послуги «smart hands».

    Висновок

    Вибираючи між штатним сисадміном та аутсорсингом, важливо пам’ятати: ви платите не за присутність людини в офісі, а за аптайм вашого бізнесу. У 90% випадків для українського середнього бізнесу та стартапів аутсорсингова модель виявляється на 30–50% дешевшою у річному обчисленні та в рази надійнішою з точки зору експертизи.

    Якщо ваша мета — масштабованість, безпека та прозорий бюджет, час переходити на професійне управління інфраструктурою.

    Готові оптимізувати ваші IT-витрати? Замовте аудит вашої інфраструктури сьогодні і отримайте детальний розрахунок вартості обслуговування за моделлю Managed Services!

  • Адміністрація серверів: ціна та склад послуг аутсорсингу в Україні в 2026 році

    Адміністрація серверів: ціна та склад послуг аутсорсингу в Україні в 2026 році

    Сучасний бізнес більше не може дозволити собі «просто працюючий» сервер. В епоху high-load систем, розподілених хмарних архітектур та постійних кіберзагроз інфраструктура стає фундаментом, від якого безпосередньо залежить прибуток. Якщо ваш інтернет-магазин «падає» під час розпродажу, а корпоративна пошта блокується через переповнення логів SQL-сервера — ви втрачаєте не тільки гроші, а й репутацію.

    Для багатьох компаній в Україні — від амбітних стартапів до великих промислових холдингів — постає питання: наймати штатного системного адміністратора чи передати завдання на аутсорс? Головний стоп-фактор при виборі другого варіанту — невизначеність. Скільки коштує адміністрування серверів, що саме входить у цю ціну і як не переплатити за «повітря»?

    У цій статті ми проведемо глибокий аудит ринку IT-аутсорсингу України, розберемо моделі ціноутворення та покажемо, як експертний підхід до DevOps та системного адміністрування економить до 40% IT-бюджету.аутсорсинг серверів України.

    Чому бізнес переходить на аутсорсинг серверів?

    Епоха «сисадміна у светрі», який перевстановлює Windows і лагодить принтери, минула. Сьогодні адміністрування — це робота з Infrastructure as Code (IaC), контейнеризацією (Docker/Kubernetes), хмарними провайдерами (Microsoft Azure, AWS, GCP) та забезпеченням безперервності бізнесу (BCP).

    1. Економічна вигода

    Середня зарплата Middle DevOps-інженера або досвідченого системного адміністратора в Україні починається від $1500–$2500. Додайте до цього податки, вартість робочого місця, ліцензії на ПЗ та витрати на пошук/навчання. Аутсорсинг серверів в Україні дозволяє отримати команду експертів за ціною одного штатного співробітника (або навіть дешевше).

    2. Експертиза 24/7/365

    Штатний співробітник іде у відпустку, хворіє або спить уночі. Сервер не обирає час для збою. Аутсорсингова компанія надає підтримку в режимі 24/7, де за стабільність системи відповідає не одна людина, а ціла команда з черговими інженерами.

    3. Доступ до технологій рівня Enterprise

    Передаючи інфраструктуру експертам, ви отримуєте досвід, накопичений на сотнях проєктів. Налаштування автоматизованих бекапів в Azure, міграція Exchange-серверів без переривання роботи, впровадження GitOps через ArgoCD або Flux — ці завдання потребують вузькоспеціалізованих знань, які складно знайти в «універсального» адміна.

    Адміністрування серверів: ціна та пакети послуг

    Вартість послуг формується індивідуально, виходячи зі складності архітектури та вимог до SLA (Service Level Agreement). Проте на ринку України склалися певні цінові діапазони.

    Орієнтовна вартість на місяць (прайс 2026 року)

    Пакет послуг Для кого підходить Приблизна ціна (за од.) Що включено (база)
    Базовий (Reactive) Малий бізнес, лендинги, прості сайти від $100 / сервер Реакція на інциденти, оновлення ОС, бекап
    Стандартний (Proactive) Середній бізнес, e-commerce, CRM-системи від $150 / сервер Моніторинг 24/7, безпека, оптимізація SQL
    DevOps / Cloud Стартапи, Enterprise, High-load від $500 / проєкт IaC (Bicep/Terraform), CI/CD, Kubernetes, Azure/AWS
    Разові роботи Міграція, аудит, налаштування з нуля від $40 / година Технічне завдання, міграція пошти, аудит безпеки

    Що включено у професійне адміністрування?

    Купуючи послугу «адміністрування серверів за ціною», нижчою за ринкову, бізнес часто отримує лише «пінг» сервера. Професійний же підхід містить багаторівневу роботу.

    1. Моніторинг та реагування на інциденти

    Це не просто перевірка, чи «живе» сайт. Це глибокий аналіз метрик:

    • Завантаження CPU та RAM (пошук витоків пам’яті).
    • I/O дискової підсистеми (особливо критично для баз даних SQL Server).
    • Аналіз логів на предмет аномалій та спроб зламу.
    • Response Time: Час реакції на критичний збій у професійних компаніях становить від 15 до 30 хвилин.

    2. Підтримка хмарних та гібридних інфраструктур

    Якщо ваш бізнес використовує Azure, AWS або Google Cloud, адміністрування стає більш інтелектуальним. Воно включає:

    • Управління витратами (FinOps): Оптимізація ресурсів, щоб ви не платили за невикористовувані потужності.
    • Автоматизація через Bicep або Terraform: Розгортання інфраструктури кодом, що виключає людський фактор.
    • Azure Backup та Disaster Recovery: Налаштування планів відновлення, які гарантують запуск системи в іншому регіоні у разі глобального збою.

    3. Робота з базами даних та корпоративним ПЗ

    Особлива увага приділяється SQL Server та Microsoft Exchange. Це «серце» корпоративної IT-системи.

    • SQL Server: Обслуговування планів обслуговування, контроль розростання транзакційних логів, оптимізація індексів.
    • Exchange: Планування та реалізація міграцій (наприклад, перехід з Exchange 2010 на 2019 через проміжні ланки), налаштування безпеки поштового трафіку.

    4. Безпека та комплаєнс

    Аутсорсинг серверів в Україні сьогодні неможливий без захисту даних.

    • Налаштування Firewall та VPN.
    • Двофакторна автентифікація (MFA) через Entra ID (колишній Azure AD).
    • Регулярний патч-менеджмент (закриття вразливостей ОС).
    • Захист від DDoS-атак.

    Детальний розбір: З чого складається «адміністрування серверів ціна»?

    Багато клієнтів запитують: «Чому в одних компаній обслуговування коштує $100, а в інших — $500?». Давайте заглянемо «під капот» ціноутворення.

    Глибина моніторингу

    Дешевий сервіс моніторить лише доступність порту 80 або 443. Дорогий — моніторить бізнес-метрики. Наприклад, якщо кількість замовлень у кошику різко впала до нуля, при цьому сервер «зелений» — система моніторингу має підняти тривогу, оскільки проблема може бути в логіці додатка або зв’язку з платіжним шлюзом.

    Технологічний стек

    Адміністрування простого VPS на Linux з панеллю управління типу ISPmanager коштує дешево. Але якщо ваша інфраструктура — це:

    • Кластери Kubernetes;
    • Розподілені БД з реплікацією;
    • Складні CI/CD пайплайни в GitLab або GitHub;
    • Інфраструктура, описана в Azure Bicep.

    У цьому випадку потрібні інженери рівня Senior, чий час коштує значно дорожче, але й рівень надійності системи зростає в рази.

    SLA (Угода про рівень послуг)

    SLA — це юридично закріплена відповідальність провайдера. Чим вищий необхідний аптайм (наприклад, 99.99%) і чим коротший час реакції на інцидент, тим вища ціна. Ви платите за те, щоб інженер кинув усі справи і почав вирішувати вашу проблему о 3 годині ночі в новорічну ніч.

    Порівняння: Штатний адмін vs Аутсорсингова компанія

    Щоб прийняти рішення, CTO або власнику бізнесу варто поглянути на цифри та ризики.

    Параметр Штатний системний адміністратор Аутсорсинг серверів (Україна)
    Вартість Висока (ЗП + податки + офіс + софт) Гнучка (оплата лише за результат)
    Графік роботи 8 годин / 5 днів (зазвичай) 24 / 7 / 365
    Рівень знань Обмежений досвідом однієї людини Колективний досвід усієї компанії
    Ризик звільнення Критичний (забирає знання з собою) Мінімальний (договір з юрособою)
    Масштабованість Повільна (потрібно наймати ще людей) Миттєва (додавання нових послуг)

    Як обрати партнера з аутсорсингу в Україні?

    Ринок переповнений пропозиціями, але не всі вони однаково корисні. Ось чек-лист для перевірки потенційного підрядника:

    1. Наявність кейсів у вашій ніші. Якщо ви займаєтеся фінтехом, у компанії має бути досвід роботи з PCI DSS. Якщо у вас e-commerce — досвід роботи з high-load.
    2. Інструментарій. Запитайте, які системи моніторингу вони використовують (Zabbix, Prometheus, Grafana) і як автоматизують завдання. Якщо все робиться «руками» — це ризик помилок.
    3. Безпека. Як передаються доступи? Чи використовується менеджер паролів, VPN, SSH-ключі? Чи є аудит дій інженерів?
    4. Прозорість звітності. Чи будете ви бачити, за що платите? Ідеальний варіант — щомісячний звіт з метриками аптайму, списком виконаних робіт та рекомендаціями щодо оптимізації.
    5. Локація та мова. Для компаній в Україні важливо, щоб підтримка розуміла локальний контекст (наприклад, специфіку роботи з українськими хмарними провайдерами або канали зв’язку в умовах нестабільного енергопостачання).

    Практичний кейс: Оптимізація витрат на Azure

    До нас звернувся клієнт — великий український ритейлер. Їхні витрати на Microsoft Azure зростали щомісяця, при цьому періодично виникали проблеми з продуктивністю SQL-баз.

    Що було зроблено в межах адміністрування:

    1. Аудит ресурсів: Виявлено «перерозмірені» віртуальні машини (Overprovisioning).
    2. Міграція на Bicep: Перевели управління інфраструктурою на IaC, що дозволило швидко розгортати тестові середовища та видаляти їх після використання.
    3. Оптимізація SQL Server: Налаштування регламентних завдань (maintenance plans) та перехід на Azure SQL Managed Instance, що знизило навантаження на CPU на 30%.
    4. Результат: Вартість інфраструктури знизилася на 25%, час відгуку сайту скоротився у 2 рази.

    FAQ: Часті запитання про адміністрування серверів

    1. Чи може аутсорсинг повністю замінити IT-відділ?

    Так, для малого та середнього бізнесу це часте рішення. Для великих корпорацій аутсорсинг стає чудовим доповненням, забираючи на себе рутину (L1/L2 підтримку) та складні інфраструктурні завдання, звільняючи внутрішніх розробників для роботи над продуктом.

    2. Чи безпечно надавати доступ до серверів сторонній компанії?

    Безпечніше, ніж мати одного адміна з паролями в блокноті. Професійні компанії працюють за договором NDA, використовують системи контролю доступу (Privileged Access Management) і несуть матеріальну відповідальність за збереження даних.

    3. Як швидко відбувається перехід на аутсорсинг?

    Базова передача прав та налаштування моніторингу займає від 1 до 3 робочих днів. Повний аудит та впровадження стандартів безпеки може тривати від 2 тижнів до місяця.

    4. Чи впливає місце розташування сервера на вартість адміністрування?

    Фізичне місце розташування (Україна, Німеччина, США) майже не впливає на ціну послуг адміністрування, але впливає на архітектурні рішення (затримки мережі, вимоги законодавства щодо зберігання даних).

    5. Що робити, якщо у мене специфічне ПЗ (наприклад, DSpace або самописна CRM)?

    Експертні команди спочатку проводять аудит. Якщо документація на ПЗ є, а архітектура зрозуміла, підтримка специфічного софту просто включається в регламент робіт.

    Висновок

    Адміністрування серверів та ціна на нього — це інвестиція у стабільність вашого бізнесу. В Україні 2026 року аутсорсинг перестав бути просто способом заощадити. Це спосіб отримати доступ до технологій DevOps, хмарної експертизи Azure/AWS та гарантії того, що ваш проєкт буде доступний клієнтам у будь-якій ситуації.

    Не чекайте, поки сервер «впаде». Превентивне обслуговування завжди дешевше за аварійне відновлення.

    Готові оптимізувати свою інфраструктуру?

    Зв’яжіться з нами для експрес-аудиту вашої системи. Ми проаналізуємо поточні витрати, знайдемо вузькі місця та запропонуємо пакет адміністрування, який ідеально підходить під ваші завдання та бюджет.

  • Кейс: як автоматизація деплою скоротила час випуску продукту з 4 годин до 15 хвилин

    Кейс: як автоматизація деплою скоротила час випуску продукту з 4 годин до 15 хвилин

    У сучасному IT-бізнесі швидкість доставки фіч (Time-to-Market) визначає лідерство на ринку. Проте багато компаній в Україні досі стикаються з «кошмаром релізного дня», коли викатка оновлення перетворюється на багатогодинну спецоперацію всієї інженерної команди. У цьому матеріалі ми розберемо детальний DevOps кейс, у якому покажемо, як грамотна автоматизація деплою дозволила нам скоротити час поставки коду в 16 разів, мінімізувати людський фактор і вивільнити десятки годин робочого часу високооплачуваних фахівців щомісяця.

    Проблема: 4 години очікування та «ручний» страх

    До початку трансформації процес деплою в компанії нагадув лотерею. Незважаючи на наявність кваліфікованих розробників, інфраструктура залишалася «застиглою» в минулому десятилітті.

    Типовий сценарій релізу виглядав так:

    1. Розробник вручну збирав артефакт.
    2. Передавав його системному адміністратору через месенджер або Jira.
    3. Адміністратор заходив через SSH на сервер, вручну змінював конфіги, зупиняв сервіси та копіював файли.
    4. Перевірка працездатності проводилася «на око» або через вибіркове проклікування інтерфейсу.

    Результат? Процес займав від 4 до 6 годин. Якщо на етапі копіювання виникала помилка в одній літері конфігу, система «падала», а пошук причини займав ще стільки ж часу. Для CTO це означало величезні простої, а для бізнесу — прямі збитки та репутаційні ризики.

    Аналіз вузьких місць: чому деплой був таким повільним?

    Перш ніж впроваджувати інструменти, ми провели глибокий аудит. Автоматизація деплою неможлива без розуміння того, де саме втрачається час. Ми виділили 4 критичні фактори:

    1. Відсутність стандартизації оточень: На комп’ютерах розробників стояла одна версія бібліотек, на стейджингу — друга, у продакшені — третя. Знамените «у мене на локалці все працює» було щоденною реальністю.
    2. Ручне управління конфігураціями: Кожен сервер налаштовувався індивідуально. Це породжувало «дрейф конфігурацій» (configuration drift), коли два ідентичні сервери насправді працювали по-різному.
    3. Відсутність автоматичних тестів: Перевірка коду відбувалася вже після деплою силами QA-інженерів або, що ще гірше, користувачів.
    4. Низька частота релізів: Через складність процесу компанія накопичувала зміни тижнями. Великий реліз — це завжди більше ризиків, ніж серія дрібних оновлень.devops кейс порівняння ручного та автоматизованого деплою інфографіка

    Стратегія трансформації: від хаосу до CI/CD

    Наш DevOps кейс базувався на впровадженні культури безперервної інтеграції та доставки (Continuous Integration / Continuous Delivery). Ми розділили процес на кілька етапів, щоб бізнес не зупинявся під час «ремонту» інфраструктури.

    1. Контейнеризація та Docker

    Першим кроком став перехід на Docker. Ми упакували додаток і всі його залежності в контейнери. Це вирішило проблему невідповідності оточень: тепер образ, протестований на стейджингу, був абсолютно ідентичним тому, що йде у продакшен.

    2. Впровадження Infrastructure as Code (IaC)

    Ми відмовилися від ручного налаштування серверів. За допомогою таких інструментів, як Terraform та Azure Bicep, інфраструктура була описана у вигляді коду. Тепер підняти новий кластер або змінити параметри мережі можна було однією командою, виключаючи ймовірність помилки адміністратора.

    3. Побудова CI/CD пайплайну

    Ми використовували GitHub Actions (хоча аналогічно працюють GitLab CI або Jenkins) для автоматизації всіх кроків:

    • Build: Автоматична збірка Docker-образу при кожному пуші в основну гілку.
    • Test: Запуск unit-тестів та лінтерів. Якщо тести не пройдені — пайплайн зупиняється, код не йде далі.
    • Deploy: Автоматична викатка в хмару (у нашому випадку Azure Container Apps та Kubernetes).

    Технічна реалізація: як ми отримали 15 хвилин

    Давайте заглянемо «під капот». Автоматизація деплою вимагає чіткої послідовності дій. Ми впровадили поетапний процес, який перетворив 4 години рутини на 15 хвилин чистого прогресу.

    Етап 1: Оптимізація збірки (0–5 хвилина)

    Раніше збірка артефакту мігла тривати до 40 хвилин через повільне завантаження залежностей. Ми впровадили кешування шарів Docker та використання внутрішніх проксі-репозиторіїв. Тепер збірка займає не більше 5 хвилин.

    Етап 2: Автоматичне тестування (5–10 хвилина)

    Ми впровадили паралельний запуск тестів. Замість послідовного виконання, тести розбиваються на потоки. Це дозволяє перевіряти тисячі рядків коду за лічені хвилини.

    Важливо для CTO: Це створює «захисний контур». Помилки відловлюються до того, як вони зачеплять клієнта.

    Етап 3: Стратегія Blue-Green Deployment (10–15 хвилина)

    Це ключовий елемент нашого успіху. Ми не оновлюємо працюючі сервери «на живо».

    1. Піднімається нове середовище (Green) з оновленою версією коду.
    2. Проводяться автоматичні Smoke-тести.
    3. Трафік миттєво переключається з версії Blue (старої) на Green.
    4. Якщо щось пішло не так, відкат (Rollback) займає рівно 1 секунду — досить просто переключити трафік назад.
    Параметр До автоматизації Після (Наш кейс) Результат
    Час деплою 4–6 годин 12–15 хвилин Прискорення в 16+ разів
    Кількість помилок ~30% релізів з багами < 2% релізів Зростання стабільності
    Участь людини 2–3 інженери 0 (автоматично) Економія ФОП
    Час відкату 60+ хвилин < 1 хвилини Мінімізація Downtime

    Економічний ефект для бізнесу в Україні

    Для середнього та великого бізнесу в Україні, особливо в умовах нестабільності, ефективність IT-департаменту є критичною.

    1. Зниження вартості релізу: Якщо година роботи Senior DevOps та Lead Developer коштує умовно $50-80, то 4 години простою всієї команди на релізі обходяться компанії в сотні та тисячі доларів щотижня. Автоматизація окупається за 3–4 місяці тільки на економії робочого часу.
    2. Прискорення Time-to-Market: Маркетологи можуть тестувати гіпотези швидше. Фіча, придумана вранці, до обіду вже може бути на продакшені.
    3. Безпека: Впровадження DevSecOps (автоматичне сканування коду на вразливості всередині пайплайну) знижує ризики зламу та витоку даних клієнтів.

    Роль хмарних технологій (Azure/AWS/GCP)

    Наш DevOps кейс реалізовувався на базі Microsoft Azure, але принципи універсальні для будь-якої хмари. Використання керованих сервісів (Managed Services), таких як Azure Kubernetes Service (AKS) або AWS EKS, дозволяє зняти з команди завдання «підтримки життя» самих серверів і сфокусуватися на доставці продукту.

    Для компаній, які тільки планують міграцію в хмару, автоматизація має бути закладена у фундамент. Спроба перенести «ручний деплой» з локальних серверів у хмару — це шлях до невиправданого зростання рахунків від провайдера та відсутності гнучкості.

    FAQ: Часті питання про автоматизацію деплою

    1. Скільки часу займає впровадження такої автоматизації?

    Все залежить від складності архітектури (моноліт або мікросервіси). У середньому, перехід на базовий CI/CD пайплайн займає від 2 до 6 тижнів. Глибока трансформація з IaC та Kubernetes може тривати 3–6 місяців.

    2. Наскільки це дорого для стартапу?

    Навпаки, автоматизація деплою економить гроші стартапу. Використання безкоштовних рівнів GitHub Actions або GitLab CI на старті дозволяє уникнути найму зайвого системного адміністратора. Ви платите за хмарні ресурси тільки тоді, коли вони реально використовуються.

    3. Чи підійде автоматизація для Legacy-проєктів?

    Так, але це складніше. Часто доводиться починати з «обгортання» старого коду в Docker. Навіть якщо ви не досягнете 15 хвилин відразу, скорочення часу з 4 годин до 1 години — вже величезна перемога для старого проєкту.

    4. Які ризики несе автоматизація?

    Головний ризик — «автоматизація хаосу». Якщо у вас немає тестів, автоматика просто буде доставляти баги користувачам у 16 разів швидше. Тому DevOps завжди починається з культури тестування та відповідальності за код.

    5. Чи допоможе це при міграції в Azure або AWS?

    Безумовно. Автоматизація через IaC (Terraform/Bicep) робить процес міграції передбачуваним. Ви можете «відрепетирувати» переїзд у хмару десятки разів у тестовому середовищі, перш ніж переключити реальних користувачів.

    Висновок: Час — найдорожчий ресурс

    Результат нашого кейса — це не просто цифри 4 години та 15 хвилин. Це зміна психології команди. Розробники перестали боятися п’ятничних релізів, CTO отримав прозору звітність про якість коду, а бізнес почав рости швидше, не впираючись у технічну стелю.

    Автоматизація деплоя — це не розкіш, а стандарт індустрії у 2026 році. Якщо ваш релізний цикл досі вимагає ручного втручання і займає понад годину, ви щодня втрачаєте гроші та лояльність клієнтів.

    Хочете оптимізувати свою інфраструктуру та прискорити релізи? Ми допоможемо провести аудит поточних процесів, вибудувати надійний CI/CD пайплайн та мігрувати в хмару з мінімальними ризиками.

    [Зв’язатися з DevOps-експертом для безкоштовної консультації]