Категорія: Uncategorized

  • SQL Server 2025: інтеграція ШІ, оновлення для розробників та значні прирости продуктивності

    SQL Server 2025 є одним із наймасштабніших релізів SQL Server за останнє десятиліття. Наразі версія доступна у публічному прев’ю та зосереджена на трьох ключових напрямах: глибокій інтеграції ШІ, суттєвих покращеннях для розробників і помітному зростанні продуктивності.

    Що нового в SQL Server 2025

    Реліз сфокусований на трьох основних напрямах:

    1. ШІ-пошук та інтелектуальні можливості

    2. Підвищення продуктивності розробників і сучасні типи даних

    3. Аналітика, продуктивність і хмарна інтеграція

    Розглянемо кожен із них детальніше.

    Вбудований ШІ та векторний пошук

    Однією з ключових інновацій стала нативна інтеграція ШІ безпосередньо в рушій бази даних.

    Векторний пошук для семантичних запитів

    SQL Server 2025 підтримує вбудований векторний пошук, що дозволяє виконувати семантичні запити на основі змісту та подібності, а не лише ключових слів.

    У порівнянні з класичним повнотекстовим пошуком, векторний підхід дає змогу:

    • Використовувати запити природною мовою

    • Знаходити результати за семантичною схожістю

    • Запускати ШІ-пошук локально, без використання GPU

    Розробники можуть використовувати open-source моделі ембедінгів (наприклад, з Hugging Face) і:

    • Реєструвати їх через CREATE EXTERNAL MODEL

    • Зберігати ембедінги з допомогою нового векторного типу даних

    • Генерувати ембедінги за допомогою вбудованих T-SQL-функцій

    Оптимізація з DiskANN

    Для високої продуктивності векторного пошуку SQL Server 2025 використовує Disk Approximate Nearest Neighbor (DiskANN) — дискові індекси для пошуку найближчих векторів.

    Це дозволяє перенести обчислення, які раніше виконувалися в оперативній пам’яті, на оптимізовані дискові структури, роблячи семантичний пошук доступним навіть на звичайному обладнанні.

    Багатомовний ШІ-пошук

    Замінивши модель ембедінгів на багатомовну (наприклад, через Azure OpenAI), можна виконувати пошук одразу кількома мовами без змін у коді, зокрема й китайською.

    Оновлення для розробників: JSON і потокові події

    Нативний тип даних JSON

    SQL Server 2025 вводить рідний тип даних JSON, який підтримує документи розміром до 2 ГБ.

    Нові можливості для розробників:

    • Зберігання JSON у нативному форматі

    • Отримання значень через JSON_VALUE

    • Робота з вкладеними структурами через JSON_QUERY

    • Агрегація JSON-даних

    • Зміна даних безпосередньо всередині JSON-документів

    Індексація JSON

    Новий JSON-індекс суттєво пришвидшує пошук у вкладених JSON-документах.
    Функція JSON_CONTAINS дозволяє ефективно шукати дані, не втрачаючи переваг SQL — з’єднань, безпеки та оптимізованих планів виконання.

    Change Event Streaming для систем реального часу

    SQL Server 2025 спрощує роботу з Change Data Capture завдяки Change Event Streaming:

    • Зменшується I/O-навантаження

    • Зміни з журналу транзакцій передаються напряму в застосунки

    • Підтримується нативна інтеграція з Azure Event Hub

    Це відкриває можливості для подієво-орієнтованих архітектур із миттєвою реакцією на зміни даних.

    ШІ-агенти в дії

    У демонстрації зміни в замовленнях надсилаються в Azure Function, яка викликає ШІ-агента для:

    • Аналізу затримок доставки

    • Автоматичної зміни служби доставки

    • Повідомлення клієнтів про оновлену інформацію

    Таким чином SQL Server 2025 стає основою для ШІ-автоматизації бізнес-процесів.

    Продуктивність і конкурентний доступ

    Оптимізація блокувань

    Нова опція Optimize Locking покращує конкурентний доступ до даних без необхідності змінювати код застосунків.

    Ключові переваги:

    • Мінімізація ескалації блокувань

    • Менше конфліктів між незалежними транзакціями

    • Краща масштабованість у багатокористувацьких системах

    Також вирішено проблему lock-after-qualification, що ще більше зменшує конкурентні блокування.

    Розширена аналітика з Microsoft Fabric

    Інтеграція з Microsoft Fabric виводить аналітичні можливості SQL Server на новий рівень.

    Дзеркалювання без переміщення даних

    SQL Server 2025 дозволяє дзеркалювати бази даних у Fabric без міграції даних:

    • Реплікація в реальному часі

    • Підтримка локальних, хмарних і гібридних сценаріїв

    Міжсерверна аналітика

    Використовуючи Lakehouse shortcuts, можна:

    • Об’єднувати дані з кількох SQL Server

    • Працювати з ними як з єдиною схемою

    • Використовувати Copilot, Power BI та сервіси Fabric

    Усе це — без складних ETL-процесів.

    Як почати роботу з SQL Server 2025

    Найкращий спосіб оцінити нові можливості — почати користуватися вже зараз.

    SQL Server 2025 доступний у публічному прев’ю та готовий до встановлення на будь-яку підтримувану платформу.

    Висновок

    SQL Server 2025 — це не просто чергове оновлення, а суттєвий еволюційний крок.
    Вбудований ШІ, сучасні інструменти для розробників, покращена продуктивність і глибока інтеграція з аналітичними платформами роблять його потужною універсальною системою роботи з даними.

    Для розробників ШІ, систем реального часу та аналітичних рішень SQL Server 2025 уже сьогодні готовий стати надійною основою.

  • SQL Server 2025 став загальнодоступним (GA): корпоративна готовність до ШІ від on-prem до хмари

    Технологічна спільнота отримала важливу новину: SQL Server 2025 офіційно вийшов у статус General Availability (GA). Цей реліз чітко демонструє — SQL Server живий, активно розвивається та готовий до майбутнього, орієнтованого на корпоративні дані й навантаження зі штучним інтелектом.

    У нещодавно Боб Ворд розповів, чому цей реліз такий важливий, чим SQL Server 2025 відрізняється від попередніх версій і як Microsoft переосмислює роль баз даних в епоху ШІ.

    SQL Server не мертвий — він еволюціонує

    Вихід SQL Server 2025 підтверджує, що Microsoft і надалі активно інвестує в on-prem рішення, водночас пропонуючи потужні сценарії інтеграції з хмарою.

    Уперше версію було представлено у приватному прев’ю на Microsoft Ignite 2024 з чіткою обіцянкою — фінальний реліз до кінця 2025 календарного року. І цю обіцянку виконано.

    Ключове повідомлення SQL Server 2025 звучить просто, але переконливо:

    «AI-ready, але саме enterprise AI-ready».

    Це означає, що ШІ не просто «додали» до продукту. Його вбудовано з урахуванням вимог корпоративної безпеки, гнучкої архітектури та повного контролю — незалежно від того, чи працює SQL Server локально, у гібридному середовищі або з підключенням до хмари.

    Інновації від on-prem до хмари: гнучкість без компромісів

    SQL Server 2025 зосереджується на трьох ключових напрямах інновацій:

    1. ШІ всередині рушія бази даних

    Нові можливості ШІ тепер інтегровані безпосередньо в SQL Server, зокрема:

    • векторний пошук

    • семантичні запити

    • AI-ембедінги

    При цьому дані залишаються ізольованими та захищеними.

    2. Можливості для розробників

    Розробники отримують сучасні інструменти:

    • нативну підтримку JSON

    • виклики REST API безпосередньо з рушія SQL

    • розширені можливості T-SQL

    Це дозволяє застосункам працювати повністю локально або безпечно підключатися до хмарних сервісів.

    3. Інтеграція Fabric Mirroring

    SQL Server 2025 тісно інтегрується з Microsoft Fabric Mirroring, що дозволяє синхронізувати on-prem SQL-дані з Fabric буквально за кілька кліків. Це робить дані миттєво доступними для аналітики та Power BI, фактично розміщуючи SQL Server у «центрі всесвіту даних».

    Поліпшення рушія залишаються пріоритетом

    Хоча ШІ є головною темою релізу, Microsoft не забула про фундамент продукту. У SQL Server 2025 реалізовано:

    • понад 40 нових можливостей на рівні рушія

    • оптимізацію для сучасного апаратного забезпечення

    • підтримку Linux, контейнерів і Kubernetes

    • покращені бенчмарки та масштабованість

    • інтеграцію з Azure Arc та Entra Authentication

    Філософія залишається незмінною: без потужного рушія жодні інновації не мають сенсу.

    ШІ в SQL Server: безпека понад усе

    Одна з ключових особливостей підходу SQL Server 2025 — сувора модель безпеки.

    Основні принципи:

    • ШІ вимкнено за замовчуванням

    • адміністратор має явно дозволити використання ШІ

    • AI-моделі не отримують прямого доступу до SQL-даних

    • усі моделі ізольовані від рушія та працюють через REST API

    Для зберігання ембедінгів використовується новий векторний тип даних, що дозволяє виконувати інтелектуальний пошук без ризику витоку інформації.

    Векторний пошук і запити природною мовою

    SQL Server 2025 дозволяє:

    1. Описати AI-модель за допомогою T-SQL

    2. Згенерувати ембедінги з текстових даних

    3. Зберегти їх у векторних стовпцях

    4. Створити векторний індекс для швидкого пошуку

    5. Виконувати пошук за змістом, а не за ключовими словами

    Тепер запит на кшталт:

    «Знайди жовті велосипеди»

    може повертати релевантні результати навіть тоді, коли точні слова відсутні у даних.

    Багатомовний ШІ без переписування коду

    Один із найяскравіших моментів демонстрації — заміна AI-моделі для підтримки кількох мов.

    Достатньо:

    • змінити опис моделі

    • повторно згенерувати ембедінги

    • перебудувати векторний індекс

    І застосунок починає коректно працювати з кількома мовами — без жодних змін у коді, включно з підтримкою китайської мови.

    Інструменти, Copilot та досвід розробників

    Екосистема SQL Server 2025 також отримала помітні оновлення:

    • SQL Server Management Studio (SSMS) з підтримкою Copilot

    • аналіз векторів та ембедінгів природною мовою

    • безкоштовна Developer Edition

    • підтримка SQL Express і Standard Edition

    І все це — з використанням знайомого T-SQL, що значно зменшує поріг входу.

    Навчальні ресурси та підтримка спільноти

    Для швидкого старту Microsoft пропонує:

    • офіційну документацію

    • блоги та демо-матеріали

    • презентації для завантаження

    • безкоштовні версії для практики

    Також вийшла нова книга Боба Ворда:

    «SQL Server 2025 Unveiled» — глибокий технічний розбір ключових можливостей і архітектурних рішень SQL Server 2025.

    Підсумок

    SQL Server 2025 — це не просто оновлення бази даних. Це стратегічна заява про майбутнє корпоративних даних:

    • орієнтація на ШІ без компромісів із безпекою

    • гнучкість між on-prem і хмарою

    • підтримка сучасних workload’ів

    • потужний, перевірений часом реляційний рушій

    Для досвідчених DBA та розробників, а також для тих, хто тільки починає знайомство з інтелектуальними базами даних, SQL Server 2025 — це серйозний крок уперед.

  • Чому CI-пайплайн є необхідним у сучасній розробці програмного забезпечення

    У сучасній розробці програмного забезпечення надзвичайно важливо розуміти, навіщо потрібен пайплайн безперервної інтеграції (Continuous Integration, CI) та як його побудувати так, щоб він автоматично перевіряв якість коду застосунку і навіть пропонував виправлення для виявлених проблем. Для розробників програмного забезпечення, особливо тих, хто працює на інженерних посадах, ці знання є вкрай цінними та безпосередньо застосовуються в щоденній роботі.

    Уявімо, що ви працюєте в команді розробників над певною функціональністю. Команда використовує Git-workflow під назвою trunk-based development, який є стандартним підходом у багатьох DevOps-орієнтованих середовищах. За такого підходу основна гілка завжди підтримується у стані, готовому до релізу. Будь-яка зміна коду, відправлена в основну гілку, автоматично запускає CI/CD-пайплайн.

    Цей пайплайн є повністю автоматизованим і не містить вузьких місць, тобто на жодному етапі не потрібне ручне втручання. Код автоматично збирається, тестується та розгортається щонайменше в середовищі розробки. За умови хорошого покриття тестами розгортання може доходити до staging-середовища або навіть production без ручного тестування чи перевірок коду. Проте для надійної роботи такої схеми необхідна велика кількість автоматизованих тестів, які гарантують, що все, що потрапляє в основну гілку, безпечно випускати для кінцевих користувачів.

    Типи тестів у релізному пайплайні

    Надійний релізний пайплайн містить кілька типів тестів, кожен з яких перевіряє окремий аспект коду:

    • Модульні та інтеграційні тести, які перевіряють бізнес-логіку коду з різними вхідними даними та сценаріями.

    • Тести безпеки, що сканують залежності та бібліотеки на відомі вразливості, виявляють жорстко закодовані секрети та перевіряють дотримання кращих практик безпеки в логіці застосунку.

    • Тести якості коду, які оцінюють не функціональність і не безпеку, а зручність супроводу та чистоту коду.

    Навіть якщо застосунок працює коректно та є безпечним, погана якість коду може призвести до серйозних проблем у майбутньому. Типові приклади — дублювання коду замість винесення логіки у функції, використання застарілих бібліотек або API, ризик виникнення null-pointer винятків у Java-застосунках чи недостатнє покриття тестами. Саме такі проблеми і виявляють перевірки якості коду.

    Git-workflow та важливість раннього тестування

    Хоча trunk-based development часто вважається ідеальним підходом, на практиці багато команд використовують workflow з feature-гілками. У такому підході вся розробка функціональності відбувається в окремих гілках, а не безпосередньо в основній. Розробники створюють feature-гілку, працюють у ній ізольовано, а потім створюють merge request.

    Merge request виконує роль «фільтра»: всі автоматизовані тести запускаються до злиття з основною гілкою та визначають, чи перебуває код у стані, готовому до релізу. Це критично важливо, оскільки якщо проблемний код потрапить в основну гілку, він може заблокувати роботу всієї команди. Навіть якщо інші розробники виправлять власні помилки, реліз буде неможливим, доки не усунуть початкову проблему.

    Однак тестування лише на рівні merge request має свої недоліки. Якщо у feature-гілці накопичилося багато комітів, проблеми можуть бути виявлені занадто пізно. Їх виправлення може зайняти години або навіть дні, особливо якщо код із самого початку був побудований на основі застарілих або небезпечних бібліотек.

    Безперервна інтеграція та цикл зворотного зв’язку

    Саме тут з’являється безперервна інтеграція (CI). CI — це практика частих комітів невеликих змін коду з автоматичним запуском тестів для кожного коміту. Такий підхід створює швидкий цикл зворотного зв’язку та дозволяє виправляти проблеми одразу після їх появи.

    Наприклад, розробник додає нову бібліотеку та робить коміт. CI-пайплайн одразу виявляє, що з цією бібліотекою пов’язані проблеми. Розробник може негайно виправити ситуацію і рухатися далі. Для junior-інженерів це особливо корисно, оскільки вони навчаються кращих практик програмування завдяки постійному зворотному зв’язку.

    CI-пайплайни для feature-гілок не містять етапів розгортання — вони призначені виключно для тестування. З часом тестування зсувається все раніше в процесі розробки, що відомо як концепція shift-left testing.

    Локальні перевірки коду та необхідність централізованої автоматизації

    Деякі проблеми коду можна виявити ще до запуску CI. Сучасні IDE, такі як IntelliJ IDEA, мають вбудовані інспекції, які підсвічують дублювання коду, потенційні помилки та можливості для покращення безпосередньо під час написання коду. Часто вони також пропонують автоматичні виправлення, наприклад оновлення версії бібліотеки або рефакторинг логіки.

    Однак розробники можуть ігнорувати ці підказки або не знати, як ними користуватися. Саме тому не можна покладатися лише на особисту уважність окремих членів команди. Централізовані автоматизовані перевірки в CI-пайплайнах забезпечують сталі стандарти якості для всього проєкту.

    Кілька рівнів контролю якості коду

    Зазвичай перевірки якості коду виконуються на кількох рівнях:

    1. Локально в IDE розробника

    2. У CI-пайплайні feature-гілки

    3. У пайплайні merge request

    4. Після злиття коду в основну гілку

    Такий багаторівневий підхід гарантує, що проблеми, спричинені взаємодією змін від різних розробників, будуть виявлені якомога раніше.

    Побудова CI-пайплайна для перевірки якості коду

    Після усвідомлення важливості CI наступним кроком стає створення пайплайна для автоматизованих перевірок якості коду. У цьому прикладі використовується GitHub Actions як CI-сервер та Kodana, інструмент від JetBrains, для аналізу коду.

    Kodana використовує той самий механізм інспекцій, що й IDE JetBrains. Він сканує код, знаходить проблеми та пропонує виправлення, але робить це централізовано в межах CI-пайплайна. Інструмент підтримує багато популярних мов програмування, зокрема Java, JavaScript, Python, PHP та інші, що позбавляє потреби використовувати різні інструменти для кожної мови.

    Для налаштування потрібно лише два кроки:

    1. Створити workflow GitHub Actions для CI-пайплайна

    2. Створити конфігураційний файл kodana.yml, який визначає правила аналізу

    Завдяки інтеграції з IDE обидва файли можуть бути згенеровані автоматично, що суттєво спрощує старт.

    Інтеграція Kodana з GitHub Actions

    CI-workflow налаштовується так, щоб запускатися при кожному pull request до основної гілки. Він містить два ключові кроки:

    • отримання вихідного коду репозиторію

    • запуск аналізу Kodana за допомогою спеціального action

    Для зручної візуалізації результатів пайплайн підключається до Kodana Cloud, який надає веб-інтерфейс із детальними даними про знайдені проблеми, рівні їхньої серйозності та файли, у яких вони виникли.

    Аналіз і керування результатами перевірок

    Після завершення виконання пайплайна результати доступні в кількох місцях:

    • безпосередньо в інтерфейсі GitHub Actions

    • у Kodana Cloud з можливістю детальної фільтрації та сортування

    Розробники можуть розглядати кожну проблему окремо, зосереджуватися на помилках із високим рівнем критичності та точно розуміти їх походження.

    Автоматичне виправлення коду в CI-пайплайні

    Kodana також підтримує автоматичне виправлення проблем. У разі ввімкнення цієї функції CI-пайплайн самостійно застосовує запропоновані виправлення та створює pull request із зміненим кодом. Серед прикладів таких виправлень:

    • видалення зайвого або невикористовуваного коду

    • додавання перевірок на null

    • інтеграція бібліотек на кшталт Lombok

    • усунення дублювання бізнес-логіки

    Такі pull request можна перевірити та об’єднати вручну, зберігаючи повний контроль над змінами.

    Підтримка якості коду в довгостроковій перспективі

    Усі результати сканувань зберігаються з часом, формуючи історію, за якою можна відслідковувати тенденції — чи покращується якість коду, чи навпаки погіршується. Це особливо корисно для великих команд із різним рівнем досвіду розробників.

    Висновок

    Добре спроєктований CI-пайплайн є невід’ємною частиною сучасної розробки програмного забезпечення. Інтеграція автоматизованих перевірок якості коду в CI-workflow забезпечує ранній зворотний зв’язок, зменшує технічний борг і запобігає потраплянню проблем у production.

    Централізована автоматизація зменшує потребу в ручних перевірках, знижує навантаження на senior-інженерів і допомагає всій команді писати чистіший, стабільніший та легший у підтримці код. Зрештою, CI-пайплайни з перевірками якості стають основою надійних, масштабованих і професійних DevOps-процесів.

  • ШІ в DevOps та Cloud: Повний огляд інструментів, сценаріїв використання та реальності

    ШІ в DevOps та Cloud: Повний огляд інструментів, сценаріїв використання та реальності

    Штучний інтелект (ШІ) зараз є, безперечно, найбільш обговорюваною темою у світі технологій. Інструменти на базі ШІ розробляються для кожної сфери, включаючи різні напрямки IT. У специфічному контексті світів DevOps та Cloud (хмарних технологій) важливо вийти за межі хайпу і розглянути, як ці інструменти функціонують на практиці.

    Замість того щоб просто порівнювати випадкові популярні ШІ-інструменти, ця стаття зосереджується на конкретних категоріях — таких як моніторинг, покращення безпеки та управління ресурсами — щоб надати структурований огляд. Наведені тут інсайти базуються на чесному, практичному досвіді використання цих інструментів у реальних DevOps-проектах, відображаючи як їхній потенціал, так і поточні обмеження. Як завжди, філософія залишається незмінною: «концепції важливіші за інструменти», тому наведені приклади ілюструють ширші інженерні принципи.
    Обіцянки проти реальності ШІ в DevOps

    DevOps — це насамперед автоматизація та ефективність. Незалежно від того, чи є метою швидкий випуск нової функції, захист інфраструктури або моніторинг платформи для запобігання збоям, завдання полягає в автоматизації цих процесів.

    Уявіть сценарій, де ШІ бере на себе нудні, повторювані завдання, допомагає автоматизувати робочі процеси та асистує інженерам у прийнятті рішень на основі даних. Це бачення включає надшвидку валідацію коду, проактивну підтримку хмарної інфраструктури або кластерів Kubernetes, автоматичне виявлення загроз безпеці та миттєве реагування на інциденти — і все це завдяки силі ШІ.

    Якщо це звучить занадто добре, щоб бути правдою, то це тому, що на даний момент це значною мірою так і є. Більшість інструментів ШІ ще недостатньо зрілі, щоб використовувати їх на «автопілоті». Їх потрібно використовувати як будь-який інший інструмент: вони не можуть робити все автоматично, і багато з них все ще вимагають значної перевірки та валідації з боку людини. Однак це не робить їх марними. Вже зараз існують переконливі сценарії використання ШІ-інструментів.

    Хоча інструменти загального призначення, такі як ChatGPT, добре відомі всім, вони мають обмеження при застосуванні до специфічних, складних інтеграцій, необхідних у DevOps. DevOps передбачає інтеграцію різноманітних інструментів для побудови автоматизованих процесів — таких як автоматизація моніторингу, сповіщення команд про аномальну поведінку, виявлення проблем безпеки та провіжинінг інфраструктури.

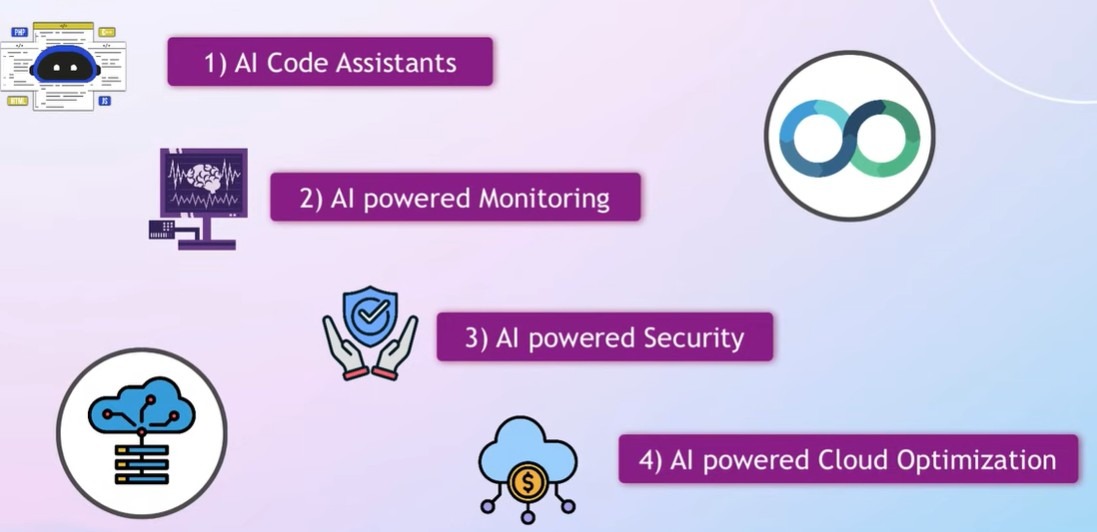
    Ось ключові категорії, де ШІ справляє вплив у просторі DevOps та Cloud.

    1. ІІ-асистенти для написання коду

    Основним сценарієм використання ШІ-асистентів у цій сфері є написання «Інфраструктури як код» (IaC), конфігураційних файлів та скриптів.

    Популярним прикладом є GitHub Copilot, а також подібні інструменти, такі як Amazon Q. Ці інструменти функціонують як асистенти всередині вашого редактора коду або IDE, пропонуючи:

    • Пропозиції та автодоповнення коду: Передбачення того, що ви хочете написати, на основі поточного контексту.

    • Перетворення природної мови в код: Ви можете описати логіку простою англійською мовою, і інструмент згенерує відповідний блок коду.

    • Рефакторинг: Можливість попросити асистента очистити «брудний» код або знайти дублювання.

    • Пояснення коду: Це особливо цікавий сценарій для навчання. Наприклад, джуніор-інженер, який намагається розібратися у складній кодовій базі Terraform, може використовувати ШІ-асистента для пояснення логіки, ефективно використовуючи інструмент для підвищення кваліфікації.

    Обмеження

    Виходячи з практичного досвіду в DevOps-проектах, код, згенерований цими асистентами, зазвичай не є повністю готовим до використання «з коробки». Вам все одно потрібно перевіряти результат, а в багатьох випадках — виправляти його, оскільки запропонований код просто не працює. Звірка з офіційною документацією залишається необхідною.

    Інтеграція з IDE проти AI-Native редакторів

    Асистенти найбільш корисні, коли вони інтегровані безпосередньо в редактор коду (наприклад, Visual Studio Code або IntelliJ), що позбавляє необхідності перемикатися між редактором і браузером. Цікаво відзначити зростання популярності редакторів на базі ШІ, таких як Cursor, де ШІ інтегрований у сам редактор, а не просто працює як плагін. Перевага тут полягає в тому, що редактор може краще розуміти весь контекст проекту, пропонуючи точніші пропозиції та відповіді.

    2. Моніторинг на базі ШІ

    Ця категорія, можливо, пропонує більшу миттєву цінність для DevOps, ніж генерація коду. Моніторинг у хмарі та DevOps є складним і має бути автоматизованим. Коли мова йде про системи, що складаються з тисяч серверів і десятків тисяч компонентів, ручна спостережуваність (observability) є неможливою.

    Автоматизований моніторинг та сповіщення (alerting) є важливими для проактивного виявлення аномальної поведінки. Однак налаштування цих сповіщень саме по собі є складним завданням.

    Глибокий аналіз та прогнозна аналітика

    Такі інструменти, як DataDog Watchdog, використовують машинне навчання для вирішення цієї складності. Вони діють як вбудований інтелектуальний шар, який безперервно аналізує мільярди точок даних з інфраструктури та додатків.

    • Аналіз першопричин (Root Cause Analysis): Після виявлення проблеми пошук несправностей може зайняти багато часу. Аналізуючи дані про те, як сервіси з’єднуються та корелюють між собою, ШІ може точно вказати, який саме компонент серед тисяч спричинив помилку, заощаджуючи інженерам значні зусилля.

    • Прогнозна аналітика: Аналізуючи історичні дані та тренди, ці інструменти можуть виявляти потенційні проблеми до того, як вони виникнуть, переходячи від реактивного до проактивного обслуговування. Це використовує справжню силу ШІ: аналіз масивних наборів даних для пошуку кореляцій, які люди можуть пропустити.

    3. Оптимізація CI/CD пайплайнів

    CI/CD пайплайни (конвеєри) — це серце автоматизації DevOps. Інструменти в цьому просторі все частіше використовують ШІ для фокусування на продуктивності розробників та оптимізації робочих процесів.

    TeamCity Pipelines від JetBrains є прикладом інструменту, що фокусується на цій області через пайплайни, що самоналаштовуються (Self-Tuning Pipelines).

    • Вбудована оптимізація: Поки ви будуєте та налаштовуєте пайплайн, платформа надає інтелектуальні пропозиції щодо його оптимізації — наприклад, додавання кешування або паралельний запуск завдань (jobs) для прискорення виконання. Це усуває необхідність постійно перемикатися на документацію.

    • Configuration as Code: Для інженерів, які віддають перевагу скриптам, а не налаштуванням через UI, сучасні інструменти дозволяють налаштувати пайплайн через інтерфейс, використовуючи ці інтелектуальні пропозиції, а потім зберегти конфігурацію, що автоматично генерує YAML-код у вашому Git-репозиторії. Це поєднує зручність використання та найкращу практику «Everything as Code» (Все як код).

    4. Безпека (DevSecOps)

    Безпека — це ще одна критична сфера, де ШІ може допомогти запобігти проблемам до їх виникнення, виявляючи вразливості на основі статистичних даних або аномальної поведінки. Деякі інструменти навіть дозволяють використовувати «автовиправлення» (auto-fixes), де система автоматично виявляє та виправляє неправильну конфігурацію.

    Sysdig є відомим інструментом у цій категорії. Подібно до інструментів моніторингу, він використовує машинне навчання для проактивного аналізу, але з фокусом на безпеку, особливо в контейнеризованих середовищах.

    Виклик масштабу

    У сучасному DevOps контейнери є стандартом. Середовище може запускати тисячі контейнерів у різних системах. Гарантувати, що кожен окремий контейнер і сервіс є безпечним, правильно налаштованим і вільним від вразливостей, вручну неможливо.

    Як допомагає ШІ

    • Виявлення та аналіз: Інструменти на кшталт Sysdig автоматично сканують середовище, щоб виділити потенційні загрози.

    • Візуалізація шляху атаки: Вони можуть візуалізувати конкретний шлях, який зловмисник пройшов би від точки входу до конфіденційних даних.

    • Першопричина проблем безпеки: Так само як і з операційним моніторингом, ідентифікація джерела порушення безпеки є складною. ШІ-інструменти спрощують процес усунення несправностей, повідомляючи вам точно, звідки походить проблема і як її виправити.

    Безпека ШІ-навантажень (AI Workload Security)

    Новою та життєво важливою функцією є безпека саме для ШІ-навантажень. Було помічено, що значний відсоток генеративних ШІ-навантажень, що працюють у кластерах Kubernetes, є публічно доступними. Інструменти зараз розробляють функції для моніторингу безпеки самих моделей ШІ, гарантуючи, що вони не «зливають» конфіденційні дані під час зовнішніх взаємодій.

    5. Управління ресурсами та витратами (FinOps)

    Ефективне управління ресурсами та економія витрат є великим викликом, особливо коли додатки масштабуються та використовують мультихмарні (multi-cloud) середовища.

    ШІ-інструменти, такі як CloudHealth, Usage AI та Cast AI, надають огляд ефективності інфраструктури та пропонують дієві рекомендації.

    • Оптимізація: Вони визначають, які інстанси недовантажені або взагалі не використовуються.

    • Right-Sizing (Підбір розміру): Вони рекомендують конкретні типи або розміри інстансів для оптимізації продуктивності та вартості.

    • Прогнозне масштабування: Використовуючи прогнозний аналіз патернів використання, ці інструменти можуть передбачити, скільки інфраструктури знадобиться в майбутньому. Це допомагає динамічно масштабувати середовища, щоб уникнути плати за непотрібні ресурси.

    • Підтримка мультихмарності: Оскільки багато складних додатків працюють у мультихмарних середовищах, наявність єдиного огляду навантажень у різних провайдерів є критично важливою.

    Висновок

    Це найбільш значущі на сьогодні сценарії використання ШІ в DevOps та Cloud.

    Незважаючи на хайп, інструменти ШІ поки що недостатньо зрілі, щоб виконати амбітну обіцянку, згідно з якою інженери фокусуються виключно на високорівневій логіці, поки ШІ виконує всю важку технічну роботу. Ця реальність ще не настала. На даний момент це просто ще один набір інструментів, який вимагає технічної експертизи для ефективного використання. Фундаментальні знання концепцій та технологій DevOps залишаються необхідними; ШІ не може замінити цю експертизу.

    Однак у таких сценаріях, як автоматизований моніторинг, безпека та управління ресурсами — де величезний обсяг даних та компонентів перевищує можливості людського сприйняття — інструменти ШІ можуть суттєво підвищити продуктивність. Вони економлять час на пошуку несправностей та аналізі даних, дозволяючи інженерам зосередитися на більш складних та цінних інженерних завданнях.
  • Що таке Nginx, навіщо його створили й як він використовується — з прикладами з реального життя

    Що таке Nginx, навіщо його створили й як він використовується — з прикладами з реального життя

    Наприкінці цієї статті ти зрозумієш не лише, що таке Nginx, а й чому він з’явився, для чого потрібен і як працює на практиці — з наочними прикладами, які нарешті все розкладуть по поличках.

    Коли веб був простим

    На початку розвитку інтернету все було доволі просто. Менше користувачів, менше сайтів, менше хаосу.
    Браузер надсилав запит на сторінку одному вебсерверу. Сервер був звичайною машиною, на яку встановлювали спеціальне програмне забезпечення — воно збирало вебсторінку та повертало її назад у браузер, який показував сторінку користувачу.

    І це саме ПЗ, що працювало на сервері й відповідало на HTTP-запити, —
    так, це і був Nginx. Серверна програма, створена для обробки запитів браузера.

    А потім веб став популярним (і почалися проблеми)

    У якийсь момент сайти почали отримувати не сотні запитів, а тисячі або мільйони.

    Уяви один сервер, який має обслужити мільйони запитів.
    Нереально. Це далеко за межами можливостей однієї машини.

    Що зробили?
    Додали більше серверів. Наприклад, десять серверів з Nginx.

    Але одразу виникло нове питання: як розподіляти запити між усіма цими серверами?

    І тут з’являється балансування навантаження.

    Nginx як балансувальник навантаження (той самий “консьєрж”)

    Nginx може працювати не лише як вебсервер, а й як проксі-сервер, який розподіляє вхідні запити між декількома бекенд-серверами.

    Проксі — це, по суті, “робити щось від імені когось”.
    Nginx приймає запити браузерів від імені серверів, що стоять за ним, і перенаправляє їх туди, де є вільні ресурси.

    Наче консьєрж у готелі, який вирішує, в який номер поселити гостя.

    Як Nginx розподіляє навантаження

    Залежить від вибраного алгоритму:

    • Least Connections — запит передається серверу з найменшим навантаженням.

    • Round Robin — класичний підхід: кожен сервер отримує запит по черзі, по колу.

    Просто — але дуже ефективно.

    На цьому етапі Nginx уже вміє бути:

    1. Вебсервером,

    2. Проксі / балансувальником навантаження.

    Технологія одна, завдання різні.

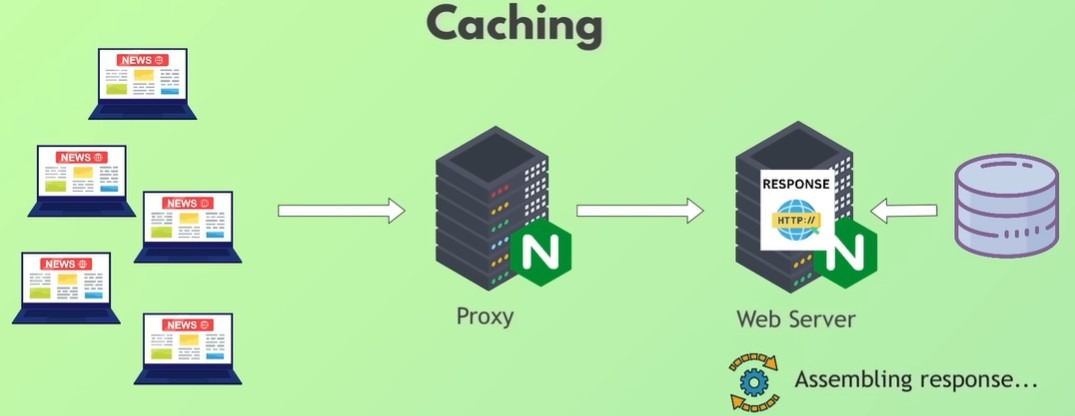
    Кешування: як обслужити мільйони запитів і не впасти

    Уяви: New York Times публікує нову статтю. Мільйони людей відкривають її одночасно.

    Якби кожен запит змушував бекенд знову:

    • тягнути зображення,

    • робити запити до бази даних,

    • збирати HTML,

    • формувати посилання,

    • надсилати відповідь…

    …мільйон разів — сервери просто б лягли.

    Правильний підхід?
    Один раз зібрати статтю, зберегти фінальну версію й роздавати її всім.

    Це кешування — одна з ключових функцій Nginx.
    Воно рятує базу даних і сервери від постійного навантаження.

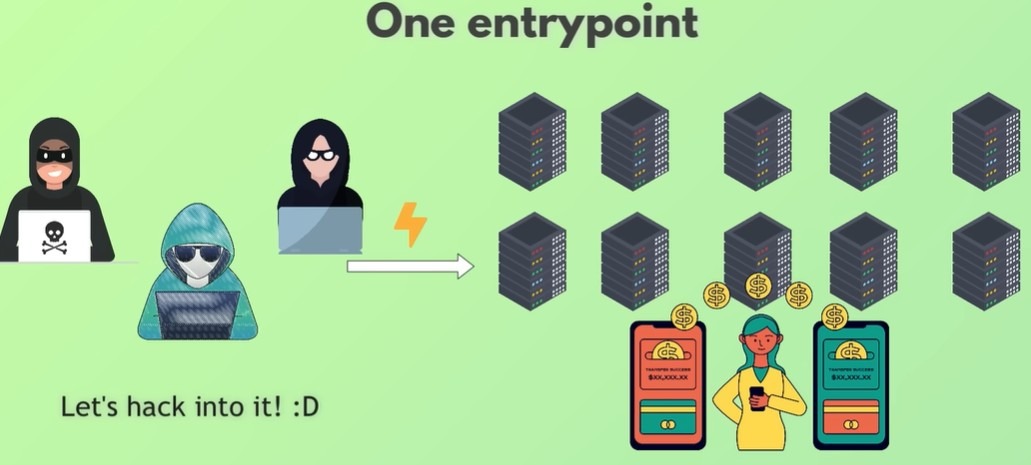
    Безпека: зменшення поверхні атаки

    Тепер уяви інтернет-банк або соцмережу на кшталт Facebook, де працює 100 серверів.

    Це жирна ціль для хакерів.

    Якщо зробити усі ці 100 серверів публічно доступними, стає дуже небезпечно.
    Хакеру потрібна лише одна вразливість в одному сервері — і він отримає доступ до всієї системи.

    Рішення?

    Публічним роблять тільки Nginx-проксі, а всі бекенд-сервери ховають за ним.

    Тепер потрібно захищати один сервер, а не сотню.
    Поверхня атаки зменшується в рази.

    Nginx стає щитом — захисним шаром між інтернетом та твоєю інфраструктурою.

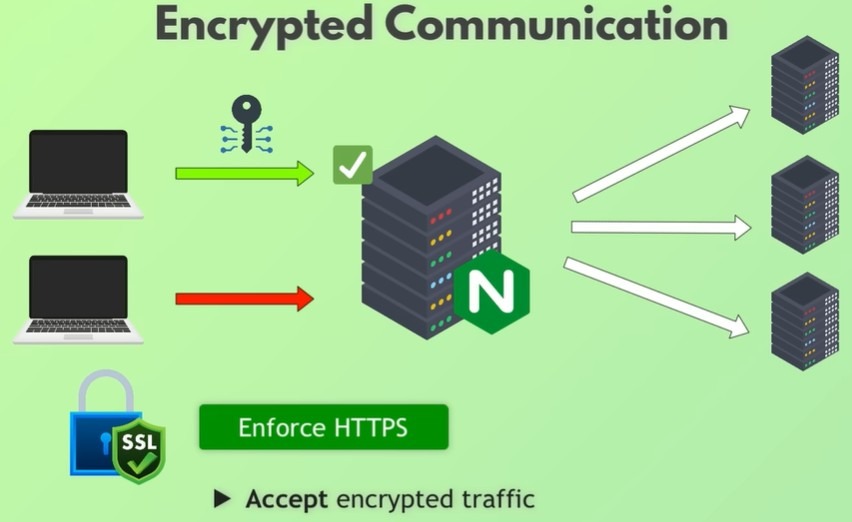
    Шифрування: HTTPS і строгі вимоги безпеки

    Раз у нас лише одна публічна точка входу, ми можемо змусити її приймати лише зашифрований трафік.

    Браузер надсилає зашифровані дані → Nginx приймає їх.
    Навіть якщо хтось перехопить трафік, прочитати його неможливо.

    У різних системах реалізація буває різною:

    • інколи Nginx сам розшифровує запити,

    • інколи просто пересилає їх далі у зашифрованому вигляді — це ще безпечніше.

    Nginx легко налаштувати так, щоб він повністю блокував незашифрований трафік.

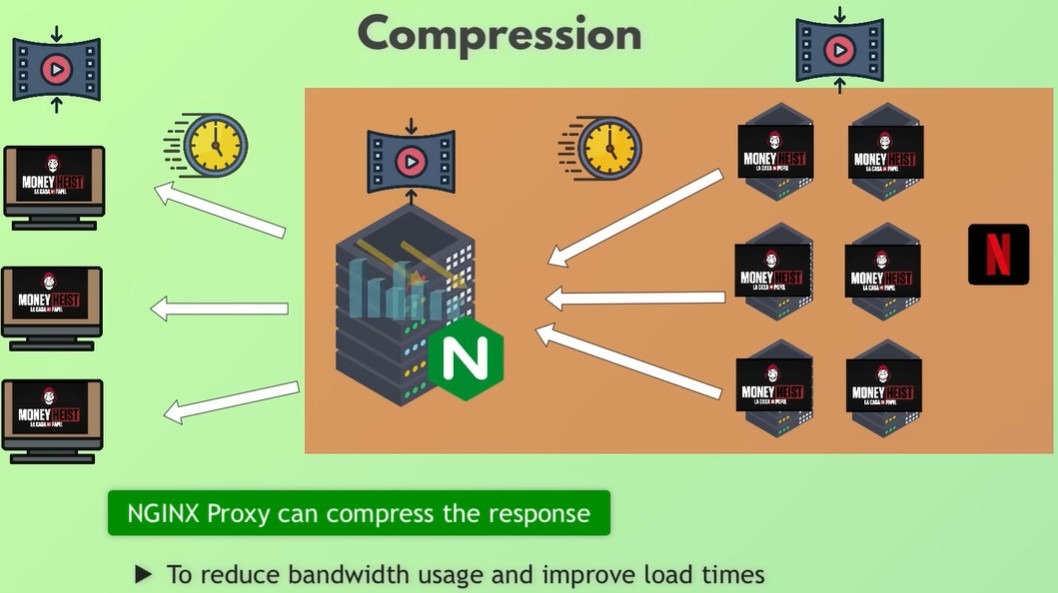
    Стиснення: уяви Netflix ввечері

    До речі, Netflix дійсно використовує Nginx.

    Уяви вечір у Нью-Йорку. Виходить нова серія популярного серіалу. Мільйони людей вмикають Netflix одночасно.

    Nginx має надіслати величезні відеофайли мільйонам користувачів.
    Це колосальне навантаження на канали зв’язку.

    Рішення? Стиснення.

    Nginx може стискати:

    • великі зображення,

    • відеофрагменти,

    • інші важкі файли

    Це економить трафік і прискорює доставку.

    Плюс — Nginx може надсилати файли частинами, щоб користувач міг почати дивитися відео, поки інша частина ще завантажується.

    Конфігурація Nginx: як він розуміє, що робити

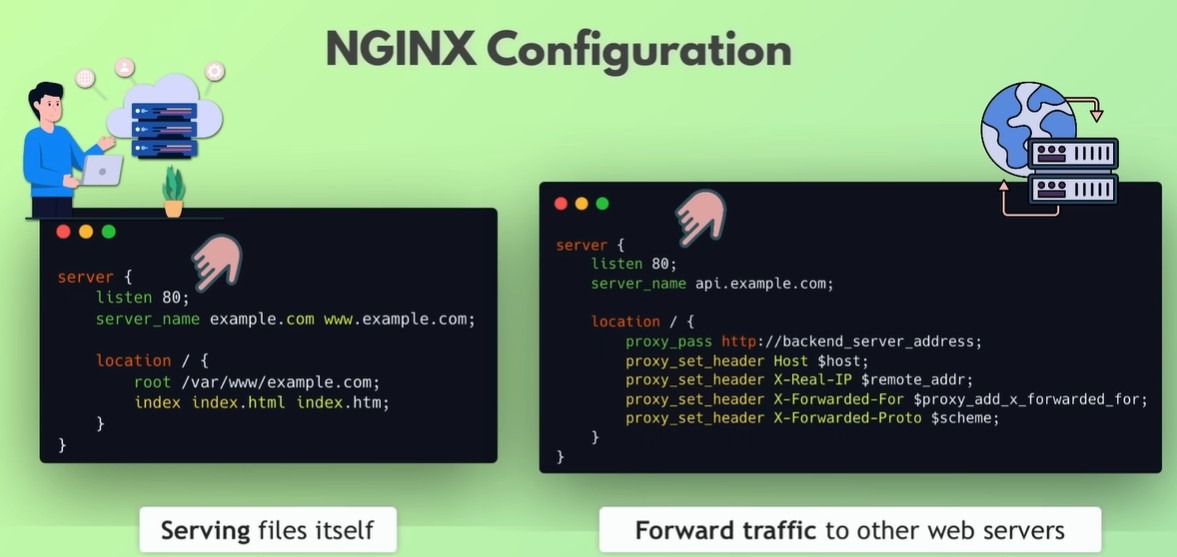
    Уся магія Nginx налаштовується через конфігураційний файл із директивами:

    • у якому режимі працювати — вебсервер або проксі,

    • які порти використовувати,

    • де зберігати кеш,

    • де лежать SSL-сертифікати,

    • куди перенаправляти трафік,

    • як балансувати навантаження,

    • які файли віддавати,

    • які маршрути обробляти…

    Приклади налаштувань:

    • звичайний вебсервер на порту 80,

    • редирект HTTP→HTTPS,

    • HTTPS-сервер на порту 443 із сертифікатами,

    • балансування навантаження між кількома бекенд-серверами,

    • параметри кешування з TTL.

    Конфігурація гнучка, детальна й проста — саме тому Nginx став таким популярним.

    Nginx у світі контейнерів: Kubernetes Ingress Controller

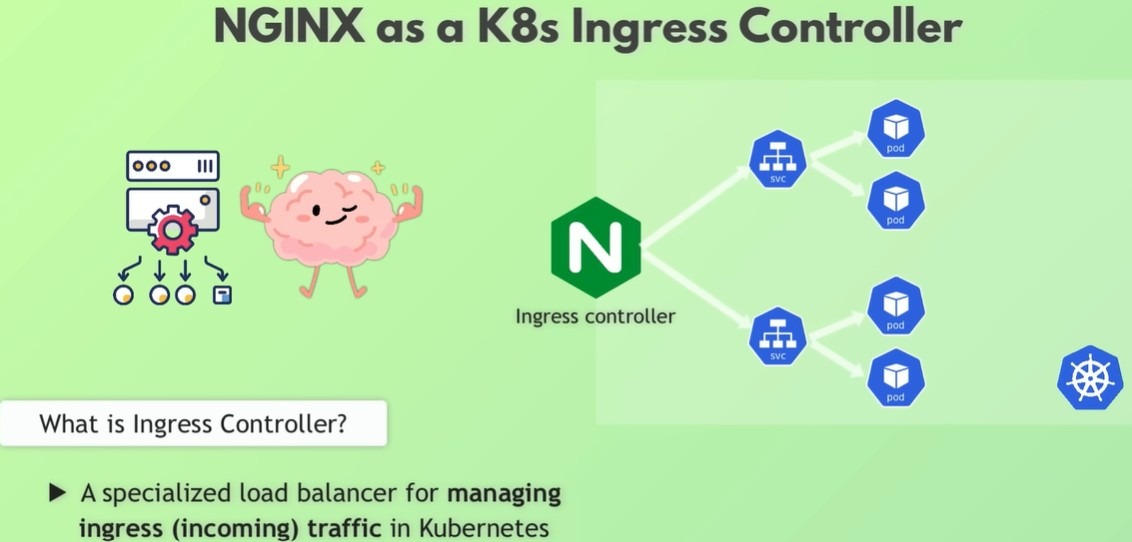
    Сьогодні Nginx — ключовий елемент екосистеми Kubernetes.

    У Kubernetes Nginx часто використовується як Ingress Controller — фактично, проксі та балансувальник усередині кластера.

    Принцип той самий:

    • отримує запити першим,

    • вирішує, куди їх скерувати,

    • маршрутизує за правилами.

    Наприклад:

    • /cart → сервіс кошика

    • /payment → сервіс платежів

    • /profile → сервіс профілю

    Публічний трафік приймає не Nginx, а хмарний балансувальник (наприклад, AWS ELB).
    Він пересилає запити всередину кластера до Nginx Ingress — це додає додатковий рівень безпеки.

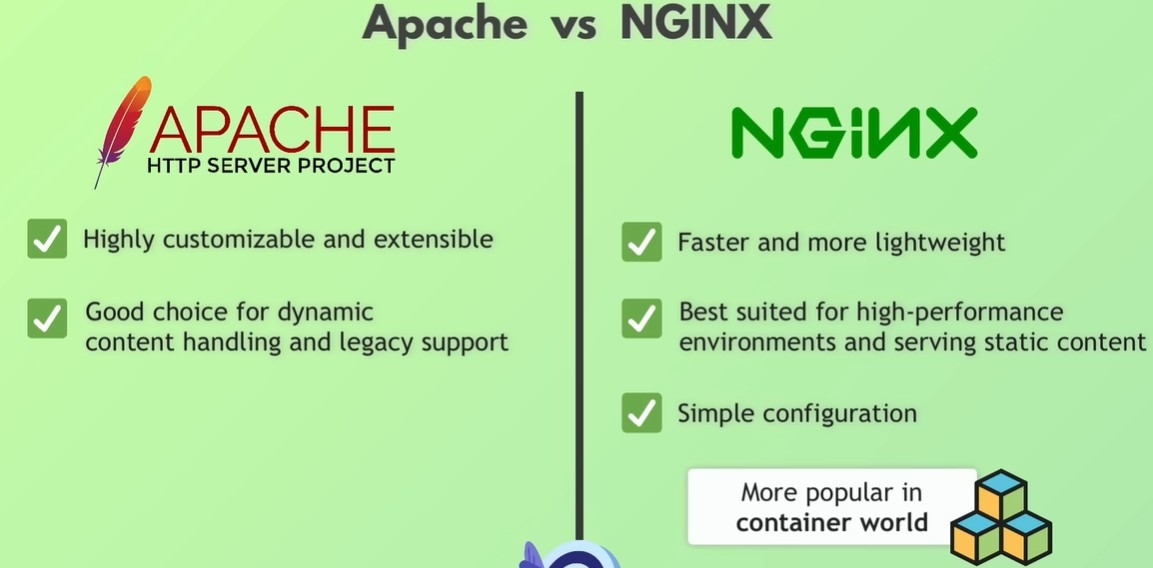
    А як же Apache? У чому різниця?

    Apache був стандартом до появи Nginx. Він умів робити все те саме.

    Але Nginx переміг завдяки:

    • швидкості,

    • легкості,

    • ефективності зі статикою,

    • простим конфігураціям,

    • популярності у контейнерах.

    Тому сьогодні Nginx — де-факто стандарт для високонавантажених систем.

    Підсумок

    Тепер у тебе є повна картина того, що таке Nginx:

    • вебсервер,

    • проксі,

    • балансувальник навантаження,

    • система кешування,

    • захисний шар,

    • компресор даних,

    • Kubernetes Ingress Controller.

    Усе це — в одному швидкому й потужному інструменті.

  • Проксі, зворотні проксі та балансувальники навантаження: просте пояснення того, як інтернет витримує величезний трафік

    Чи замислювалися ви, як найбільші сайти одночасно обслуговують мільйони користувачів і при цьому не падають? Або як ваші дані передаються безпечно та потрапляють саме на той сервер, який вам потрібен?

    Давайте розберемося у трьох ключових компонентах сучасної веб-інфраструктури: проксі, зворотні проксі та балансувальники навантаження.

    Навіть якщо ви не інженер, розуміння цих речей допоможе побачити, як інтернет працює “за лаштунками”.

    Forward Proxy: ваш особистий інтернет-асистент

    Уявіть, що ви йдете на вечерю в популярний ресторан, але не хочете спілкуватися з персоналом — соромитеся, втомилися або просто не маєте бажання. Тому у вас є особистий помічник, який робить бронювання за вас. Ресторан спілкується лише з ним, а не з вами.

    У цій аналогії:

    • Ви = ваш ноутбук

    • Помічник = proxy-сервер

    • Ресторан = сайти в інтернеті

    Проксі стоїть між вашою приватною мережею та публічним інтернетом. Він фільтрує трафік, блокує шкідливі сайти, скрипти та код, перш ніж вони потраплять до вас.

    Чому компаніям forward-proxy потрібен ще більше

    У корпоративному середовищі ризики значно вищі. Працівники заходять на різні сайти — інколи безпечні, інколи сумнівні. Якщо, наприклад, маркетолог завантажить файл зі схованим вірусом, шкідливий код може проникнути у мережу компанії та завдати серйозної шкоди.

    Forward-proxy допомагає цьому запобігти, виконуючи:

    • фільтрацію запитів

    • блокування небажаних сайтів

    • сканування відповідей на віруси

    • журналювання активності

    • кешування відповідей

    Наприклад, якщо один інженер переглянув навчальний матеріал і проксі його закешував, наступні 10 інженерів отримають копію з кешу — без повторного завантаження.

    Такий тип проксі називають forward proxy.

    Reverse Proxy: адміністратор, який зустрічає вхідні запити

    Повернімося до ресторану. Ви приходите та підходите до стійки адміністратора. Він розсаджує гостей по столиках, щоб забезпечити правильний потік.

    Цей адміністратор = reverse proxy.

    Зворотний проксі стоїть перед серверами й керує вхідними запитами. Він визначає, який сервер має обробити конкретний запит. Це розподілення трафіку називається балансуванням навантаження, але це лише одна з його можливостей.

    Що вміє reverse proxy

    Він може:

    • розподіляти трафік між серверами

    • приховувати сервери від зовнішнього світу

    • забезпечувати SSL/TLS-шифрування

    • перевіряти запити на загрози

    • кешувати контент

    • вести логи для діагностики

    Один із найпопулярніших зворотних проксі — Nginx.

    Балансування навантаження — лише одна суперздібність зворотного проксі

    Легко переплутати зворотний проксі та балансувальник навантаження. Але ключ у тому, що:
    балансування — лише одна з функцій reverse proxy.

    Повертаючись до ресторану:
    Адміністратор може враховувати вподобання постійних гостей, вибирати столики з кращим видом, пропонувати відповідне меню — тобто ухвалювати розумні рішення, а не просто “перший вільний”.

    Облачний балансувальник vs. зворотний проксі: чи потрібні обидва?

    Поширене питання:
    «Якщо в AWS, Azure або GCP вже є балансувальники, навіщо мені Nginx?»

    Коротка відповідь: потрібні обидва.

    Чому так?

    Типова архітектура виглядає так:

    • Облачний балансувальник — точка входу з інтернету

    • Reverse proxy — інтелектуальна маршрутизація всередині мережі серверів

    Такий підхід:

    • підвищує масштабованість

    • покращує безпеку

    • дає значно більшу гнучкість

    Відмінності у маршрутизації

    Облачні балансувальники працюють за простими алгоритмами:

    • round robin

    • least connections

    Reverse proxy дозволяє маршрутизувати на основі:

    • cookies

    • заголовків

    • сесій

    • шляхів URL

    • user affinity (усі запити користувача → один сервер)

    Він може виконувати SSL/TLS-термінацію і аналізувати трафік до того, як він потрапить у сервіси — це критично для мікросервісної архітектури.

    Аналогія з рестораном

    Облачний балансувальник — це швейцар біля дверей.
    Reverse proxy — адміністратор, який знає гостей і їхні уподобання.

    Приклад у Kubernetes: Ingress + Load Balancer

    У Kubernetes:

    • Cloud Load Balancer приймає зовнішній трафік

    • Ingress Controller (reverse proxy) маршрутизує його всередині кластера

    Та сама дворівнева логіка.

    А як щодо серверів, що запускаються автоматично в Node.js або Java?

    Коли ви запускаєте застосунок Node.js чи Java, вмикається невеликий вбудований HTTP-сервер. Це не повноцінний зворотний проксі, а просто базовий сервер для обробки запитів.

    На прикладі Node.js

    Node.js не містить reverse proxy “з коробки”, але ви можете створити його самостійно через:

    • HTTP-модуль

    • Express.js

    Порівняння Nginx та Express.js

    • Nginx — високопродуктивний веб-сервер і зворотний проксі

    • Express.js — мінімалістичний фреймворк для веб-застосунків

    У продакшені їх часто поєднують:

    • Nginx обробляє статичні файли, SSL та балансування

    • Express.js працює з динамічним контентом

    Nginx значно ефективніший при великій кількості одночасних підключень.

    Підсумок

    Коли ви розумієте:

    • forward proxy

    • reverse proxy

    • load balancer

    — стає дуже просто розібратися в інфраструктурі веб-сервісів.

    Forward proxy захищає клієнтів.
    Reverse proxy захищає сервери.
    Load balancer розподіляє навантаження.
    А сучасні системи зазвичай використовують усі ці компоненти разом, часто на кількох рівнях.

  • Kafka простими словами

    Якщо ви постійно чуєте про Apache Kafka, але так і не збагнули, що це таке і чому всі про неї говорять — ця стаття нарешті поставить усе на свої місця.
    Ми розберемо Kafka на реальних прикладах, використовуючи вигаданий e-commerce застосунок StreamStore, і подивимось, як Kafka вирішує біль, з якою стикається майже кожна сучасна архітектура.

    Проблема: коли мікросервіси перетворюються на доміно

    У нашому StreamStore працюють мікросервіси:

    • замовлення

    • платежі

    • склад

    • сповіщення

    • аналітика

    Коли користувач оформляє замовлення, у системі запускається цілий ланцюг подій:

    • зменшення залишку на складі

    • надсилання email клієнту

    • створення інвойсу

    • оновлення панелі продажів

    • оновлення статистики виручки

    Ми — невеликий стартап, тому на початку робимо все максимально просто:
    мікросервіси напряму викликають один одного.

    Order → Payment → Inventory → Notification → Analytics

    І все працює… поки не настає Black Friday.

    Раптом:

    • застосунок починає гальмувати

    • користувачі сидять перед вічними екранами завантаження

    • сервіси падають під навантаженням

    • продажі втрачаються щохвилини

    • архітектура перетворюється на хаос

    Що ж сталося?

    Чому пряме взаємодіяння мікросервісів — це пастка

    1. Жорстка зв’язаність

    Якщо сервіс платежів падає — весь процес оформлення замовлення зупиняється.

    2. Синхронні виклики

    Кожен крок чекає наступного — як довга лінія доміно.
    Один повільний сервіс → усе сповільнюється.

    3. Точки відмови

    10 хвилин простою складу = 2 години накопичених замовлень.

    4. Втрата даних

    Аналітика впала на годину → втрачено годину даних про продажі.

    Нам потрібна архітектура, де події проходять крізь систему
    природним потоком, а не у вигляді нескінченного ланцюжка викликів.

    Рішення: Kafka як “поштове відділення” системи

    Замість того, щоб сервіси напряму дергали один одного, ми додаємо брокер — посередника між ними.

    Kafka = поштова служба для мікросервісів:

    • Відправник (Order Service) кладе “пакунок” (event)

    • Пошта (Kafka) приймає і зберігає його

    • Отримувачі (Inventory, Notification, Payments тощо) забирають, коли готові

    Ніяких очікувань. Ніяких прямих викликів. Ніяких зависань.

    Producers і Events: як дані потрапляють у Kafka

    Order Service стає producer-ом.
    Він створює подію:

    “Створено замовлення: клієнт X, товари Y, деталі Z.”

    І відправляє її в Kafka.

    Подія — це простий об’єкт із ключем, значенням та метаданими.

    Після відправлення сервіс не чекає, чи хтось отримав це повідомлення.
    Він просто продовжує роботу.

    Де зберігаються події? Kafka Topics

    Kafka групує події в топіки — як окремі черги в поштовому відділенні:

    • orders

    • payments

    • inventory

    • notifications

    Нічого не складається у величезний безлад.
    Топіки створюєте ви — як схеми в базі даних.

    Consumers: сервіси, які реагують на події

    Коли в orders з’являється подія “створено замовлення”, підписники отримують її:

    • Notification Service → надсилає лист

    • Inventory Service → зменшує залишок

    • Payment Service → створює інвойс

    • Analytics Service → оновлює статистику

    Кожен працює у своєму темпі, незалежно від інших.

    Kafka — це база даних? Ні, й ось чому

    Kafka зберігає події, але не замінює основну БД.

    Наприклад:

    • Склад оновлює залишки в базі

    • Але також генерує подію оновлення складу, щоб:

      • спрацювали оповіщення про низький залишок

      • сервіс авто-поповнення зробив нове замовлення

      • аналітика могла працювати в реальному часі

    Kafka — це не стан.
    Kafka — це історія змін.

    Потокова обробка в реальному часі: Kafka Streams

    Деяким застосункам потрібне постійне оновлення:

    • realtime панель продажів

    • геолокація водіїв в Uber

    • постійна перевірка складських порогів

    Для цього Kafka пропонує Streams API — потокову обробку подій.

    Streams працюють не “одна подія → одна дія”, а безперервним потоком.

    Масштабованість Kafka: Partitions

    Kafka масштабується завдяки партиціям.

    Уявіть:
    у поштовому відділенні додали більше працівників у кожен розділ:

    • листи до Європи → працівник A

    • листи до США → працівник B

    • листи до Азії → працівник C

    У Kafka так само:

    • orders-eu

    • orders-us

    • orders-asia

    Різні продюсери можуть писати в різні партиції паралельно.

    Прискорюємо обробку: Consumer Groups

    Якщо один сервіс не встигає обробляти потік даних — запускаємо кілька його копій.

    Kafka автоматично:

    • об’єднує їх за group ID

    • розподіляє партиції між ними

    • переносить навантаження, якщо одна копія падає

    Це забезпечує горизонтальне масштабування.

    Де фізично зберігаються дані? Kafka Brokers

    Kafka працює на кластері серверів — broker-ів.

    Брокери:

    • зберігають дані на дисках

    • приймають запити

    • реплікують дані

    • забезпечують відмовостійкість

    Kafka зберігає події стільки, скільки ви вкажете в retention policy.

    Це головна відмінність від звичайних черг, які видаляють повідомлення після обробки.

    Kafka vs класичні черги: Netflix проти телебачення

    Звичайна черга — як телебачення:

    • дивишся те, що показують

    • у той час, коли показують

    • пропустив — все, втратив

    Kafka — як Netflix:

    • дивишся що хочеш

    • коли хочеш

    • у своєму темпі

    • можеш переглядати знову

    Саме ця гнучкість робить Kafka унікальною.

    Прощавай, ZooKeeper: вітаємо, KRaft

    Раніше Kafka використовувала ZooKeeper для координації.
    Сучасні версії перейшли на KRaft, вбудовану систему керування.

    Це спрощує конфігурацію та зменшує кількість залежностей.

    Висновок

    Kafka — це не просто message broker.
    Це потужна платформа для потокової обробки даних, яка вирішує:

    • жорстку зв’язаність

    • проблеми синхронних викликів

    • втрату даних

    • неможливість realtime аналітики

    • проблеми масштабування

    Якщо ця стаття допомогла вам нарешті зрозуміти Kafka — поділіться нею з колегою, якому вона теж стане у пригоді.

  • Майбутнє програмної інженерії: як залишатися цінним у добу штучного інтелекту

    Нова ера для розробників

    Уявіть: ви багато років пишете код. Ви досконало володієте своїми мовами програмування, знаєте фреймворки та пишаєтеся вмінням вирішувати складні задачі. І ось одного дня ви бачите, як AI-асистент за кілька секунд пише функцію, на яку у вас би пішло 20 хвилин.

    Цей момент усвідомлення сьогодні переживають інженери по всьому світу. І він змушує нас визнати нову реальність: ландшафт розробки змінюється.

    Питання більше не в тому, чи вплине штучний інтелект на нашу роботу, а в тому, як ми можемо адаптуватися, щоб залишатися потрібними та цінними.

    У цій статті ми розглянемо чіткий шлях, як розробникам розвиватися в епоху, коли AI вже здатен виконувати завдання, які колись вважалися виключно людськими.

    Чому ці зміни особливі

    Світ технологій завжди змінювався швидко — нові фреймворки, нові версії, нові підходи. Але цього разу зміни іншого рівня.

    Йдеться не просто про вивчення нового інструменту чи синтаксису. Йдеться про повне переосмислення ролі розробника у процесі створення програмного продукту.

    Щоб залишатися конкурентоспроможним, треба зосередитись на навичках, які штучний інтелект не може легко відтворити — стратегічному мисленні, архітектурному баченні та розумінні бізнесу.

    Ось чотири ключові навички, які зроблять вас незамінним у світі, де AI стає частиною щоденної роботи.

    1. Думайте як архітектор

    Коли команді потрібно масштабувати застосунок у 10 разів, молодший розробник оптимізує запити, розробник середнього рівня почне шукати балансувальники навантаження.

    А архітектор запитає:

    • Чи підходить наша архітектура для такого масштабу?

    • Може, варто перейти від моноліту до мікросервісів?

    • Чи не слід повністю переглянути систему зберігання даних?

    Це і є архітектурне мислення — здатність стратегічно проєктувати системи та приймати технічні рішення, що відповідають бізнес-цілям.

    AI може оптимізувати запит, але не здатен спроєктувати масштабовану, стійку та економічну систему, яка відповідатиме унікальним потребам вашої компанії.

    Архітектори визначають фундамент усього проєкту — і чим розумнішим стає AI, тим більшою стає цінність стратегічного мислення.

    2. Опануйте DevOps і хмарну інфраструктуру

    Після того як архітектурні рішення прийнято, їх потрібно ефективно реалізувати.

    Тут на сцену виходять DevOps і cloud-native технології.

    Сучасний інженер має розуміти:

    • Контейнери (наприклад, Docker) — для стабільності середовищ.

    • Kubernetes — для автоматичного масштабування та відновлення.

    • Infrastructure as Code — для передбачуваності.

    • CI/CD — для швидкої доставки оновлень.

    Йдеться не просто про інструменти, а про створення систем, які постійно приносять цінність.

    AI може згенерувати код для мікросервісу або скрипт деплою, але не побудує повністю інтегровану систему безперервної доставки, що поєднує розробку, операції й бізнес.

    Тому інженери, які розуміють DevOps на стратегічному рівні, завжди будуть затребувані.

    3. Орієнтуйтеся на бізнес, а не лише на техніку

    Різниця між хорошим і видатним розробником полягає ось у чому:
    Хороший розробник створює працюючий код.
    Видатний — створює відчутну бізнес-цінність.

    Порівняймо:

    Приклад 1:

    «Ми розбили моноліт на мікросервіси й розгорнули їх у Kubernetes.»

    Приклад 2:

    «Після переходу на мікросервіси ми знизили затримку з 700 мс до 150 мс, скоротили витрати на інфраструктуру на $5000 щомісяця та усунули три критичні вразливості.»

    У другому випадку технічна робота напряму пов’язана з результатом для бізнесу.

    AI не розуміє цілей компанії чи потреб клієнтів — це можете зробити тільки ви.

    Якщо ви зможете показати, як ваші технічні рішення впливають на прибуток, ефективність або безпеку, — ви стаєте стратегічним партнером, а не просто виконавцем.

    4. Співпрацюйте з AI, а не змагайтеся з ним

    Остання навичка — це вміння ефективно працювати разом із штучним інтелектом.

    Не варто боятися AI — краще використовуйте його як помічника:

    • Нехай він генерує шаблонний код.

    • Автоматично створює тести чи документацію.

    • А ви додаєте логіку, досвід і контекст.

    Таке поєднання швидкості AI та людського критичного мислення створює найефективнішу модель роботи.

    Ті, хто ігнорує AI, відстануть. Ті, хто навчиться з ним співпрацювати, стануть у кілька разів продуктивнішими.

    Приклад: масштабування застосунку

    Уявімо, як усі чотири навички працюють разом:

    1. Архітектура – ви переходите від моноліту до мікросервісів із кешуванням і швидким доступом до даних.

    2. DevOps – контейнеризація, CI/CD, Kubernetes.

    3. Бізнес-результат – зниження затримок на 70%, зменшення витрат і підвищення стабільності.

    4. AI – допомагає згенерувати базовий код і тести, а ви вдосконалюєте результат.

    Тепер ви не просто програміст — ви стратегічний інженер, який приносить бізнес-цінність.

    Типові помилки розробників

    Деякі намагаються конкурувати з AI у швидкості — марно.
    Інші бояться його або повністю на нього покладаються — теж помилка.

    Правильний підхід — партнерство: використовуйте AI як інструмент, але не передавайте йому мислення.

    Майбутнє належить адаптивним інженерам

    Найціннішими стануть ті, хто:

    • Мислить архітектурно.

    • Розуміє DevOps і хмару.

    • Вміє перетворювати технічні рішення на бізнес-результати.

    • Використовує AI як прискорювач, а не загрозу.

    Технології змінюються, але здатність мислити, вчитися та адаптуватися — ваша найкраща інвестиція.

    Підсумок

    Не змагайтеся з AI — співпрацюйте з ним.
    Не просто пишіть код — створюйте системи.
    Не просто випускайте фічі — приносьте цінність бізнесу.

    Так ви залишатиметесь актуальними й незамінними в епоху інтелектуальної автоматизації.

  • Як врятувати .NET Open Source: практичні ідеї для сталої екосистеми

    Протягом багатьох років екосистема open source у .NET стикається з проблемою сталого розвитку. На відміну від таких спільнот, як Node.js, багато розробників .NET використовують пакети NuGet, але не мають простого способу підтримати їхніх авторів. Проте Microsoft має всі ресурси, щоб змінити це та зробити екосистему по-справжньому життєздатною.

    Досвід npm — і як зробити краще

    Нещодавно NuGet представив функцію, подібну до npm fund, яка дозволяє користувачам підтримувати авторів пакетів. npm запровадив її ще у 2019 році, і NuGet знадобилося шість років, щоб наздогнати. Але замість того, щоб сприймати це як запізніле повторення, Microsoft може піти далі та створити щось дійсно унікальне.

    NuGet працює в іншому середовищі. Його користувачі — це не лише ентузіасти, а й корпоративні розробники, які працюють із передплатами Visual Studio. Компанії вже сплачують чималі кошти — від $50 на місяць за Professional до сотень доларів за Enterprise.

    Це означає, що інфраструктура для моделі фінансування та розподілу прибутку вже існує. Microsoft знає, які організації та користувачі використовують які пакети, завдяки телеметрії та інтеграції з Entra ID (раніше Azure AD).

    Ідея №1: Розподіл доходів для авторів пакетів NuGet

    Microsoft могла б виділяти, наприклад, 10% від прибутку з передплат Visual Studio і розподіляти їх між перевіреними авторами пакетів NuGet. Розподіл можна було б здійснювати пропорційно до популярності пакетів — подібно до того, як Spotify платить музикантам або YouTube Premium ділиться прибутком з авторами.

    Система могла б працювати повністю автоматично. Розробникам не довелося б керувати донатами вручну — вони просто отримували б свою частку за внесок у спільноту.

    Уявіть, що при встановленні пакета у Visual Studio з’являється повідомлення:

    «Частина вашої передплати Visual Studio спрямовується на підтримку цього автора.»

    Це створило б довіру та зробило розробку open source у .NET дійсно сталою.

    Ідея №2: Вбудована покупка ліцензій у NuGet

    Ще одна проблема для корпоративних користувачів — ліцензування. Багато пакетів NuGet надаються безкоштовно для невеликих команд, але вимагають оплату для великих організацій. Процес купівлі ліцензій зараз складний — потрібно залучати юристів, відділ закупівель і підписувати контракти.

    Рішення — інтеграція NuGet з Azure Marketplace. Microsoft уже має розвинену систему оплати. Зв’язавши NuGet із Azure Marketplace, компанії зможуть купувати ліцензії прямо з Visual Studio або через свою підписку Azure.

    Наприклад:

    • Пакет безкоштовний до 5 розробників.

    • Коли шостий користувач із тієї ж організації Entra завантажує пакет, система повідомляє менеджера і пропонує оформити ліцензію.

    • Менеджер додає оплату безпосередньо до рахунку Azure.

    Це просто, зручно і створює прозору модель доходів для авторів.

    М’який “paywall” і захист ліцензій

    Microsoft уже має потужну систему аудиту ліцензій. Якщо пов’язати використання NuGet із обліковими записами Visual Studio та Entra, компанії зможуть автоматично захищати себе від випадкових порушень ліцензій.

    Така модель стане своєрідним м’яким платним бар’єром: невеликі команди зможуть працювати безкоштовно, а великі організації — фінансово підтримувати екосистему. Це також допоможе уникнути порушень умов Community Edition, яка забороняє використання при певному рівні доходів.

    Результат: стала екосистема .NET

    Якщо Microsoft реалізує подібні ідеї, екосистема .NET стане по-справжньому сталою. Розробники зможуть отримувати справедливу винагороду за свої проєкти, а нові фахівці охочіше приєднуватимуться, розуміючи, що open source у .NET може приносити реальний дохід.

    Це призведе до:

    • Активнішої спільноти

    • Вищої якості та стабільності пакетів

    • Зростання довіри до платформи .NET і Microsoft

    Open source потребує не лише ентузіазму, але й структури, визнання та підтримки. Із правильною моделлю фінансування та ліцензування .NET зможе нарешті стати здоровою, живою екосистемою.

  • Як розгорнути агента з Microsoft Copilot Studio у Microsoft 365 Copilot Chat

    Microsoft Copilot Studio дає змогу створювати інтелектуальних агентів, які можуть взаємодіяти через різні канали — Microsoft Teams, SharePoint, Slack або Microsoft 365 Copilot Chat.
    У цьому посібнику покроково пояснено, як створити, опублікувати та розгорнути агента саме у Microsoft 365 Copilot Chat.

    Крок 1: Створення агента в Microsoft Copilot Studio

    Спершу відкрийте Microsoft Copilot Studio і створіть нового агента.
    У цьому прикладі ми використаємо простого агента з назвою «Climate Agent».

    Всередині агента можна створювати теми (topics), які визначають, як він реагуватиме на запити користувачів.

    Приклад теми

    • Назва теми: Humidity

    • Тригер: Коли користувач запитує про вологість

    • Відповідь: «Вологість становить 90%.»

    Цей базовий сценарій дозволяє агенту відповідати на запитання про вологість фіксованим значенням.

    Крок 2: Публікація агента

    Після налаштування теми:

    1. Натисніть Publish у Copilot Studio.

    2. Дочекайтеся завершення процесу публікації.

    3. Протестуйте агента, ввівши «humidity» у тестовому чаті.

    Якщо відповідь з’явилася — агент налаштований правильно.

    Крок 3: Налаштування автентифікації

    Перед розгортанням потрібно налаштувати параметри безпеки.

    1. Перейдіть у Settings → Security → Authentication.

    2. Виберіть Authenticate with Microsoft.

    Цей параметр активує автентифікацію через Microsoft Entra ID (Azure AD), що є обов’язковою для розгортання агента в Microsoft 365 Copilot, Teams або SharePoint.

    Крок 4: Розгортання агента у Microsoft 365 Copilot

    1. Відкрийте розділ Channels у Copilot Studio.

    2. Виберіть Teams and Microsoft 365 Copilot.

    3. Позначте пункт “Make agent available in Microsoft 365 Copilot.”

    4. Натисніть Add Channel.

    Після цього агент буде опублікований одночасно для Teams і Microsoft 365 Copilot.

    Крок 5: Налаштування зовнішнього вигляду та інформації про агента

    Після публікації можна персоналізувати агента:

    • Змінити колір: оберіть потрібну тему.

    • Змінити іконку: завантажте PNG-файл розміром менше ніж 32 KB.

    • Додати опис:

      • Короткий опис: «Агент клімату, що показує вологість.»

      • Довгий опис: додайте детальнішу інформацію або приклади використання.

    • Вказати розробника: введіть ім’я, вебсайт і, за потреби, партнерський ID (MPN).

    Після внесення змін натисніть Save.

    Крок 6: Перевірка розгортання в Microsoft 365 Copilot

    Щоб переконатися, що агент опублікований:

    1. Перейдіть на сайт m365.cloud.microsoft.com.

    2. Відкрийте інтерфейс Copilot Chat.

    3. У розділі All Agents знайдіть свого Climate Agent.

    4. Натисніть Add, щоб додати його до робочого простору.

    Після цього ви зможете використовувати агента безпосередньо у Microsoft 365 Copilot Chat.

    Крок 7: Тестування агента

    Після додавання агента:

    • Відкрийте Microsoft 365 Copilot Chat.

    • Введіть команду «humidity».

    • Агент відповість: «Вологість становить 90%.»

    Інтерфейс тут виглядає більш професійно, ніж у тестовому середовищі Copilot Studio — це вже кінцеве середовище для користувачів.

    Крок 8: Використання агента в Teams і Copilot

    Оскільки агент опублікований одночасно у Teams і Microsoft 365 Copilot, він також доступний у Microsoft Teams у розділі Apps.
    Ви можете закріпити або видалити його за потреби.

    Висновок

    Дотримуючись цього посібника, ви зможете:

    • створити агента в Microsoft Copilot Studio;

    • налаштувати автентифікацію через Microsoft;

    • опублікувати його у Microsoft 365 Copilot Chat і Teams.

    Це дає змогу вашій організації використовувати інтелектуальних агентів у середовищі Microsoft 365, підвищуючи продуктивність і покращуючи взаємодію користувачів із системою.