Категорія: Uncategorized

  • Чи справді .NET Aspire є платформою з відкритим вихідним кодом?

    Чи справді .NET Aspire є платформою з відкритим вихідним кодом?

    .NET Aspire позиціонується як безкоштовна платформа з відкритим вихідним кодом. Однак це твердження заслуговує на уважніший розгляд. Глибший аналіз внутрішніх компонентів виявляє пропрієтарний елемент у самому центрі системи оркестрації — що піднімає серйозні питання щодо прозорості, ліцензування та довіри.

    Детальніший погляд на середовище виконання Aspire

    Після створення нового застосунку Aspire у Windows і його запуску спочатку все виглядає нормально. Панель керування запускається коректно, а досвід розробника відповідає очікуванням від інструмента з відкритим вихідним кодом на .NET.

    Однак під час вивчення встановлених пакетів NuGet — зокрема Azure Hosting App Orchestration Tools — виявляється дивний виконуваний файл: DCP.exe.

    Що це за файл? Чому він там?
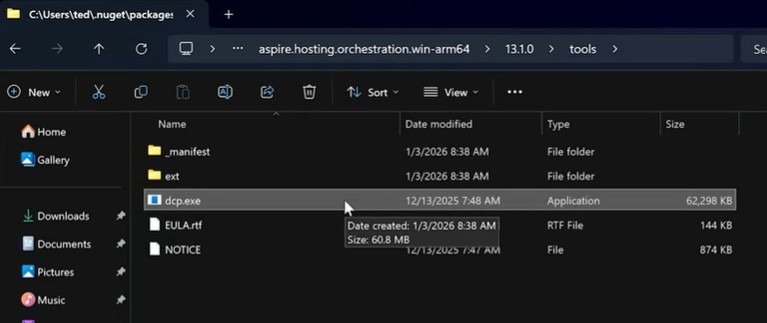
    Той самий бінарник на macOS

    Повторення експерименту на macOS призводить до того ж результату. Хоча версія Aspire там трохи старіша, той самий бінарний файл DCP з’являється в папці пакетів.

    Це піднімає критичне питання:
    Якщо Aspire — це відкритий вихідний код, чому він містить закритий виконуваний файл?

    Ліцензія розповідає іншу історію

    Відкриття ліцензійного файлу, пов’язаного з цим бінарником, виявляє дещо несподіване:
    Microsoft Developer Control Plane.

    Умови ліцензії чітко дають зрозуміти, що це пропрієтарне програмне забезпечення. Угода прямо забороняє реверс-інжиніринг, декомпіляцію або дизасемблювання. У ній також містяться положення щодо збору даних, обробки персональних даних та експортних обмежень.

    Цей бінарник не є відкритим вихідним кодом.

    Ще більш тривожно те, що під час встановлення Aspire не з’являється явного запиту на прийняття ліцензії. Пропрієтарний компонент безшумно вбудовується в ланцюжок інструментів.

    Що таке DCP?

    Документація Aspire описує DCP (Developer Control Plane) так:

    «В основі функціональності оркестрації хоста застосунків Azure. Відповідає за оркестрацію всіх ресурсів».

    Іншими словами, це не якийсь необов’язковий допоміжний інструмент — він є центральним елементом роботи Aspire.

    У документації також зазначається, що DCP написаний на Go, а не на .NET, щоб забезпечити глибоку нативну інтеграцію з API Kubernetes.

    Чого в ній не згадується:
    що цей критично важливий компонент є закритим вихідним кодом.

    Звідки береться цей бінарник?

    Схоже, що DCP не поширюється через публічний канал NuGet. Натомість у файлах проєктів Aspire присутні посилання на завантаження пакетів Microsoft Developer Control Plane з приватних джерел.

    Є підстави вважати, що ці бінарники можуть походити з внутрішнього репозиторію Microsoft на GitHub, до якого громадськість не має доступу.

    Таким чином, ланцюжок інструментів підтягує пропрієтарний бінарник із приватного джерела й упаковує його в Aspire — не надаючи можливості переглянути або прийняти його ліцензію.

    Побоювання щодо телеметрії та збору даних

    У ліцензії згадуються збір даних і обробка персональних даних. Згідно з коментарями інженерів Microsoft, DCP наразі не збирає телеметрію або дані про використання.

    Слово «наразі» тут робить дуже багато.

    Оскільки бінарник є закритим вихідним кодом, немає практичного способу перевірити, що саме він робить сьогодні — або що він може почати робити в майбутньому. Якщо телеметрію буде додано пізніше, у розробників не буде жодної видимості того, коли й як ця зміна відбулася.

    А оскільки DCP запускається на машинах розробників, ця невизначеність має значення.

    Чи є це все ще «відкритим вихідним кодом»?

    .NET Aspire розміщений під егідою .NET Foundation, яка вимагає ліцензій, схвалених OSI. Формально Aspire цим вимогам відповідає.

    Однак на практиці він обгортає пропрієтарний бінарник у самому центрі своєї архітектури.

    Це означає:

    • Ви не можете повністю зібрати Aspire з вихідного коду.

    • Ви не можете провести аудит найкритичнішої частини його логіки оркестрації.

    • Ви не можете форкнути його в повністю незалежну реалізацію.

    Це розтягує визначення «відкритого вихідного коду» за межі того, що більшість розробників вважала б розумним.

    Стурбованість спільноти та відкриті питання

    Цю проблему вже було піднято публічно, зокрема на GitHub. Одне з поставлених питань:

    Чи є плани відкрити вихідний код Developer Control Plane?

    Поточна мова ліцензії наводить на думку, що Microsoft може позиціонувати DCP як майбутній комерційний продукт.

    Якщо це станеться, це означатиме, що Aspire фактично є обгорткою навколо пропрієтарного ядра, яке згодом може стати платним програмним забезпеченням.

    Це був би класичний «rug pull».

    Чому ядро написане на Go?

    Ще одна незручна деталь:
    DCP написаний на Go, а не на .NET.

    Для платформи, що позиціонується як флагманське рішення .NET для оркестрації, винесення найважливішої логіки в Go-бінарник виглядає суперечливо.

    Якщо .NET має бути першокласною платформою для cloud-native інструментів, то чому тоді його оркестраційне ядро не реалізоване на .NET?

    Справжня цінність Aspire?

    Одне з найпроникливіших спостережень із глибокого технічного аналізу полягає в тому, що бінарник DCP може бути найціннішою частиною Aspire. Він виглядає значно складнішим, ніж оточуючий його C#-код.

    У цьому світлі Aspire починає виглядати не стільки як платформа з відкритим вихідним кодом, скільки як тонка обгортка навколо закритого рушія.

    Кращий напрямок уперед

    Ось конструктивна пропозиція:

    • Відкрити вихідний код Developer Control Plane.

    • Якщо Go абсолютно необхідний, залишити його на Go — але зробити код публічним.

    • Ще краще — реалізувати його на .NET.

    • Надати документований, придатний для аудиту API оркестрації.

    Повністю відкритий, нативний для .NET рушій оркестрації Kubernetes був би справді вражаючим — і набагато більш відповідним духові .NET Foundation.

    Остаточний вердикт

    Чи можна сьогодні чесно назвати .NET Aspire платформою з відкритим вихідним кодом?

    Ні.

    Не тоді, коли пропрієтарний бінарник Microsoft знаходиться в центрі його функціональності.
    Не тоді, коли розробники не можуть переглянути, зібрати або замінити цей компонент.
    Не тоді, коли ліцензійні умови тихо зв’язують компанії без явної згоди.

    Поки цю проблему не буде вирішено, важко рекомендувати Aspire добросовісно.

    Microsoft повинна прояснити статус Developer Control Plane, опублікувати його вихідний код або, принаймні, бути прозорою щодо закритої залежності, вбудованої в Aspire.

    Прямо зараз ця ситуація не просто заплутана — вона глибоко тривожна.
  • Microsoft Entra Agent ID: призначення, можливості та архітектура

    Microsoft Entra Agent ID: призначення, можливості та архітектура

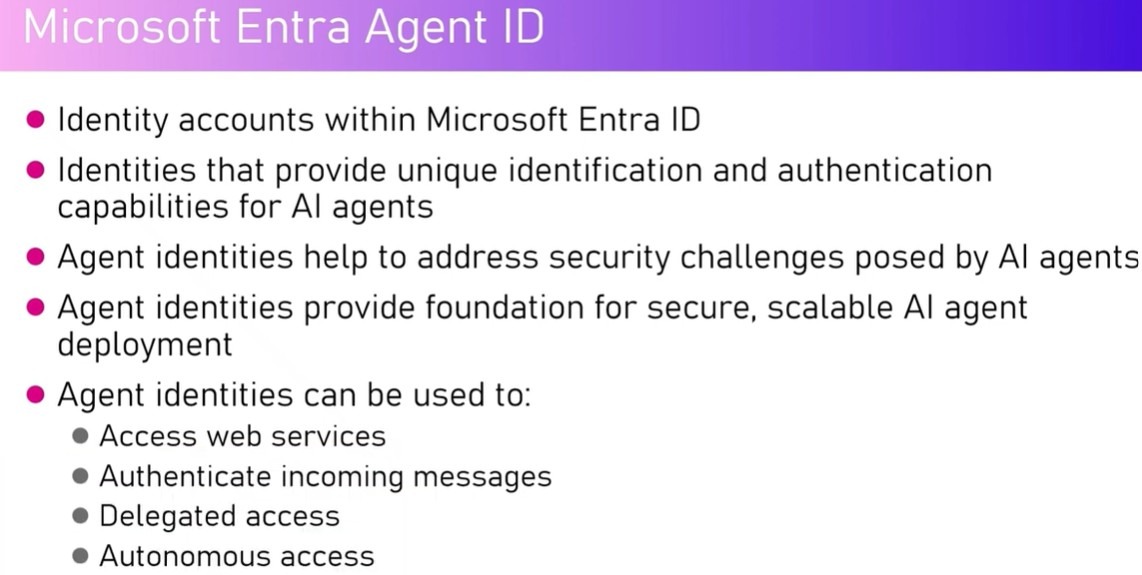
    Microsoft Entra Agent ID призначений для надання можливостей ідентифікації спеціально для AI-агентів у межах Microsoft Entra ID. По суті, він запроваджує облікові записи ідентичності, які дозволяють однозначно ідентифікувати та автентифікувати AI-агентів у екосистемі Microsoft.

    Ідентичності агентів формують основу для безпечного та масштабованого розгортання AI-агентів. Вони допомагають вирішувати зростаючі виклики безпеки та експлуатації, пов’язані з використанням AI-агентів, забезпечуючи кожному агенту коректну ідентичність, відповідний рівень доступу та керованість.

    Навіщо потрібен Microsoft Entra Agent ID

    У міру того як організації створюють і впроваджують AI-агентів, особливо у великих масштабах, з’являються нові виклики. Коли один агент розгортається у кількох екземплярах, стає критично важливо відрізняти дії AI-агентів від дій користувачів, робочих навантажень або клієнтів.

    Microsoft Entra Agent ID створений саме для вирішення цього завдання. Він запобігає ситуаціям, коли AI-агенти випадково отримують підвищені привілеї або доступ до чутливих систем, до яких вони не повинні мати доступу. Це особливо важливо в середовищах, де агенти швидко створюються та видаляються.

    Ідентичності агентів також забезпечують масштабоване управління обліковими записами. Велику кількість AI-агентів можна створювати та знищувати без шкоди для безпеки або операційної прозорості. Кожен агент отримує доступ, який точно відповідає його призначенню.

    Можливості, які надають ідентичності агентів

    Ідентичності агентів можуть використовуватися для:

    • безпечного доступу до вебсервісів;

    • автентифікації вхідних повідомлень;

    • підтримки автономних і делегованих сценаріїв доступу;

    • чіткого розмежування між AI-агентами та людськими обліковими записами.

    Призначаючи агентам власні ідентичності, організації отримують видимість, контроль і засоби управління тим, як агенти взаємодіють із системами та сервісами.

    Поняття агентних blueprint’ів

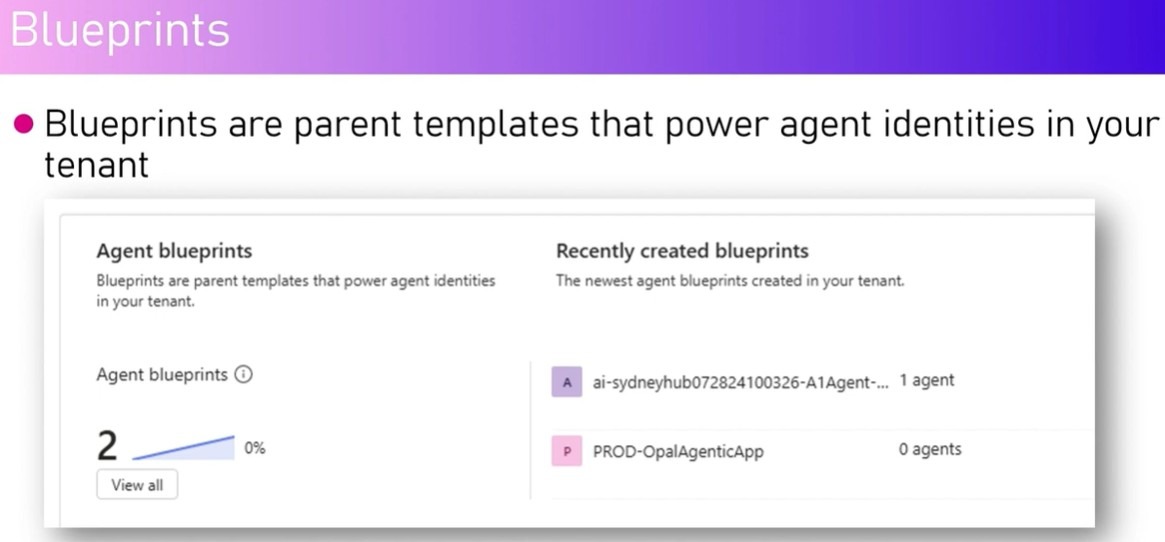
    Ідентичності агентів створюються на основі blueprint’ів. Blueprint — це батьківський шаблон, який лежить в основі агентних ідентичностей у межах тенанта. Кожен створений агент має агентну ідентичність, а сама ідентичність формується з blueprint’а.

    Blueprint’и визначають, яким чином створюються та керуються ідентичності агентів. Кілька агентів можуть бути пов’язані з одним blueprint’ом, що дозволяє забезпечити однакову поведінку ідентичностей для однотипних агентів. Використання blueprint’ів не є обов’язковим для всіх агентів, але вони надають додаткову структуру та контроль під час масштабування.

    Керування ідентичностями агентів у Microsoft Entra

    В адміністративному середовищі Microsoft Entra доступна окрема функція Agent ID, яка забезпечує повну видимість усіх агентних ідентичностей у тенанті. У цьому інтерфейсі адміністратори можуть переглядати:

    • усі ідентичності агентів;

    • статус агентів (активний або неактивний);

    • Object ID та зв’язок із blueprint’ами;

    • власників і спонсорів;

    • інформацію про те, чи використовує агент ідентичність.

    Централізований огляд дозволяє застосовувати політики управління, захищати агентів за замовчуванням і керувати повним життєвим циклом ідентичностей за допомогою вбудованих механізмів Entra.

    Контроль blueprint’ів і управління життєвим циклом

    Для кожного blueprint’а відображається кількість пов’язаних агентних ідентичностей, дата створення та рівень наданого доступу. Адміністратори можуть:

    • вимкнути blueprint, щоб запобігти створенню нових агентних ідентичностей;

    • зберегти працездатність уже існуючих ідентичностей;

    • переглянути дозволи адміністративної та користувацької згоди;

    • призначити власників і спонсорів;

    • переглянути журнали аудиту та входів у систему.

    Вимкнення blueprint’а не вимикає існуючих агентів, а лише запобігає створенню нових ідентичностей на його основі.

    Колекції агентів і управління

    Ідентичності агентів також можуть бути організовані в колекції, які можуть бути як попередньо визначеними, так і користувацькими. Приклади таких колекцій:

    • глобальна колекція, видима всім ідентичностям у тенанті;

    • карантинна колекція для ізольованих або обмежених агентів.

    Колекції посилюють управління, дозволяючи групувати агентів за призначенням, рівнем довіри або операційним станом.

    Інтеграція з платформами Microsoft

    Microsoft Entra Agent ID тісно інтегрований із такими платформами, як:

    • Microsoft Copilot Studio;

    • Power Platform Admin Center;

    • Microsoft 365 Admin Center;

    • Azure AI Foundry.

    Copilot Studio зосереджений на створенні та налаштуванні агентів, тоді як деталі, пов’язані з ідентичністю — такі як Agent ID, прив’язка до blueprint’ів і параметри управління — опрацьовуються через адміністративні центри. Такий підхід забезпечує чітке розмежування між функціональністю агента та управлінням його ідентичністю.

    Підсумок

    Microsoft Entra Agent ID — це обліковий запис ідентичності в Microsoft Entra ID, який надає AI-агентам унікальні можливості ідентифікації та автентифікації. Він відіграє ключову роль у забезпеченні безпеки, масштабованості та керованості AI-агентів у екосистемі Microsoft.

    Використовуючи ідентичності агентів і blueprint’и, організації можуть безпечно розгортати AI-агентів із контрольованим доступом, прозорою відповідальністю та корпоративним рівнем захисту. Окрім безпеки, агентні ідентичності забезпечують автентифіковану взаємодію, делегований доступ і інтеграцію з вебсервісами, що робить їх фундаментальним елементом сучасної архітектури AI-агентів.

  • MCP Inspector: тестування та налагодження MCP-серверів

    Що таке MCP?

    MCP (Model Context Protocol) — це відкритий стандарт, який дозволяє великим мовним моделям (LLM) безпечно отримувати доступ до зовнішніх даних і інструментів. До таких ресурсів можуть належати файли, бази даних, пошукові інструменти, середовища виконання коду тощо.

    За своєю концепцією MCP можна порівняти з універсальним магазином застосунків для AI-асистентів, де моделі взаємодіють із зовнішніми можливостями за єдиним стандартом.

    Що таке MCP Inspector?

    MCP Inspector — це інтерактивний інструмент для розробників, призначений для тестування та налагодження MCP-серверів. Під час створення MCP-сервера, який надає дані або інструменти, важливо переконатися, що запити, відповіді та конфігурації працюють коректно. MCP Inspector саме для цього й використовується.

    Інструмент надає вебінтерфейс, який дозволяє підключатися до MCP-серверів, виконувати інструменти, аналізувати відповіді, переглядати логи та ефективно усувати помилки.

    Як працює MCP Inspector

    MCP Inspector запускається локально та не потребує класичної інсталяції. Він стартує за допомогою команди npx:

    npx @modelcontextprotocol/inspector

    Що таке npx?

    npx — це запускач пакетів Node.js, який дозволяє виконувати пакети без їх попереднього встановлення. Після виконання команди:

    • автоматично розгортається застосунок інспектора;

    • запускається локальний вебінтерфейс;

    • інтерфейс стає доступним за адресою localhost:6274.

    Локальні та віддалені MCP-сервери

    Хоча MCP Inspector працює локально, його можна використовувати для налагодження як:

    • локальних MCP-серверів,

    • так і віддалених MCP-серверів.

    Локальний проксі починає прослуховувати порт localhost:6277, забезпечуючи обмін даними між інтерфейсом інспектора та цільовим MCP-сервером. Для цього автоматично використовуються сесійні токени.

    Огляд інтерфейсу MCP Inspector

    Інтерфейс MCP Inspector складається з двох основних частин:

    • Ліва панель — параметри конфігурації та підключення

    • Основна область — виконання інструментів, історія та повідомлення сервера

    Основні можливості:

    • перегляд доступних інструментів;

    • виконання інструментів із користувацьким введенням;

    • перегляд історії виконання;

    • моніторинг повідомлень і логів сервера.

    Параметри конфігурації

    Типи транспорту

    MCP Inspector підтримує кілька механізмів передавання даних:

    • Streamable HTTP

    • SSE (Server-Sent Events)

    • STDIO

    Вибір транспорту залежить від реалізації MCP-сервера.

    Способи підключення

    Доступні два варіанти підключення:

    • Пряме підключення

    • Підключення через проксі

    Рівні логування та налагодження

    Підтримуються такі рівні логування:

    • Debug

    • Info

    • Notice

    • Warning

    • Error

    • Critical

    • Alert

    • Emergency

    Це дозволяє гнучко керувати обсягом діагностичної інформації.

    Аутентифікація

    MCP Inspector підтримує кілька способів автентифікації:

    • користувацькі JSON-заголовки;

    • заголовки авторизації з секретами;

    • OAuth 2.0 (Client ID, Client Secret, Redirect URL, Scope).

    Додаткові налаштування

    Також доступні такі параметри:

    • тайм-аут запиту;

    • тайм-аут запиту під час виконання;

    • максимальний загальний тайм-аут;

    • адреса проксі;

    • сесійний токен проксі.

    Підключення до MCP-сервера

    Після налаштування параметрів підключення до MCP-сервера ініціює сесію та завантажує метадані сервера, зокрема:

    • назву сервера;

    • підтримувані можливості;

    • список доступних інструментів;

    • початковий рівень логування.

    Після підключення стають доступними розширені параметри налагодження та історія команд.

    Виконання інструментів у MCP Inspector

    Після успішного підключення автоматично відкривається вкладка Tools.

    Тут можна:

    1. Отримати список усіх доступних інструментів

    2. Обрати потрібний інструмент

    3. Задати вхідні параметри (часто у форматі JSON)

    4. Запустити інструмент

    5. Проаналізувати відповідь і логи

    Приклад: MCP-сервер із прикладами застосунків

    Приклад MCP-сервера може надавати такі інструменти:

    • пошук прикладів за ключовим словом;

    • отримання прикладів за продуктом;

    • отримання прикладів за автором.

    Під час виконання інструментів:

    • вхідні параметри мають відповідати очікуваному формату;

    • деякі інструменти вимагають чітко структурований JSON;

    • інші приймають просте текстове введення.

    Наприклад, пошук за ключовим словом може повертати:

    • загальну кількість результатів;

    • дані з підтримкою пагінації;

    • детальні метадані для кожного елемента.

    Параметри пагінації включають:

    • номер сторінки;

    • розмір сторінки.

    Усі дії фіксуються у вкладці History, що дозволяє відстежити весь ланцюг виконаних команд і змін конфігурації.

    Документація та ресурси

    Офіційна документація MCP Inspector доступна за адресою:

    • modelcontextprotocol.io/docs/tools/inspector

    У ній описано:

    • архітектуру MCP (сервери та клієнти);

    • підключення до локальних і віддалених MCP-серверів;

    • створення MCP-серверів і клієнтів;

    • підтримувані транспортні механізми.

    Також доступний GitHub-репозиторій:

    • modelcontextprotocol/inspector

    У ньому можна ознайомитися з вихідним кодом та деталями реалізації інструмента.

    Висновок

    MCP Inspector — це потужний і зручний інструмент для розробників, призначений для перевірки та налагодження MCP-серверів. Він підтримує різні типи транспорту, механізми автентифікації, детальне логування, а також роботу як із локальними, так і з віддаленими серверами.

    Використання MCP Inspector дозволяє впевнено розробляти, тестувати та супроводжувати MCP-сервери, які інтегрують AI-моделі з реальними даними та інструментами.

  • Порівняння TOON і JSON

    Порівняння TOON і JSON

    У цій статті розглядається порівняння TOON і JSON з точки зору їх призначення, структури, ефективності використання токенів і застосування в сучасних застосунках, особливо в контексті великих мовних моделей (LLM).

    Що таке TOON?

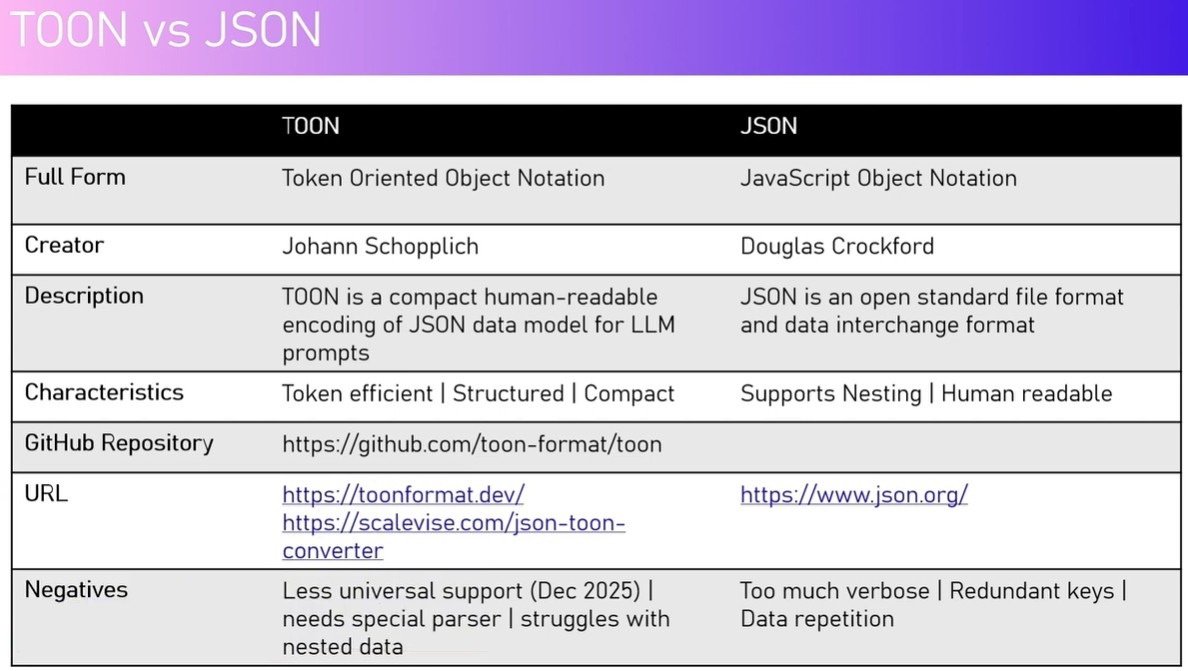
    TOON — це token-oriented object notation (об’єктна нотація, орієнтована на токени), розроблена спеціально для AI-застосунків. Її основна мета — зменшити кількість токенів під час роботи із запитами та відповідями LLM. TOON є компактним, людиночитабельним кодуванням моделі даних JSON і оптимізований для ефективної взаємодії з мовними моделями.

    TOON був створений Йоганом Шокплічем за участі Джейсона та Дугласа Крокфорда в межах ширшої екосистеми JSON. Станом на грудень 2025 року TOON є відносно новим форматом і переважно використовується в AI-середовищі.

    Що таке JSON?

    JSON (JavaScript Object Notation) — це відкритий стандарт файлового формату та формат обміну даними. Він широко використовується для передавання даних між системами, подання структурованих даних, зберігання конфігураційних файлів і взаємодії між API та сервісами.

    JSON — універсальний формат із широкою підтримкою на різних платформах, мовах програмування та інструментах.

    Ключові характеристики

    Характеристики TOON

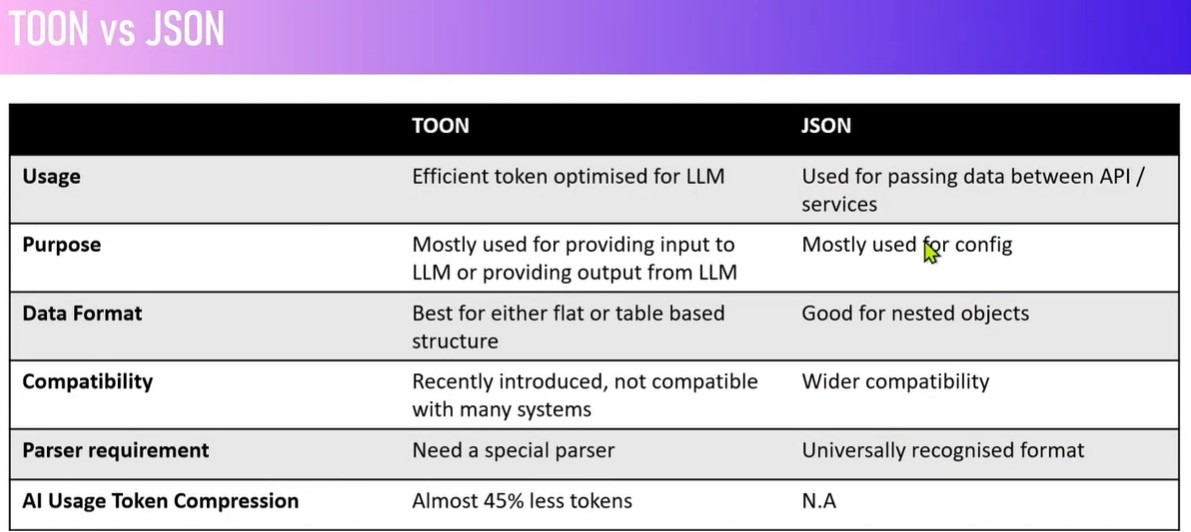
    • Ефективний з точки зору токенів і оптимізований для LLM

    • Структурований і компактний

    • Людиночитабельний

    • Підтримує вкладеність

    • Розроблений спеціально для AI-застосунків

    Характеристики JSON

    • Людиночитабельний і зрозумілий

    • Підтримує глибоко вкладені об’єкти

    • Універсально прийнятий і широко підтримується

    • Підходить для конфігураційних файлів і обміну даними

    • Відкритий стандарт із розвиненою екосистемою інструментів

    Обмеження

    Обмеження TOON

    • Обмежена універсальна підтримка станом на грудень 2025 року

    • Новий і поки що маловідомий формат

    • Потребує спеціального парсера

    • Іноді має труднощі з глибоко вкладеними структурами даних

    Обмеження JSON

    • Надмірна словесність формату

    • Повторювані ключі

    • Дублювання даних збільшує розмір і кількість токенів

    Розширення файлів

    • TOON використовує власне розширення формату

    • JSON використовує розширення .json

    Порівняння використання

    TOON переважно використовується для:

    • Токеноефективного введення даних у LLM

    • Токеноефективного виведення даних з LLM

    • Передавання компактних структурованих даних мовним моделям

    JSON переважно використовується для:

    • Передавання даних між API та сервісами

    • Керування конфігураціями

    • Універсального подання та обміну даними

    Підтримка структур даних

    • TOON найкраще підходить для пласких або табличних структур, але також підтримує вкладеність

    • JSON добре підходить для ієрархічних і вкладених об’єктів

    Сумісність

    • TOON має обмежену сумісність через нещодавнє впровадження

    • JSON має широку сумісність із різними системами та платформами

    Вимоги до парсера

    • TOON потребує спеціального парсера для декодування та інтерпретації даних

    • JSON є універсально розпізнаваним форматом і не потребує спеціальних парсерів

    Ефективність використання токенів

    З точки зору використання токенів TOON забезпечує суттєві переваги. Під час порівняння еквівалентних структур даних TOON може скорочувати кількість токенів приблизно на 45% і більше. У деяких тестах зафіксовано скорочення майже на 60%, залежно від складності даних і використовуваної LLM.

    Приклади структур

    Проста структура TOON може містити:

    • Поле завдання

    • Статус

    • Список кроків, поданий у компактному форматі масиву

    TOON дає змогу гнучко керувати рівнем вкладеності даних. Наприклад, відомості про співробітників або етапи робочих процесів можуть бути представлені на одному рівні вкладеності або розбиті на масиви для підвищення ефективності.

    У порівнянні з JSON ті самі дані у форматі JSON зазвичай містять повторювані ключі та глибшу вкладеність, що збільшує кількість токенів. На високому рівні JSON-структури часто включають батьківські об’єкти, такі як client або workDetails, кожен із яких містить кілька полів і вкладених об’єктів. TOON подає ті самі дані у більш стисненому вигляді.

    Екосистема та ресурси

    Документація JSON містить інформацію про:

    • Історію створення формату

    • Валідні структури JSON

    • Синтаксис

    • Використання JSON для передавання даних між системами

    Документація TOON пояснює:

    • Як JSON кодується в TOON

    • Як працює стиснення з урахуванням схеми

    • Чому потрібен спеціальний парсер

    • Як TOON порівнюється з JSON, YAML, XML, компактним JSON і CSV

    У деяких порівняннях показано скорочення токенів приблизно на 59,8%, а для окремих LLM — ще більше.

    Також існують інструменти та спільноти, які дають змогу:

    • Конвертувати JSON у TOON

    • Завантажувати приклади даних

    • Порівнювати кількість токенів

    • Завантажувати або копіювати результат у форматі TOON

    • Переглядати економію токенів у реальному часі

    Наприклад, проста JSON-структура з 59 токенів може бути перетворена на 24 токени у форматі TOON, що забезпечує економію понад 59%. Для складніших JSON-структур рівень стиснення може бути ще вищим.

    Висновок

    TOON і JSON виконують різні завдання. JSON залишається універсальним стандартом для обміну даними, конфігурацій і взаємодії API. TOON, своєю чергою, є спеціалізованим форматом, орієнтованим на ефективність в AI- та LLM-орієнтованих сценаріях.

    Хоча TOON забезпечує значну економію токенів і компактне подання даних, його обмежене поширення та потреба у спеціальному парсері означають, що наразі він доповнює JSON, а не замінює його. З розвитком AI-застосунків TOON може набути ширшого поширення, особливо в сценаріях, де критичною є ефективність використання токенів.

  • Foundry Local: запуск моделей Azure AI на локальному пристрої

    Вступ до Foundry Local

    Foundry Local — це рішення від Microsoft, яке переносить можливості Azure AI безпосередньо у локальне середовище. Воно дозволяє розробникам запускати AI-моделі повністю на власній інфраструктурі — на настільному комп’ютері, ноутбуці або персональному сервері. Завдяки Foundry Local інференс виконується на пристрої без використання хмари, при цьому зберігається корпоративний рівень безпеки.

    Такий підхід робить Foundry Local зручним вибором для розробників, яким важливі конфіденційність, економія коштів і повний контроль над виконанням AI-моделей.

    Що таке Foundry Local

    Foundry Local — це безкоштовне рішення Microsoft для локального AI-інференсу. Воно дозволяє запускати великі мовні моделі (LLM) та інші AI-моделі локально без необхідності мати підписку Azure або оплачувати хмарні ресурси.

    Платформа підтримує кілька способів інтеграції:

    • інтерфейс командного рядка (CLI);

    • SDK;

    • REST API.

    Це робить Foundry Local гнучким інструментом для інтеграції в різні процеси розробки та застосунки.

    Основні переваги локального запуску AI-моделей

    Використання Foundry Local має низку ключових переваг:

    Конфіденційність

    Усі запити та підказки залишаються в межах локальної системи. Дані не передаються на зовнішні сервери, що особливо важливо для роботи з чутливою інформацією.

    Продуктивність

    Продуктивність залежить від апаратної конфігурації. Foundry Local може використовувати CPU, GPU та NPU, дозволяючи максимально задіяти наявні ресурси.

    Економія коштів

    Оскільки моделі працюють локально, відсутні хмарні платежі, підписки та білінг. Використовуються лише ресурси вашого пристрою.

    Гнучке налаштування

    Розробник повністю контролює вибір моделей, їх конфігурацію та способи інтеграції в застосунки.

    Підтримувані платформи та варіанти встановлення

    Foundry Local підтримує кілька операційних систем і середовищ розробки:

    • Windows — встановлення через пакетний менеджер winget

    • macOS — встановлення за допомогою Homebrew (brew)

    • Доступні SDK:

      • Python

      • JavaScript

      • C#

      • Rust

    У Windows встановлення виконується за допомогою такої команди:

    winget install Microsoft.FoundryLocal

    Після встановлення Foundry Local стає доступним як консольний застосунок.

    Робота з AI-моделями

    Перегляд доступних моделей

    Після встановлення можна переглянути список доступних моделей через CLI. У списку відображається:

    • підтримуваний пристрій виконання (CPU, GPU, NPU);

    • розмір моделі;

    • інформація про ліцензію;

    • варіанти моделей.

    Це дозволяє обрати модель з урахуванням апаратних можливостей і обсягу пам’яті.

    Завантаження та запуск моделей

    Моделі завантажуються до локального кешу та можуть підвантажуватися за потреби. Після запуску Foundry Local надає інтерактивний режим чату для введення запитів.

    Основні CLI-команди:

    • foundry model list — список доступних моделей

    • foundry model info — детальна інформація про модель

    • foundry model run — завантаження та запуск моделі

    • foundry model unload — вивантаження моделі зі сервісу

    Команди інтерактивного чату

    Під час взаємодії з моделлю доступні такі команди:

    • /help — довідка

    • Ctrl + C — скасування генерації

    • /exit — вихід з чату

    Обмеження локальних моделей

    Оскільки Foundry Local працює повністю офлайн, моделі не мають доступу до даних у реальному часі або зовнішніх інструментів. У результаті:

    • відповіді обмежені даними, отриманими під час навчання моделі;

    • запити в реальному часі (наприклад, поточна погода) не можуть бути коректно оброблені;

    • якість відповідей залежить від розміру моделі та якості її навчання.

    Ці обмеження є природним компромісом автономного локального запуску.

    Огляд доступних моделей

    Foundry Local надає доступ до широкого каталогу моделей, які можна фільтрувати та сортувати за:

    • сімейством моделей;

    • розміром файлу;

    • пристроєм виконання (лише CPU, GPU тощо);

    • датою останнього оновлення.

    Для кожної моделі доступна детальна інформація:

    • опис;

    • ліцензія;

    • власник;

    • варіанти моделі;

    • підтримувані завдання.

    Це значно спрощує вибір моделі для конкретних задач.

    Відкритий код і спільнота

    Розробники, які хочуть глибше ознайомитися з Foundry Local, можуть переглянути його репозиторій на GitHub. Там доступні:

    • вихідний код;

    • релізи;

    • учасники проєкту;

    • інформація про розвиток рішення.

    Це забезпечує прозорість і можливості для розширеного налаштування.

    Висновок

    Foundry Local дозволяє запускати AI-моделі безпосередньо на власних пристроях із повною конфіденційністю даних, без хмарних витрат і з гнучкими варіантами розгортання. Його можна використовувати на ноутбуці, настільному комп’ютері або персональному сервері.

    Підтримка кількох платформ, SDK та постійно зростаючий каталог моделей роблять Foundry Local потужним інструментом для розробників, яким потрібен повний контроль над AI-інференсом без залежності від хмарної інфраструктури.

  • Agent 365: Єдина площина керування ШІ-агентами в масштабах організації

    Agent 365: Єдина площина керування ШІ-агентами в масштабах організації

    Вступ до Agent 365

    Agent 365 — це нова площина керування агентами, створена для того, щоб допомогти організаціям централізовано керувати, захищати та масштабувати ШІ-агентів в екосистемі Microsoft. У міру того як компанії все активніше створюють агентів за допомогою різних інструментів і платформ, зростає потреба в централізованому управлінні та прозорості. Agent 365 вирішує цю проблему, надаючи єдине середовище для керування всіма агентами.

    З технологічної точки зору Microsoft, агентів можна створювати за допомогою Copilot Studio, Copilot Studio Light, Azure AI Foundry, SDK, а також розширень для Visual Studio Code. Проте такі агенти часто керуються через різні адміністративні портали, що призводить до фрагментації та ускладнює адміністрування. Agent 365 об’єднує цей досвід у єдину систему.

    Необхідність централізованої площини керування агентами

    Наразі різні типи агентів налаштовуються та керуються через різні інтерфейси:

    • Агенти Microsoft 365 Copilot — через Microsoft 365 Admin Center

    • Агенти Copilot Studio — через Power Platform Admin Center

    • Агенти Azure AI Foundry — через Azure Portal

    Така розрізненість ускладнює відстеження, захист і уніфіковане керування агентами. Agent 365 об’єднує всі агенти в одній площині керування, дозволяючи адмініструвати весь життєвий цикл агентів з єдиного інтерфейсу.

    Для цього кожному агенту присвоюється унікальний ідентифікатор, який забезпечує централізоване керування життєвим циклом, доступом і безпекою.

    Microsoft Entra Agent ID

    Ключовим компонентом Agent 365 є Microsoft Entra Agent ID. Кожен агент отримує власну унікальну ідентичність, яка використовується для:

    • керування життєвим циклом агента

    • контролю доступу та дозволів

    • ідентифікаційної безпеки

    • відповідності вимогам і аудиту

    Такі ідентичності дозволяють застосовувати до ШІ-агентів корпоративні практики керування ідентифікацією та доступом — аналогічно тому, як сьогодні керуються користувачі та застосунки.

    Ключові можливості Agent 365

    Agent 365 побудований на п’яти основних стовпах:

    1. Реєстр агентів

    Реєстр надає консолідований огляд усіх агентів в організації незалежно від того, де вони були створені. До нього входять агенти, створені в Copilot Studio, Copilot Studio Light, Microsoft 365 Copilot Chat та Azure AI Foundry.

    2. Контроль доступу та застосування політик

    Вбудовані механізми застосування політик дозволяють адміністраторам встановлювати єдині правила керування для всіх агентів. Політики можуть регулювати спільне використання, розгортання, використання та права доступу.

    3. Візуалізація та аналітика

    Agent 365 надає аналітику щодо продуктивності агентів, рівня використання, окупності інвестицій і ступеня впровадження. Це допомагає організаціям оцінювати внесок агентів у продуктивність і бізнес-результати.

    4. Інтероперабельність

    Платформа підтримує взаємодію між інструментами Microsoft, open-source технологіями та партнерськими екосистемами. Агенти можуть бути оснащені застосунками й даними для спрощення робочих процесів і підвищення ефективності взаємодії між людиною та агентом.

    5. Безпека та відповідність вимогам

    Agent 365 спирається на корпоративну інфраструктуру безпеки Microsoft і інтегрується з Microsoft Defender, Entra та Purview. Це забезпечує захист ідентичностей, відповідність нормативним вимогам, спостережуваність і виявлення загроз.

    Основні зацікавлені сторони та сценарії використання

    ІТ-адміністратори

    Для ІТ-адміністраторів Agent 365 надає єдину панель для моніторингу активності агентів, застосування політик і керування загрозами безпеки. Керування агентами доступне як через Microsoft 365 Admin Center, так і через Entra Admin Center.

    Керівники та особи, що ухвалюють бізнес-рішення

    Бізнес-керівники можуть використовувати Agent 365 для оцінки впливу агентів на продуктивність і бізнес-результати, що дозволяє ухвалювати більш обґрунтовані стратегічні рішення.

    Інформаційні працівники

    Працівники, які працюють з інформацією, можуть передавати агентам рутинні та монотонні завдання, ефективно співпрацювати з ними та зосереджуватися на більш цінній роботі.

    Фахівці з безпеки

    Команди безпеки отримують централізований контроль над ідентифікацією, автентифікацією, відповідністю вимогам і спостережуваністю. Agent 365 допомагає контролювати розповсюдження агентів і гарантує їх використання лише за призначенням.

    Розробники агентів

    Розробники отримують єдиний SDK і фреймворк, підтримку зовнішніх інструментів і MCP, а також можливість реєструвати, сертифікувати та розгортати агентів по всій організації.

    Керування агентами в Microsoft 365 Admin Center

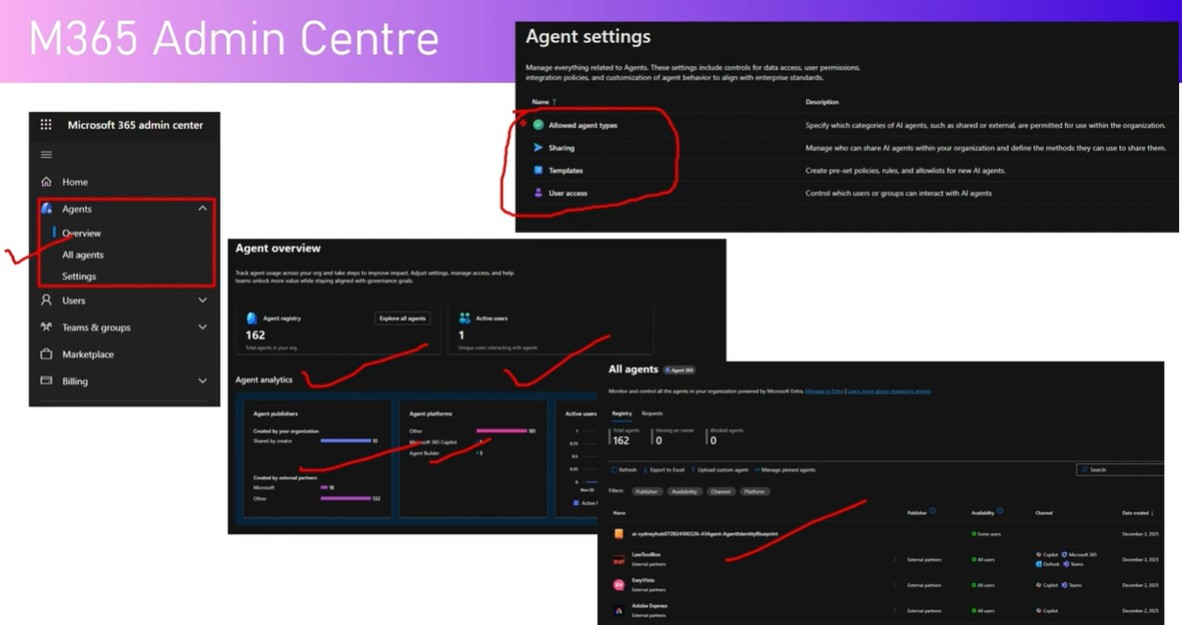
    У Microsoft 365 Admin Center адміністратори можуть:

    • переглядати реєстр агентів і їх загальну кількість

    • відстежувати активних користувачів, видавців і платформи

    • налаштовувати параметри спільного використання та розгортання

    • керувати дозволеними типами агентів (внутрішні, спільні, зовнішні)

    • блокувати, розгортати або видаляти агентів

    • призначати власників агентам для дотримання вимог

    Також можна завантажувати користувацькі агенти за допомогою маніфесту та розгортати їх для окремих користувачів, груп або всієї організації.

    Керування агентами в Microsoft Entra

    Під час створення агента автоматично формується реєстрація застосунку в Microsoft Entra. В Entra Admin Center адміністратори отримують доступ до:

    • ідентичностей агентів та їх object ID

    • дати створення й джерела provisioning

    • корпоративних застосунків, пов’язаних з агентами

    • колекцій агентів і карантинних груп

    Цей рівень надає глибше розуміння того, як агенти автентифікуються та керуються всередині тенанта.

    Шаблони (Blueprints) та колекції агентів

    Шаблони агентів

    Blueprints — це батьківські шаблони, які лежать в основі ідентичностей агентів у тенанті. Вони визначають спосіб provisioning, надання згод і налаштування безпеки. Адміністратори можуть:

    • призначати власників і спонсорів

    • надавати адміністративну або користувацьку згоду

    • вимикати агентів

    • переглядати журнали аудиту та входу

    Власник керує всією ідентичністю агента, тоді як спонсор відповідає за контроль життєвого циклу.

    Колекції агентів

    життєвого циклу.

    Колекції агентів

    Колекції агентів дозволяють групувати агентів автоматично або вручну. Такі колекції можуть використовуватися для сценаріїв керування, зокрема глобального карантину або додаткових вимог відповідності.

    Висновок

    Agent 365 надає повнофункціональну корпоративну платформу для керування ШІ-агентами в екосистемі Microsoft. Завдяки єдиній площині керування, агентським ідентичностям на базі Entra та глибокій інтеграції з інструментами безпеки й адміністрування Microsoft, Agent 365 дозволяє безпечно, послідовно та ефективно масштабувати використання ШІ-агентів.

    У міру зростання кількості агентів Agent 365 стає ключовим елементом керування, безпеки та операційної стійкості в робочому середовищі, орієнтованому на штучний інтелект.

  • Основні мережеві концепції, які повинен розуміти кожен інженер-програміст

    Основні мережеві концепції, які повинен розуміти кожен інженер-програміст

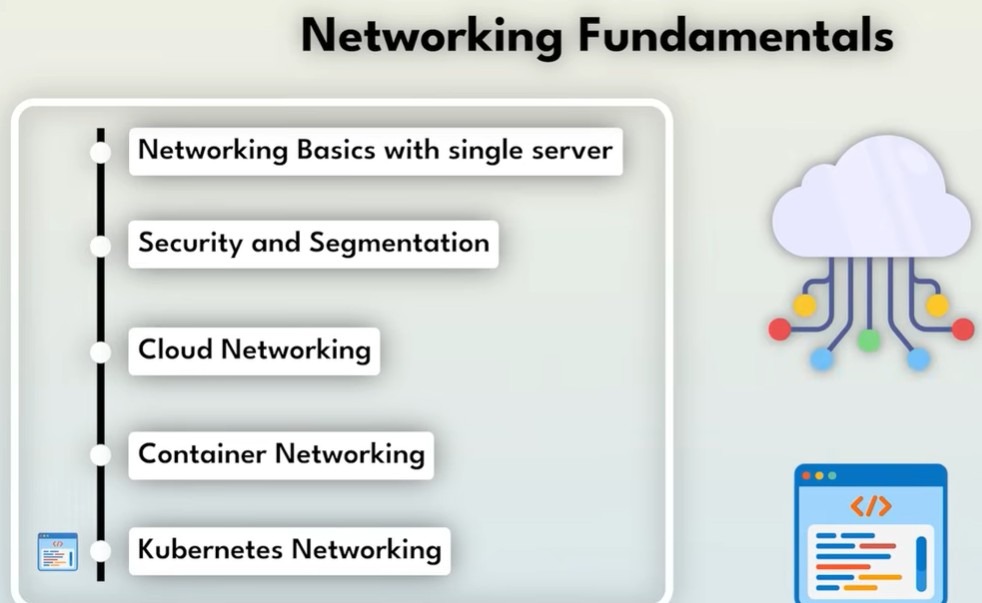
    Мережеві технології є базовою навичкою для кожного інженера-програміста. Щоб по-справжньому зрозуміти, навіщо існують мережеві концепції та які реальні проблеми вони вирішують, корисно розглядати їх у дії, а не в ізоляції.

    У цій статті ми простежимо розвиток вигаданої платформи бронювання подорожей TravelBody. У міру того як застосунок еволюціонує від одного сервера до складної хмарної системи, ми розбиратимемо кожну мережеву концепцію саме тоді, коли вона стає необхідною.

    Від одного сервера до інтернету

    Коли TravelBody лише запускався, увесь застосунок працював на одному сервері. Така архітектура була простою, але одразу виникло важливе питання: як користувачі знаходять сервер в інтернеті?

    IP-адреси: ідентифікація пристроїв у мережі

    Кожному пристрою, підключеному до мережі, потрібен унікальний ідентифікатор, щоб інші пристрої знали, куди надсилати дані. Цей ідентифікатор називається IP-адресою. Вона працює так само, як поштова адреса будинку: без неї доставка даних неможлива.

    Сервер TravelBody отримав публічну IP-адресу, завдяки чому будь-який пристрій в інтернеті може надсилати запити безпосередньо на цей сервер.

    DNS: зручні для людей імена

    Запам’ятовувати IP-адреси незручно, тому використовується DNS (Domain Name System). DNS перетворює легко запам’ятовувані доменні імена на IP-адреси.

    Коли користувач вводить travelbody.com у браузері, DNS автоматично знаходить відповідну IP-адресу та під’єднує користувача до потрібного сервера. Це схоже на вибір контакту за ім’ям у телефоні замість набору повного номера.

    Кілька застосунків на одному сервері

    Зі зростанням TravelBody на одному сервері почали працювати одразу кілька компонентів:

    • користувацький вебсайт

    • база даних з інформацією про бронювання

    • сервіс обробки платежів

    Усі вони використовували одну й ту саму IP-адресу, що створило нову проблему.

    Порти: спрямування трафіку до потрібного застосунку

    Цю проблему вирішують порти. Порти — це пронумеровані канали зв’язку на сервері, від 1 до 65 535. Кожен застосунок «слухає» свій порт.

    Наприклад:

    • вебзастосунок: порт 80 (HTTP) або 443 (HTTPS)

    • база даних MySQL: порт 3306

    • платіжний сервіс: порт 9090

    Коли запит надходить на сервер, номер порту вказує операційній системі, якому застосунку його передати. IP-адреса — це адреса будівлі, а порти — номери квартир усередині неї.

    Підвищення безпеки за допомогою сегментації мережі

    Зберігання платіжних даних і персональної інформації на одному сервері створювало серйозні ризики безпеки. У разі зламу зловмисник отримував би доступ до всього одразу.

    Підмережі: поділ мережі

    Для зменшення ризиків було впроваджено мережеву сегментацію з використанням підмереж. Підмережі ділять мережу на ізольовані зони з різним призначенням:

    • публічна підмережа для фронтенд-серверів

    • приватна підмережа для серверів застосунків

    • окрема підмережа для баз даних

    Такий поділ обмежує доступ і зменшує наслідки можливих атак.

    Маршрутизація: з’єднання сегментів

    Коли з’являються підмережі, їх потрібно з’єднувати. Маршрутизація визначає, як дані переміщуються між сегментами мережі — подібно до GPS, який прокладає маршрут з точки А в точку Б.

    Контроль трафіку за допомогою міжмережевих екранів

    Те, що мережі можуть обмінюватися даними, не означає, що їм слід робити це без обмежень. Тут на сцену виходять міжмережеві екрани (firewalls).

    Firewalls: застосування правил безпеки

    Міжмережевий екран перевіряє мережевий трафік і дозволяє або блокує його відповідно до заданих правил.

    Існує два основні типи:

    • host-firewalls, які захищають окремі сервери

    • network-firewalls, які фільтрують трафік між підмережами

    Наприклад:

    • сервер бази даних приймає з’єднання лише на порт 3306 і лише з підмережі застосунків

    • фронтенд-підмережа приймає вхідний інтернет-трафік лише на портах 80 і 443

    Багаторівневий захист означає, що зловмиснику доведеться пройти кілька рівнів безпеки, щоб завдати шкоди.

    Приватні мережі та доступ до інтернету

    Зі зростанням TravelBody з’явилися десятки бекенд-серверів, що працюють у приватних підмережах. Ці сервери використовують приватні IP-адреси, які недоступні напряму з інтернету.

    NAT: безпечний вихід в інтернет

    Водночас приватним серверам усе одно потрібен доступ до інтернету, наприклад для:

    • завантаження оновлень

    • звернення до зовнішніх API

    Цю задачу вирішує NAT (Network Address Translation). NAT дозволяє кільком серверам із приватними IP-адресами використовувати одну публічну IP-адресу для вихідних з’єднань.

    Процес виглядає так:

    1. сервер надсилає запит на NAT-пристрій

    2. NAT замінює приватну IP-адресу на публічну

    3. відповідь з інтернету повертається потрібному серверу

    Таким чином сервери залишаються прихованими, але мають доступ до зовнішніх ресурсів.

    Перехід у хмару

    Керування фізичними серверами стало дорогим і повільним, тому TravelBody перейшов у хмару, орендуючи обчислювальні ресурси замість володіння обладнанням.

    Мережеві принципи залишаються незмінними

    Хоча інфраструктура змінилася, мережеві основи залишилися тими самими:

    • IP-адреси

    • порти

    • підмережі

    • маршрутизація

    • firewalls

    • NAT

    У хмарі ці елементи надаються як керовані сервіси.

    Virtual Private Cloud (VPC)

    VPC — це ізольована частина мережі хмарного провайдера. Це схоже на оренду власного поверху у великій офісній будівлі. Усередині VPC TravelBody відтворив знайому архітектуру з публічними та приватними підмережами, таблицями маршрутизації, інтернет-шлюзами та NAT-шлюзами.

    Контейнери та переносимість застосунків

    Під час переходу до мікросервісної архітектури складність розгортання різко зросла. Відмінності між середовищами розробки та продакшену почали спричиняти помилки.

    Контейнери: пакування застосунків

    Контейнери пакують усе необхідне для роботи застосунку — код, середовище виконання, бібліотеки та налаштування — в один переносимий об’єкт. Це гарантує однакову поведінку застосунку в різних середовищах.

    Для контейнеризації сервісів TravelBody використовувався Docker.

    Мережеве взаємодіяння контейнерів

    Контейнери взаємодіють через:

    • bridge-мережі для зв’язку на одному сервері

    • проброс портів, який дозволяє отримувати доступ до контейнерів ззовні

    • overlay-мережі, що об’єднують контейнери на різних серверах в одну віртуальну мережу

    Ці механізми по суті повторюють знайомі мережеві концепції, такі як NAT і маршрутизація.

    Kubernetes: керування контейнерами в масштабі

    Коли TravelBody почав запускати сотні контейнерів на десятках серверів, ручне керування стало неможливим.

    Поди та IP-адреси

    У Kubernetes контейнери запускаються всередині подів. Кожен под отримує власну IP-адресу, спільну для всіх контейнерів усередині нього.

    Однак поди є тимчасовими: вони можуть видалятися, пересоздаватися й переміщуватися, а їхні IP-адреси змінюються.

    Сервіси: стабільна мережа для динамічних подів

    Цю проблему вирішують Kubernetes-сервіси. Сервіс надає:

    • постійну IP-адресу

    • стабільне DNS-ім’я

    Сервіс автоматично спрямовує трафік до працездатних подів, навіть якщо вони пересоздаються. Застосунки підключаються до сервісу, а не до конкретного поду.

    Публікація застосунків за допомогою Ingress

    Щоб зробити сервіси доступними з інтернету, в Kubernetes використовується Ingress.

    Ingress виступає єдиною точкою входу, розподіляючи вхідні запити між сервісами на основі доменів або шляхів URL.

    Наприклад:

    • запити до travelbody.com спрямовуються до вебсервісу

    • API-запити — до сервісів бронювання або платежів

    Ключові мережеві основи: підсумок

    Простеживши шлях TravelBody, ми виділили п’ять фундаментальних мережевих концепцій:

    1. IP-адреси та DNS — ідентифікація пристроїв і перетворення імен

    2. Порти — спрямування трафіку до потрібного застосунку

    3. Підмережі та маршрутизація — організація мережі та з’єднання сегментів

    4. Firewalls — контроль і захист мережевого трафіку

    5. NAT — безпечний доступ приватних систем до інтернету

    Ці принципи працюють усюди: на фізичних серверах, у хмарі, в контейнерах і в Kubernetes. Інструменти змінюються, але основи залишаються незмінними.

    Опанувавши ці фундаментальні концепції, інженер зможе розуміти, проєктувати та ефективно усувати проблеми в системах будь-якого масштабу.

  • Погляд у минуле: класичні рекомендації з безпеки .NET

    Неочікувана знахідка у світі безпеки

    Кілька тижнів тому обговорення однієї вразливості безпеки в .NET переросло у своєрідну подорож у минуле. У результаті була знайдена несподівана річ — книга The Developer Highway Code, яка роками перебувала на видноті, але залишалася поза увагою.

    Книга була опублікована у 2006 році за участі Microsoft UK і замислювалася як практичний посібник зі створення більш безпечних .NET‑застосунків. Попри свій вік, багато ідей, викладених у ній, залишаються дивовижно актуальними й сьогодні.

    Що таке The Developer Highway Code

    Підзаголовок книги — The Drive for Safer Coding («Курс на безпечне програмування»). Вона має на меті навчити розробників принципів безпечної інженерії програмного забезпечення за допомогою зрозумілих пояснень, структурованих чек-листів і навіть гумору.

    У книзі розглядається широкий спектр тем — від мережевої інфраструктури до доступу до баз даних — на прикладі платформи .NET. Окремої уваги заслуговує стиль подачі: серйозні рекомендації з безпеки поєднуються з іронічними застереженнями та наочними метафорами, що робить матеріал більш запам’ятовуваним. Хоча деякі жарти сьогодні виглядають застарілими, вони додають книзі характеру.

    Структура та основні розділи

    Книга складається з двох великих частин:

    • Частина перша: безпечна інженерія — принципи, концепції та можливості платформи
    • Частина друга: чек-листи та списки запитань — практичні кроки для перевірки безпеки на різних рівнях

    Хоча згадки про .NET Framework 1.1 сьогодні виглядають архаїчними, матеріали, присвячені .NET 2.0, у свій час стали важливим кроком уперед у сфері безпечної розробки.

    Безпека мережі та інфраструктури

    Однією з найсильніших сторін книги є детальні чек-листи. Зокрема, в ній рекомендується:

    • встановлювати останні оновлення безпеки;
    • підписуватися на повідомлення виробників про виявлені вразливості;
    • блокувати завідомо вразливі порти;
    • увімкнути фільтрацію вхідного та вихідного трафіку;
    • перевіряти ICMP-трафік;
    • надійно захищати адміністративні інтерфейси маршрутизаторів;
    • вимикати невикористовувані сервіси, такі як TFTP (Trivial File Transfer Protocol).

    Навіть через десятиліття ці рекомендації залишаються основою правильної мережевої гігієни безпеки.

    Захист від SQL-інʼєкцій

    Рекомендації щодо безпеки роботи з базами даних виглядають особливо сучасно. Автори наполягають на такому:

    • використовувати збережені процедури з параметрами;
    • за відсутності збережених процедур застосовувати строго типізовані SQL-параметри;
    • підключатися до бази даних з обліковими записами з мінімально необхідними правами.

    Дивує, наскільки мало змінилися ці базові принципи за минулі роки.

    Що нового принесла .NET 2.0

    На момент виходу книги .NET 2.0 запропонувала низку важливих покращень у сфері безпеки:

    • програмне керування списками контролю доступу (ACL) з керованого коду;
    • налаштування MachineKey для узгодженого шифрування та автентифікації;
    • ClickOnce із пісочницею для виконання Windows Forms-застосунків;
    • Code Access Security (CAS) для обмеження прав коду;
    • класи ConnectionStringBuilder для безпечнішої роботи зі строками підключення;
    • SecureString для захисту конфіденційних даних у памʼяті.

    Багато з цих механізмів вирішували завдання, які й сьогодні залишаються актуальними — задовго до появи контейнерів і сучасних систем ізоляції.

    Безпека на рівні застосунків

    У книзі детально описуються практики валідації даних і захисту застосунків:

    • перевірка вхідних даних за допомогою регулярних виразів;
    • використання вбудованих валідаторів ASP.NET;
    • повна відмова від довіри до користувацького вводу;
    • за можливості — відмова від динамічних SQL-запитів;
    • перевірка всіх недовірених даних на рівні доступу до даних.

    Попри те що приклади належать до епохи до MVC та сучасних фреймворків, сам підхід до безпеки залишається актуальним.

    Рекомендації з проєктування класів

    Особливу увагу приділено обʼєктно-орієнтованому дизайну:

    • використовувати максимально обмежувальні модифікатори доступу;
    • закривати (sealed) базові класи, не призначені для наслідування;
    • зберігати поля приватними та надавати доступ через властивості;
    • робити властивості лише для читання, якщо запис не потрібен;
    • застосовувати сувору ідентифікацію збірок і механізми прозорості безпеки за потреби.

    Деякі з цих рекомендацій сьогодні викликають дискусії, проте вони добре відображають підхід до безпеки в ранній екосистемі .NET.

    Безпека передавання даних

    Автори рекомендують:

    • використовувати шифрування транспортного рівня для захисту секретів;
    • застосовувати IPSec для взаємодії між серверами;
    • використовувати SSL для захисту каналів на рівні застосунків.

    Хоча термінологія змінилася і сьогодні використовується TLS, сама ідея захисту даних під час передавання залишається незмінною.

    Корисна подорож у минуле

    Повернення до The Developer Highway Code — це водночас ностальгія й нагадування про те, що основи безпеки майже не змінюються з часом.

    Авторами книги є Філ Вінстанлі, технічний євангеліст Microsoft UK, та Алекс Макман, головний технолог компанії CM Group Limited. Їхня робота залишається цінним історичним зрізом поглядів на безпеку .NET середини 2000‑х років.

    Навіть без ISBN і широкої доступності сьогодні ця книга й досі становить інтерес для всіх, хто хоче краще зрозуміти еволюцію безпечної розробки програмного забезпечення.

  • .NETConf 2025: ключові тренди та основні висновки

    .NETConf 2025: ключові тренди та основні висновки

    Це моя улюблена пора року — час одягати .NET-капелюх, адже стартує .NETConf 2025. Якщо озирнутися назад, добре видно, як із року в рік змінювався фокус конференції та що це говорить про напрям розвитку екосистеми .NET.

    Погляд у минуле: від Aspire до модернізації

    Рік тому головною темою був Aspire. Він був буквально всюди. Приблизно пів року потому акцент змістився на модернізацію — багато говорили про те, як допомогти командам оновлювати наявні системи. Це викликало чимало запитань, занепокоєння та активних обговорень у спільноті, адже багато хто намагався зрозуміти, куди все рухається.

    Цього року очікування були стриманими й навіть скептичними. Було відчуття, що все може виглядати незграбно або відірвано від реальності. Однак стало очевидно, що зворотний зв’язок почули — і зробили висновки.

    Упевнений початок і знайоме обличчя

    Відкриття конференції за участі Скотта Хансельмана з відсилками до класичного ASP.NET MVC стало приємною несподіванкою. Для досвідчених розробників це виглядало особливо тепло та доречно. Порівняно з минулим роком, коли старт для багатьох був незрозумілим і відстороненим, цього разу все одразу стало на свої місця.

    Для досвідчених .NET-розробників такий підхід задав більш упевнений і зрозумілий тон усьому заходу.

    Aspire залишається важливим, але вже не домінує

    Aspire і надалі є ключовою частиною платформи, проте він помітно подорослішав. Платформу оновили та перейменували на Aspire 13, повністю відмовившись від назви «.NET Aspire».

    Амбіції очевидні: Aspire позиціонується як система оркестрації інфраструктури, здатна зацікавити навіть поліглотні команди — середовища, де C# є лише частиною технологічного стеку. Якщо Microsoft зможе досягти цього, результат буде справді вражаючим.

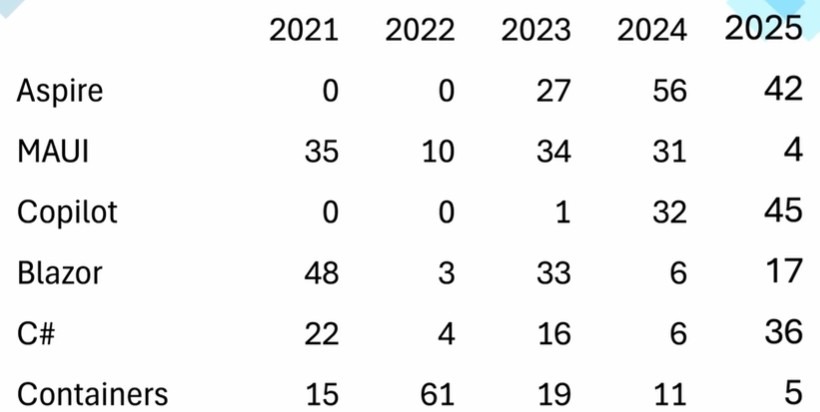
    З погляду кількості згадувань:

    • Aspire згадувався 42 рази під час основної доповіді.
    • Минулого року — 56 разів.

    Це помітне зниження, але воно радше свідчить про перерозподіл уваги, а не про втрату значущості.

    Зростання ролі Copilot і увага до C#

    Менша кількість згадувань Aspire значною мірою пояснюється зростаючим фокусом на Copilot. Кількість згадувань Copilot зросла приблизно на 50% порівняно з минулим роком. Водночас C# отримав гідну увагу, що ще раз підтверджує його центральну роль в екосистемі.

    У результаті основна доповідь виглядала більш збалансованою та продуманою, ніж у попередні роки.

    Зміна акцентів в екосистемі

    Якщо порівняти згадування ключових тем за останні чотири роки, можна виокремити кілька тенденцій:

    • Контейнери поступово втрачають пріоритет.
    • Blazor переживає певне відродження. Раніше здавалося, що він наближається до занепаду, але цього року отримав цілком гідну увагу.
    • Ці дані не є науковими, але вони дають загальне уявлення про стратегічний напрям.

    Головний сюрприз: .NET MAUI

    Найбільш несподіваним моментом цього року став .NET MAUI.

    • MAUI згадувався лише чотири рази протягом усієї доповіді.
    • Минулого року — понад 30 разів.

    Дехто стверджує, що це не означає проблем для MAUI — і, можливо, так воно і є. Проте таке різке зниження уваги складно ігнорувати. Кожен може трактувати ці цифри по-своєму, але сам зсув очевидний.

    Blazor і кінець одного слова-паразита

    Blazor згадувався 17 разів, що підтверджує його оновлену актуальність. Але, мабуть, найвражаючий факт цього року такий:

    • Слово «folks» не прозвучало жодного разу.

    З огляду на те, наскільки часто його використовували в попередні роки, його повна відсутність виглядає майже неймовірною — і для багатьох стала приємною зміною.

    Вихід Visual Studio 2026

    Ще однією важливою подією став реліз Visual Studio 2026. Це сильна й зріла версія з помітними покращеннями продуктивності та зручності роботи. Водночас не варто очікувати дива, якщо запускати її на слабкому обладнанні — середовище розробки потребує серйозних ресурсів.

    Підсумки

    Загалом .NETConf 2025 виглядає більш приземленим, усвідомленим і орієнтованим на свою аудиторію, ніж попередні заходи. Aspire залишається в центрі уваги, Copilot стрімко набирає вагу, а перевірені часом технології на кшталт C# і Blazor упевнено утримують свої позиції.

    Головне питання залишається відкритим: що чекає на .NET у найближчий рік?

  • Що таке MLOps і навіщо він потрібен

    Що таке MLOps і навіщо він потрібен

    У цій статті ми розберемо, що таке MLOps, навіщо він потрібен і як він допомагає вирішувати реальні проблеми під час впровадження моделей машинного навчання у роботу. Пояснимо на зрозумілих прикладах, зокрема на системі виявлення шахрайства в банку.

    Що таке MLOps

    MLOps (Machine Learning Operations) — це набір практик і інструментів, які допомагають переносити моделі машинного навчання з середовища розробки в надійне промислове оточення, а також підтримувати їх стабільну й ефективну роботу.

    Якщо пояснювати простіше:

    • MLOps допомагає запускати моделі у продакшені без помилок.

    • Стежити за їх роботою.

    • Швидко оновлювати моделі, коли дані змінюються або з’являються нові загрози, наприклад нові види шахрайства.

    Проблема: модель працює на ноутбуці, але ламається у продакшені

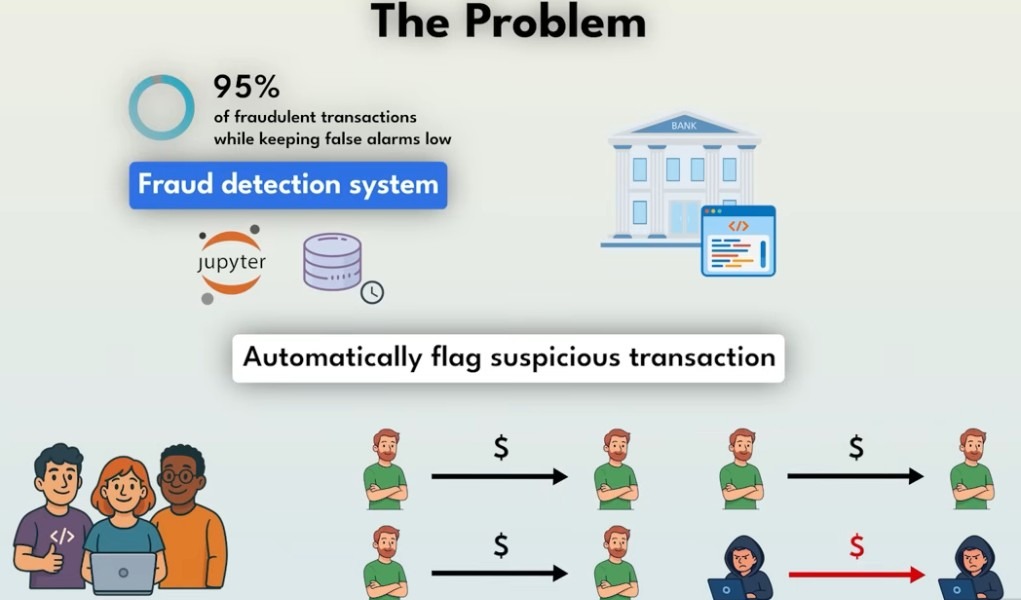
    Уявімо, що банк створив модель для виявлення шахрайства.
    На ноутбуці дата-саєнтиста вона ідеально визначає 95% шахрайських операцій.

    Але після запуску у продакшені все йде не так гладко.

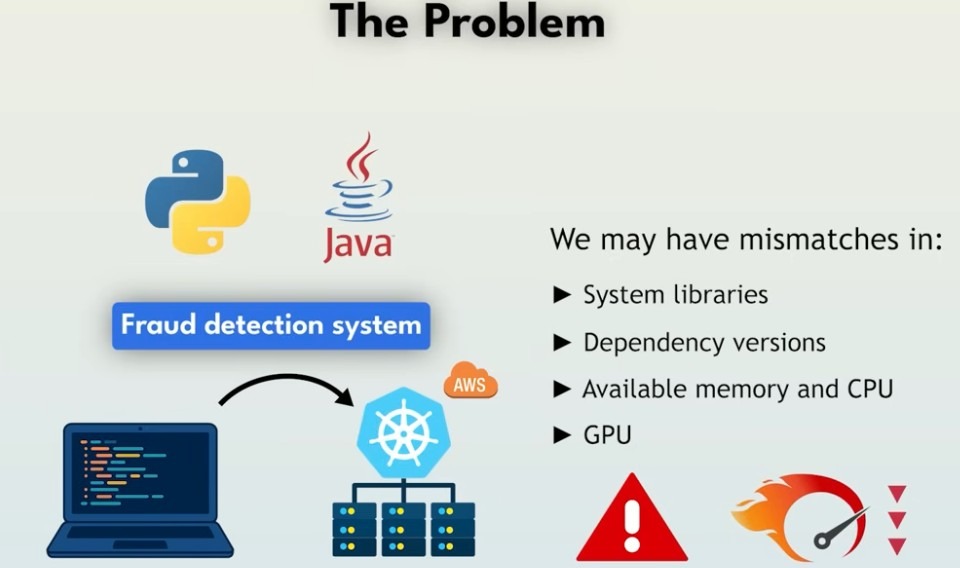
    1. Різні мови та бібліотеки

    Модель розробили на Python, а продакшен працює на Java, тому що банки використовують її заради стабільності й безпеки.
    Доводиться переписувати модель вручну — це довго й ризиковано.

    2. Продуктивність

    На ноутбуці модель працює швидко, але в продакшені вона обробляє транзакцію по 3 секунди.
    Банку потрібні мілісекунди, інакше система не встигатиме перевіряти тисячі операцій на хвилину.

    3. Неспівпадіння оточення

    На ноутбуці одні версії бібліотек, у кластері AWS — інші.
    Це створює помилки та непередбачувану поведінку.

    4. Деградація якості (data drift)

    Через місяць з’являються нові схеми шахрайства.
    Модель їх не знає — і починає пропускати.

    5. Відсутність відтворюваності

    Не збережені дані, параметри, версії.
    Неможливо повторити навчання чи відновити роботу вихідної моделі.

    6. Немає моніторингу

    Команда дізнається про проблему лише після скарг клієнтів.

    Як MLOps вирішує всі ці проблеми

    1. Консистентне оточення: Docker

    Модель упаковується у контейнер разом із залежностями.
    Тепер вона працює однаково:

    • на ноутбуці,

    • на сервері розробки,

    • у продакшені.

    2. Масштабування: Kubernetes

    Модель розгортається у Kubernetes (наприклад, Amazon EKS), який:

    • автоматично масштабує кількість екземплярів,

    • перезапускає впалі контейнери,

    • забезпечує стабільність під великим навантаженням.

    Конфігурація зберігається як infrastructure as code — наприклад, у Terraform.

    3. CI/CD для ML

    Перед кожним релізом модель проходить:

    • тести точності,

    • тести швидкості,

    • інтеграційні тести,

    • навантажувальні тести.

    Якщо модель працює надто повільно — її не розгортають у продакшен.

    4. Відстеження дрейфу даних

    Інструменти на кшталт:

    • TensorFlow Data Validation,

    • Great Expectations

    перевіряють, чи змінилася структура або розподіл даних.

    Якщо з’являються нові патерни шахрайства — система надсилає alert.

    5. Трекінг експериментів

    Застосовують MLflow або DVC.
    Зберігаються:

    • версії даних,

    • параметри моделі,

    • метрики,

    • артефакти навчання.

    Модель завжди можна перебудувати точно так само.

    6. Моніторинг та алертинг

    Застосовують Prometheus і Grafana:

    • точність моделі,

    • швидкість обробки транзакцій,

    • кількість хибних спрацювань,

    • помилки.

    Якщо метрики погіршуються — надсилається сповіщення.

    7. Швидкі оновлення моделей

    За допомогою Argo CD, GitHub Actions або GitLab CI:

    • оновлення моделі відбувається без зупинки сервісу,

    • можна відкотитись на попередню версію,

    • моделі можна випускати автоматично.

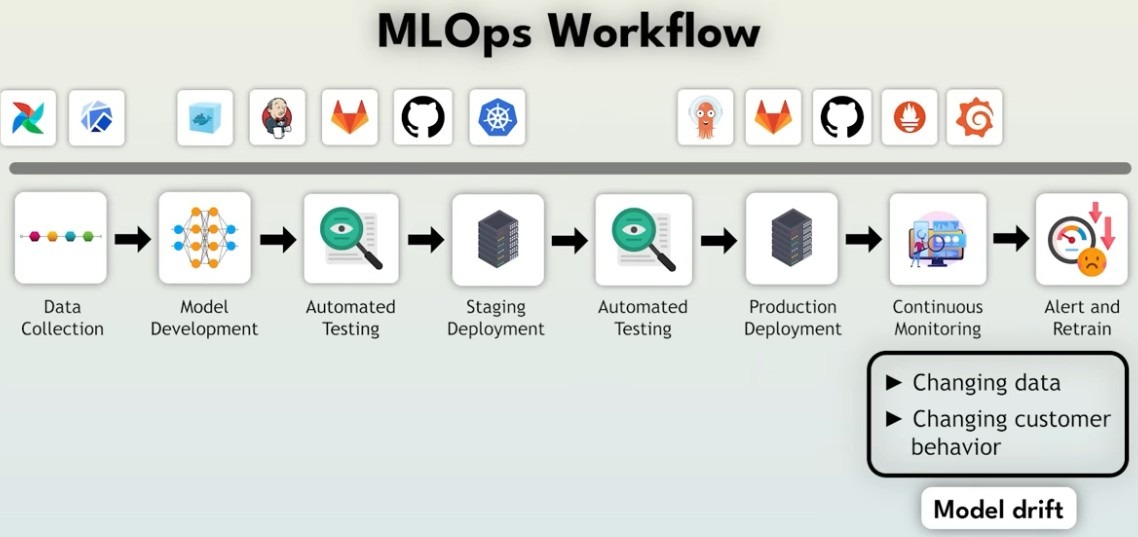
    Приклад повного MLOps-процесу

    1. Data Engineers збирають та очищають дані (Airflow, Kubeflow).

    2. Data Scientists тренують моделі в Docker-контейнерах.

    3. CI/CD запускає тести точності та продуктивності.

    4. Модель розгортається на staging-оточенні в Kubernetes.

    5. Якщо все добре — оновлюється продакшен.

    6. Monitoring постійно стежить за якістю.

    7. При дрейфі даних запускається оновлення або повторне навчання.

    Кому потрібен MLOps

    ✔ Data Scientists — щоб їх моделі працювали не лише в ноутбуці.

    ✔ DevOps Engineers — більшість навичок уже є, потрібна ML-специфіка.

    ✔ Engineering Managers — щоб оцінювати складність ML-проєктів.

    ✔ Cloud Engineers — ML потребує GPU, швидкого зберігання та потужних мереж.

    Підсумок

    MLOps — це міст між експериментами в ноутбуці та реальними промисловими системами.
    Він робить моделі:

    • відтворюваними,

    • надійними,

    • швидкими,

    • простими в оновленні.

    Якщо ви працюєте в Data Science, DevOps, Cloud або керуєте ML-командами — володіння MLOps стає необхідною та дуже цінною навичкою.