Автор: admin

  • Сучасний підхід до мультихмарних стратегій і мережевої взаємодії в Azure та інших хмарах

    У сучасному цифровому світі дедалі більше організацій переходять до мультихмарних стратегій, використовуючи можливості кількох хмарних провайдерів для досягнення гнучкості, відмовостійкості та глобального охоплення. Зазвичай сюди входить Microsoft Azure, але також активно використовуються Amazon Web Services (AWS), Google Cloud Platform (GCP), Oracle Cloud Infrastructure (OCI) та інші.

    Однак управління кількома хмарами створює низку викликів: governance, безпека, ідентифікація, архітектура застосунків, розміщення даних, експлуатація та DevOps — усі ці аспекти потрібно враховувати одночасно. У цій статті основна увага приділена мережевій взаємодії між хмарами та всередині них, водночас важливо пам’ятати, що повноцінна мультихмарна стратегія неможлива без єдиного управління безпекою та політиками.

    Мережеві основи в Azure

    Базовим елементом мережевої інфраструктури Azure є Virtual Network (VNet). Кожна віртуальна мережа:

    • існує в межах певної підписки і не може охоплювати кілька підписок;

    • розташована в одному регіоні Azure, тобто не може бути розподілена між регіонами;

    • визначається одним або кількома діапазонами IPv4 (і за потреби IPv6).

    У межах VNet розгортаються ресурси — віртуальні машини (VM), контейнери та служби. Хоча не всі служби Azure спочатку є частиною VNet, багато з них можна інтегрувати для приватного підключення, минаючи публічні точки доступу й зменшуючи ризики взаємодії з інтернетом.

    Підмережі та інтеграція сервісів

    Кожна VNet поділяється на підмережі (subnets), у яких розміщуються ресурси. Існує два основних способи інтеграції сервісів Azure у мережу:

    1. Delegated Subnets – деякі сервіси (наприклад, бази даних) можна розгортати в підмережах, делегованих конкретному сервісу. Це забезпечує доступ до них через приватні IP-адреси.

    2. Private Endpoints – спеціальні мережеві інтерфейси, які підключають PaaS-сервіси Azure до вашої підмережі. Це забезпечує захищений доступ до них через внутрішню мережу.

    В обох випадках зберігається приватне та безпечне з’єднання з сервісами, навіть якщо вони знаходяться за межами мережі.

    DNS та безпека

    DNS відіграє критичну роль у забезпеченні коректного підключення. Оскільки більшість з’єднань захищено за допомогою TLS, правильне розв’язання імен (DNS resolution) необхідне для відповідності сертифікатів TLS доменним іменам.
    Azure пропонує Private DNS Zones і підтримує conditional forwarding для коректного розв’язання імен між пов’язаними мережами й локальними середовищами.

    Гібридна хмарна взаємодія

    Більшість організацій уже працюють у гібридному середовищі, поєднуючи локальну інфраструктуру з хмарними сервісами.
    Під час підключення локальної мережі до Azure існують два основних типи з’єднань:

    • Публічне підключення

    • Приватне підключення

    Глобальна мережа Microsoft

    Microsoft володіє однією з найбільших приватних мереж у світі:

    • понад 165 000 миль оптоволоконних і підводних кабелів, що з’єднують 60+ регіонів Azure;

    • понад 185 глобальних точок присутності (PoP), де здійснюється взаємодія з іншими мережами й інтернетом.

    Ця мережа використовується як для публічних, так і для приватних з’єднань.

    Приватне підключення: ExpressRoute

    Для високопродуктивних і надійних з’єднань Azure пропонує ExpressRoute.
    Як це працює:

    1. Організація підключається від свого дата-центру до точки присутності (PoP), де доступна глобальна мережа Microsoft.

    2. Провайдер зв’язку організовує крос-підключення до маршрутизаторів Microsoft.

    3. У Azure розгортається ExpressRoute Gateway, який керує трафіком між хмарою та локальним середовищем.

    Кожне з’єднання ExpressRoute має дві фізичні лінії для відмовостійкості.
    Для критичних систем рекомендується використовувати кілька каналів у різних містах.

    Публічне підключення: Site-to-Site VPN

    Більш доступною альтернативою є Site-to-Site VPN — зашифрований тунель через інтернет між локальним VPN-пристроєм і Azure VPN Gateway.
    Це дешевше, але має більшу затримку й варіативність продуктивності.
    Часто використовується як резервне з’єднання для ExpressRoute.

    З’єднання між віртуальними мережами

    Оскільки кожна VNet обмежена регіоном і підпискою, великі компанії зазвичай мають десятки таких мереж.
    Azure підтримує кілька способів їх об’єднання:

    • VNet Peering – пряме з’єднання двох мереж за умови, що їхні IP-адреси не перетинаються.

    • Hub-and-Spoke – центральна мережа (hub) підключає кілька «спиць» (spokes). Хаб містить спільні сервіси: DNS, файрвол, шлюзи тощо.

    • Azure Virtual WAN – керована служба, що спрощує масштабне підключення.

    • Azure Virtual Network Manager – централізоване управління маршрутами та зв’язністю.

    Зв’язок між хмарами (Multicloud Connectivity)

    Далі розглянемо взаємодію між різними хмарами — наприклад, між Azure, AWS, GCP або OCI.
    Кожен великий провайдер має подібну мережеву модель:

    • AWS — VPC (Virtual Private Cloud)

    • GCP — VPC (Virtual Private Cloud)

    • OCI — VCN (Virtual Cloud Network)

    Ці мережі можуть підключатися як до інтернету, так і до приватних каналів.

    VPN-з’єднання між хмарами

    Найпростіший спосіб з’єднати Azure з іншою хмарою — Site-to-Site VPN, який створює зашифрований тунель між двома шлюзами.
    Метод безпечний, але обмежений швидкістю (до 1 Гбіт/с) і стабільністю.
    Підходить для тестових або резервних сценаріїв.

    Приватне міжхмарне підключення

    У кожного провайдера є власні рішення, аналогічні ExpressRoute:

    • AWS Direct Connect

    • Google Cloud Interconnect

    • Oracle FastConnect

    Ці сервіси використовують ті ж самі PoP-центри, що й Microsoft, що дозволяє організувати пряму міжхмарну взаємодію.
    Основне правило — обирати географічно близькі регіони (наприклад, Azure London і AWS London) для зниження затримки.

    Варіанти підключення

    1. Пряме підключення (Dedicated)

      • Використання власних маршрутизаторів.

      • Пропускна здатність до 100 Гбіт/с.

      • Підходить для великих підприємств.

    2. Cloud Exchange-провайдери (наприклад, Equinix, Megaport)

      • Вони беруть на себе складну маршрутизацію.

      • Оптимальний варіант для компаній, що віддають перевагу керованим рішенням.

    Також можна налаштувати VPN як резервне з’єднання для підвищення надійності.

    Особливий випадок: Azure – Oracle Interconnect

    Microsoft і Oracle пропонують спільне рішення Oracle Interconnect for Azure, яке поєднує ExpressRoute та FastConnect.
    Це забезпечує мінімальну затримку між регіонами (наприклад, між Azure London і OCI London).

    Продуктивність і оптимізація

    Щоб досягти максимальної ефективності:

    • Увімкніть ExpressRoute FastPath, щоб трафік оминав шлюз.

    • Забезпечте єдине DNS-розв’язання.

    • Використовуйте резервні канали в різних PoP для відмовостійкості.

    Безпека, управління та моніторинг

    Мультихмарна взаємодія має супроводжуватися:

    • Централізованим моніторингом безпеки (логи, метрики, сповіщення);

    • Єдиним управлінням і дотриманням політик (наприклад, через Azure Arc);

    • Узгодженим управлінням ідентифікацією у всіх середовищах.

    Висновок

    Мультихмарна взаємодія не базується на «чарівних» технологіях — це практичне застосування класичних мережевих принципів.
    Підключаючи Azure до локальної інфраструктури чи інших хмар (AWS, GCP, OCI), організації мають два основних варіанти:

    • Зашифрований VPN-тунель через інтернет — простіше, але з обмеженнями швидкості.

    • Приватне з’єднання через виділені канали — складніше, але з високою продуктивністю та надійністю.

    Головне — планувати резервування, підтримувати єдине управління та видимість, а також забезпечувати безпеку та контроль у всіх хмарах.
    Саме це і є суть мультихмарної мережевої архітектури — гнучкої, надійної та безпечної.
  • Інтеграція GitHub Models із .NET 9 за допомогою Microsoft.Extensions.AI

    Сьогодні, коли штучний інтелект розвивається надзвичайно швидко, ще ніколи не було кращого часу бути .NET-розробником, який працює з AI. Завдяки сучасним бібліотекам і API, інтеграція великих мовних моделей (LLM) у застосунки .NET стала простою, ефективною та надійною.

    Одним із ключових інструментів, що робить цей процес настільки зручним, є бібліотека Microsoft.Extensions.AI — вона надає чисті абстракції для роботи з різними AI-провайдерами.
    У цій статті ми крок за кроком розглянемо, як використовувати GitHub Models у .NET 9: налаштуємо OpenAI-адаптер, створимо чат-клієнт і підключимо застосунок безпосередньо до моделі всього за кілька рядків коду.

    1. Створення консольного застосунку .NET 9

    Почнемо зі створення базового консольного застосунку .NET 9. Після цього додамо потрібні бібліотеки.

    Встановлення бібліотек

    1. Відкрийте NuGet Package Manager.

    2. У полі пошуку введіть Microsoft.Extensions.AI.

    3. Замість встановлення цієї бібліотеки напряму встановіть Microsoft.Extensions.AI.OpenAI — саме вона потрібна для підключення до GitHub Models.

    4. Пакет OpenAI вже містить основну бібліотеку Microsoft.Extensions.AI як залежність, тому встановлювати її окремо не потрібно.

    Після встановлення переконайтеся, що бібліотека з’явилася у вашому проєкті. Очистіть Program.cs, щоб перейти до наступного кроку.

    2. Створення та налаштування чат-клієнта

    Інтерфейс IChatClient — це головна абстракція, яку надає бібліотека Microsoft.Extensions.AI для взаємодії з великими мовними моделями у .NET.

    Створення екземпляра чат-клієнта

    Створіть змінну типу IChatClient і присвойте їй новий екземпляр клієнта.

    • Назва моделі:
      Вказує, яку модель GitHub Models потрібно використовувати. Ми заповнимо це поле пізніше.

    • API-ключ:
      Цей ключ автентифікує ваш застосунок у GitHub Models. Без нього запити не працюватимуть. Поки що залишимо порожнім — пізніше додамо справжній ключ.

    • Endpoint:
      У OpenAIClientOptions є властивість Endpoint.
      Оскільки ми підключаємося до GitHub Models, вкажіть:

      https://api.github.com/models

      Це налаштування дає змогу клієнту надсилати всі запити безпосередньо до GitHub Models.

    Після цього викличте .AsChatClient(), щоб перетворити клієнт конкретного провайдера на стандартний інтерфейс IChatClient.
    Це важливо, адже такий підхід робить код чистим, гнучким і незалежним від постачальника. Якщо ви захочете змінити провайдера, логіку програми міняти не доведеться.

    3. Створення GitHub API-ключа

    Тепер створимо API-ключ GitHub, щоб отримати доступ до моделей.

    1. Перейдіть у GitHub Models Marketplace.

    2. У спадному списку виберіть потрібну модель.

    3. Для прикладу ми використаємо GPT-4.1 Mini.

    4. Натисніть «Use this model».

    5. Якщо ви користуєтеся безкоштовним тарифом, натисніть «Create personal access token», щоб згенерувати ключ.

    Створення токена

    • Вкажіть термін дії (за замовчуванням — 30 днів).

    • Задайте назву токена, наприклад YouTube GitHub Model Token.

    • Натисніть «Generate token», щоб створити його.

    Після створення токена скопіюйте його одразу, адже він відображається лише один раз. Збережіть у безпечному місці та ніколи не вставляйте напряму у код. Для демонстрації вставимо його в прикладі, але в реальних застосунках потрібно використовувати змінні середовища або Secret Manager.

    Після вставлення токена додайте назву моделі ("gpt-4.1-mini") — і чат-клієнт повністю налаштовано.

    4. Реалізація логіки чат-застосунку

    Тепер, коли клієнт готовий, створимо логіку самого чату.

    Привітальне повідомлення

    Після запуску застосунку виведіть коротке привітання та інструкцію, як завершити чат.

    Історія діалогу

    Щоб модель могла підтримувати контекст, створіть список для зберігання всіх повідомлень між користувачем і моделлю.
    У цьому списку зберігатимуться як повідомлення користувача, так і відповіді асистента.

    Основний цикл чату

    Чат має працювати безперервно, доки користувач не введе exit.

    1. Використовуйте цикл while (true).

    2. Виведіть запрошення до введення повідомлення.

    3. Зчитайте введення користувача.

    4. Якщо рядок порожній — повторіть запит.

    5. Якщо введено exit — вийдіть із циклу.

    Кожне повідомлення додавайте до історії, щоб модель мала повний контекст під час наступного запиту.

    5. Потокові відповіді моделі в реальному часі

    Перед тим як показати відповідь моделі, додайте позначку «Assistant:», щоб було зрозуміло, від кого повідомлення.

    Метод GetStreamingResponseAsync() дозволяє отримувати відповідь поступово, токен за токеном, тобто ви бачитимете, як текст з’являється у режимі реального часу — ніби в живому чаті.

    Використовуйте Console.Write() для виведення кожного токена одразу, створюючи ефект інтерактивного діалогу.
    Паралельно зберігайте повну відповідь у змінній assistantResponse, додаючи кожну частину тексту.
    Після завершення генерації додайте відповідь у список історії, щоб модель пам’ятала контекст.

    6. Покращення інтерфейсу

    Зараз повідомлення користувача та моделі виглядають однаково, тому їх важко розрізнити.
    Виправимо це кольорами:

    • Привітання: жовтий

    • Повідомлення користувача: білий

    • Відповідь асистента: зелений

    Тепер чат став більш читабельним і приємним візуально.

    Після змін запустіть програму знову — різниця очевидна.
    Відповіді асистента плавно з’являються в режимі реального часу.

    7. Тестування чат-застосунку

    Перевіримо, як усе працює:

    • Введіть: What’s .NET?
      → Асистент миттєво пояснює, що таке .NET.

    • Спробуйте: Write a story about a superhero.
      → Модель починає стрімити історію в реальному часі прямо у консолі.

    • Перевіримо контекст:

      1. Введіть Add 10 and 5.
        → Відповідь: 10 + 5 = 15.

      2. Потім введіть Minus 4.
        → Відповідь: 15 - 4 = 11.

    Модель запам’ятала попередній результат, бо ми передаємо всю історію діалогу при кожному новому запиті.

    8. Підсумок

    Ви щойно побачили, наскільки легко .NET може працювати зі штучним інтелектом і великими мовними моделями за допомогою бібліотеки Microsoft.Extensions.AI.

    Усього за кілька рядків коду ми:

    • Підключили консольний застосунок .NET 9 до GitHub Models

    • Реалізували стрімінг відповідей у реальному часі

    • Додали збереження історії діалогу

    • Створили інтерактивний чат

    Це чудовий приклад того, наскільки потужною та гнучкою стала екосистема AI у .NET.
    Просто, швидко й елегантно — ідеально для розробників, які створюють інтелектуальні застосунки.

  • Onion Architecture: як створювати масштабовані та підтримувані програмні системи

    У сучасному цифровому світі бізнеси потребують програмних рішень, які залишаються надійними, гнучкими та масштабованими зі зростанням компанії. Чим більша організація, тим складнішими стають її технічні вимоги. Необхідні архітектури, що можуть розвиватися без втрати продуктивності та гнучкості.
    Саме для цього існує Onion Architecture — архітектурний підхід, який допомагає створювати програми, прості у тестуванні, підтримці та масштабуванні, завдяки поділу коду на логічні шари з чіткими зонами відповідальності.

    Для B2C-розробників розуміння Onion Architecture — це важливий крок до оволодіння сучасними принципами проектування. Для B2B-керівників її впровадження допомагає прискорити розробку критично важливих систем і підвищити їхню стійкість до змін.
    Ми спеціалізуємося на сучасних архітектурних підходах і допомагаємо компаніям знаходити експертів, здатних впроваджувати ефективні рішення, такі як Onion Architecture.

    Що таке Onion Architecture

    Onion Architecture пропонуємо як альтернативу традиційним багатошаровим архітектурам, де дизайн часто диктувався користувацьким інтерфейсом або інфраструктурою, що призводило до надмірної зв’язності та складності.
    Onion Architecture, навпаки, ставить бізнес-логіку в центр системи, дотримуючись принципів Domain-Driven Design (DDD).

    Суть архітектури полягає в організації коду у вигляді концентричних шарів, де кожен виконує власну роль. Головна ідея — ізолювати бізнес-логіку від технічних деталей, таких як база даних чи інтерфейс, щоб зробити систему гнучкою, тестованою та зручною в обслуговуванні.

    Шари Onion Architecture

    1. Core Domain Layer (внутрішній шар)

    Це серце застосунку. Тут зберігається бізнес-логіка, доменні сутності та основні правила. Цей шар повністю незалежний від зовнішніх систем, що робить його найбільш стабільним і захищеним. Саме на ньому будується вся архітектура.

    2. Application Layer

    Цей шар керує виконанням бізнес-операцій, поєднуючи доменну логіку із зовнішніми компонентами. Тут описані сценарії використання, сервіси та бізнес-процеси. Він відповідає за реалізацію правил, безпеку, транзакції та координацію дій між шарами.

    3. Adapter Layers (зовнішні шари)

    Зовнішні шари, або адаптери, забезпечують взаємодію із зовнішнім світом — базами даних, інтерфейсами, API та іншими сервісами. До них належать:

    • Infrastructure Layer: відповідає за доступ до даних, роботу з файлами та інтеграцію з інфраструктурою. Дозволяє змінювати базу даних або інші технології без впливу на бізнес-логіку.

    • Presentation Layer: реалізує взаємодію з користувачем — це може бути веб-інтерфейс, мобільний застосунок або API. Цей шар передає запити користувачів у застосунок і відображає результати.

    • External Services Layer: інтегрує зовнішні сервіси — платіжні шлюзи, API або мікросервіси. Абстрагує взаємодію з іншими системами та забезпечує стабільну інтеграцію.

    Основні принципи Onion Architecture

    1. Принцип інверсії залежностей (Dependency Inversion Principle, DIP)

    Високорівневі модулі (бізнес-логіка) не залежать від низькорівневих (інфраструктури). Обидва спираються на абстракції — інтерфейси або контракти. Це забезпечує слабку зв’язність і легку заміну компонентів без впливу на систему загалом.

    2. Інверсія керування (Inversion of Control, IoC)

    IoC-контейнери керують залежностями та впроваджують потрібні компоненти за потреби. Це підвищує гнучкість, зменшує залежність від конкретних реалізацій і спрощує тестування завдяки використанню мок-об’єктів.

    3. Розділення відповідальності (Separation of Concerns)

    Кожен шар має чітко визначену роль. Бізнес-логіка відокремлена від інтерфейсу та інфраструктури, що робить систему модульною, зрозумілою та простою в обслуговуванні.

    Переваги Onion Architecture

    1. Підтримуваність

    Завдяки ізоляції бізнес-логіки від інфраструктури можна змінювати або оновлювати окремі шари без ризику зламати всю систему. Це особливо важливо для великих проектів із кількома командами.

    2. Тестованість

    Оскільки доменна логіка не залежить від зовнішніх систем, її легко тестувати ізольовано. Це спрощує модульне тестування та знижує ризик помилок у продакшені.

    3. Гнучкість

    Система легко адаптується до змін: можна замінити базу даних, API або UI-фреймворк без переписування ядра застосунку.

    4. Масштабованість

    Кожен шар можна масштабувати окремо. Наприклад, інфраструктуру можна оптимізувати під великі навантаження без змін у бізнес-логіці.

    5. Покращена командна співпраця

    Чіткий поділ шарів дозволяє різним командам — розробникам, дизайнерам, DevOps-фахівцям — працювати паралельно, не заважаючи одна одній.

    Де застосовується Onion Architecture

    Ця архітектура ідеально підходить для великих і складних систем, зокрема:

    • Корпоративні застосунки: ERP, CRM та інші рішення, що потребують довгострокової підтримки.

    • Веб-застосунки: SaaS та e-commerce платформи, де важливе розділення логіки та інтерфейсу.

    • Мікросервіси: кожен сервіс можна побудувати як окрему «цибулину» зі своєю бізнес-логікою та інфраструктурою.

    • Фінансові системи: особливо ефективна там, де потрібна безпека та чітка ізоляція бізнес-правил від зовнішніх сервісів.

    Як ми допомагає впроваджувати Onion Architecture

    Ми розуміємо, що архітектура — це фундамент надійного програмного забезпечення. Ми допомагаємо компаніям проектувати й упроваджувати Onion Architecture та інші сучасні архітектурні підходи, адаптовані до їхніх цілей.

    1. Архітектурний консалтинг

    Наші експерти допомагають організаціям спроектувати та реалізувати архітектуру, що забезпечує стабільність, гнучкість і масштабованість. Ми працюємо як із новими проектами, так і з модернізацією старих систем.

    2. Підбір спеціалізованих фахівців

    Ми підбираємо розробників, архітекторів і консультантів, які володіють знаннями Onion Architecture. Незалежно від того, чи потрібні вам тимчасові спеціалісти чи постійні співробітники — ми допоможемо сформувати оптимальну команду.

    Висновок

    Onion Architecture — це не просто архітектурний шаблон, а філософія побудови надійних і гнучких програмних систем. Зосереджуючись на бізнес-логіці та ізолюючи зовнішні залежності, вона допомагає створювати рішення, які легко тестувати, підтримувати та розвивати впродовж багатьох років.

  • Майстерність платформенної інженерії в корпоративному середовищі

    У стрімко мінливому цифровому світі платформенна інженерія стала однією з ключових дисциплін, яка визначає підходи до створення, розгортання та підтримки програмних систем. Її часто називають наступним етапом розвитку DevOps, адже вона напряму бореться зі складністю, знижує когнітивне навантаження на розробників та пришвидшує доставку цінності для бізнесу.

    Завдяки стандартизованому набору інструментів, сервісів та автоматизованої інфраструктури платформенна інженерія прокладає «асфальтовану дорогу» для команд розробників, дозволяючи їм випускати нові функції швидше та надійніше. У цьому посібнику ми розглянемо ключові складові платформенної інженерії — від її концепцій і архітектурних моделей до інтеграції з такими технологіями, як генеративний ШІ.

    1. Основні принципи та компоненти платформенної інженерії

    У своїй суті внутрішня платформа розробника (IDP) — це єдине середовище, яке поєднує цифрові інструменти та спільну інфраструктуру для досягнення бізнес-результатів через повторювані та стандартизовані процеси. Основне завдання IDP — об’єднати розробників і спеціалістів з IT-операцій навколо безпечної, масштабованої та надійної основи.

    1.1. Чотири «C» хмарно-нативної архітектури

    Сучасна cloud-стратегія базується на чотирьох ключових шарах:

    • Cloud (Хмара) — базова інфраструктура для робочих навантажень (AWS, Azure, Google Cloud або приватні хмари).

    • Cluster (Кластер) — група фізичних чи віртуальних машин під керуванням контролера. Стандартом стали Kubernetes та Docker.

    • Container (Контейнер) — легкі ізольовані середовища, які включають застосунок із залежностями для стабільної роботи будь-де.

    • Code (Код) — логіка та інструкції, створені розробниками і виконувані всередині контейнерів.

    1.2. Принципи проєктування

    Дизайн платформи спирається на перевірені методології, такі як SOLID, що гарантують масштабованість і підтримку мікросервісних систем. Також враховуються мережеві моделі (наприклад, середні рівні OSI), які визначають взаємодію сервісів.

    1.3. Ключові елементи платформи

    Компоненти зазвичай діляться на дві групи:

    • Інструменти для співпраці – IDE, системи контролю версій (GitHub, GitLab), трекери завдань (Jira, Aha!), канали комунікації (Slack, Mattermost), а також панелі управління з підтримкою SSO. Важливу роль відіграють інтегровані засоби безпеки: аналіз коду, перевірка залежностей тощо.

    • Інфраструктура для деплою – формується через Infrastructure as Code (IaC): Terraform, Kubernetes-манифести, Docker-конфігурації. CI/CD пайплайни (Jenkins, GitHub Actions, GitLab CI/CD, ArgoCD, Flux) забезпечують швидкий і автоматизований реліз без «вузьких місць».

    2. Масштабованість, безпека та стійкість

    Ці три характеристики є фундаментом надійності платформи.

    • Масштабованість – гнучкість системи під зміни навантаження. Kubernetes і Terraform відіграють ключову роль в автоматизації масштабування.

    • Безпека – має закладатися від початку: шифрування даних «у спокої» та «в русі», багатофакторна аутентифікація (MFA), суворий контроль доступу через OAuth або LDAP.

    • Стійкість – здатність системи відновлюватися після збоїв. Рекомендованим стандартом є модель резервного копіювання 3-2-1.

    2.1. Архітектурні моделі

    Існує три основні підходи:

    1. Постійні – кластери, що працюють завжди (dev, test, prod). Стабільні та передбачувані.

    2. Перехідні – динамічні середовища з автоскейлінгом і часовими обмеженнями. Вигідні за витратами.

    3. Ефемерні – тимчасові кластери під конкретну задачу (наприклад, тести), після чого видаляються.

    3. Екосистема інструментів платформи

    Ефективна платформа базується на автоматизації:

    • Infrastructure as Code (IaC) – Terraform, Chef, Puppet для опису інфраструктури кодом.

    • Configuration Management (CM) – Ansible, Puppet, Chef для автоматизованого налаштування систем.

    • VCS – Git як стандарт. Підхід GitOps дозволяє керувати інфраструктурою через репозиторій.

    3.1. Оркестрація та спостережуваність

    • Kubernetes – стандарт для контейнерів: балансування, самовідновлення, автодеплой.

    • Service Mesh (Istio, Linkerd) – контроль трафіку та безпеки між сервісами.

    • Моніторинг і логи – Prometheus та стек ELK для централізованої аналітики.

    • OpenTelemetry – відкритий стандарт для збору метрик, логів і трасувань.

    3.2. CI/CD пайплайни

    CI/CD — це двигун, що переводить ідею у готовий застосунок.

    • Популярні інструменти: Jenkins, GitLab, CircleCI.

    • Пайплайни включають етапи: розробка → збірка → тест → деплой.

    4. Безпека, відповідність і управління

    Захист має бути частиною архітектури:

    • Secure-by-Default – безпека закладається за замовчуванням.

    • Шифрування даних – обов’язково у зберіганні та передачі.

    • RBAC і SSO – контроль доступу за принципом найменших привілеїв.

    • Vulnerability Management – регулярне сканування CVE, генерація SBOM для відстеження залежностей.

    Інструменти безпеки інтегруються прямо у CI/CD пайплайн (SAST, dependency scanning).

    5. Штучний інтелект у платформенній інженерії

    ШІ докорінно змінює управління платформами:

    • Автоматизація розробки – GitHub Copilot, Google Gemini допомагають писати код і пришвидшують рутинні задачі.

    • Інтелектуальна інфраструктура – передиктивний скейлінг і оптимізація ресурсів.

    • Підсилення безпеки – виявлення аномалій та аналіз загроз.

    • Виклики – захист даних, регуляторні вимоги (GDPR), етичні питання прозорості й зайнятості.

    6. Управління даними в платформенній інженерії

    Дані – це паливо для ШІ та бізнесу.

    • Значення даних – платформи забезпечують інфраструктуру для обробки великих обсягів інформації.

    • Стратегії – вибір між data lakes і data warehouses, автоматизація пайплайнів.

    • Архітектура даних – має враховувати 5 V Big Data: обсяг, швидкість, цінність, різноманітність і достовірність.

    • DataOps – застосування принципів DevOps до життєвого циклу даних.

    Висновок

    Платформенна інженерія — це не просто технічне рішення, а стратегічний інструмент бізнесу. Вона є продовженням DevOps, допомагає керувати складністю, зберігаючи автономію команд, і підвищує продуктивність завдяки фокусу на досвіді розробників (DX).

    Майбутнє розробки ПЗ — за платформами, де поєднуються автоматизація, ШІ та орієнтація на розробників. Ті компанії, які впроваджують ці практики вже сьогодні, отримають стратегічну перевагу у цифрову добу.

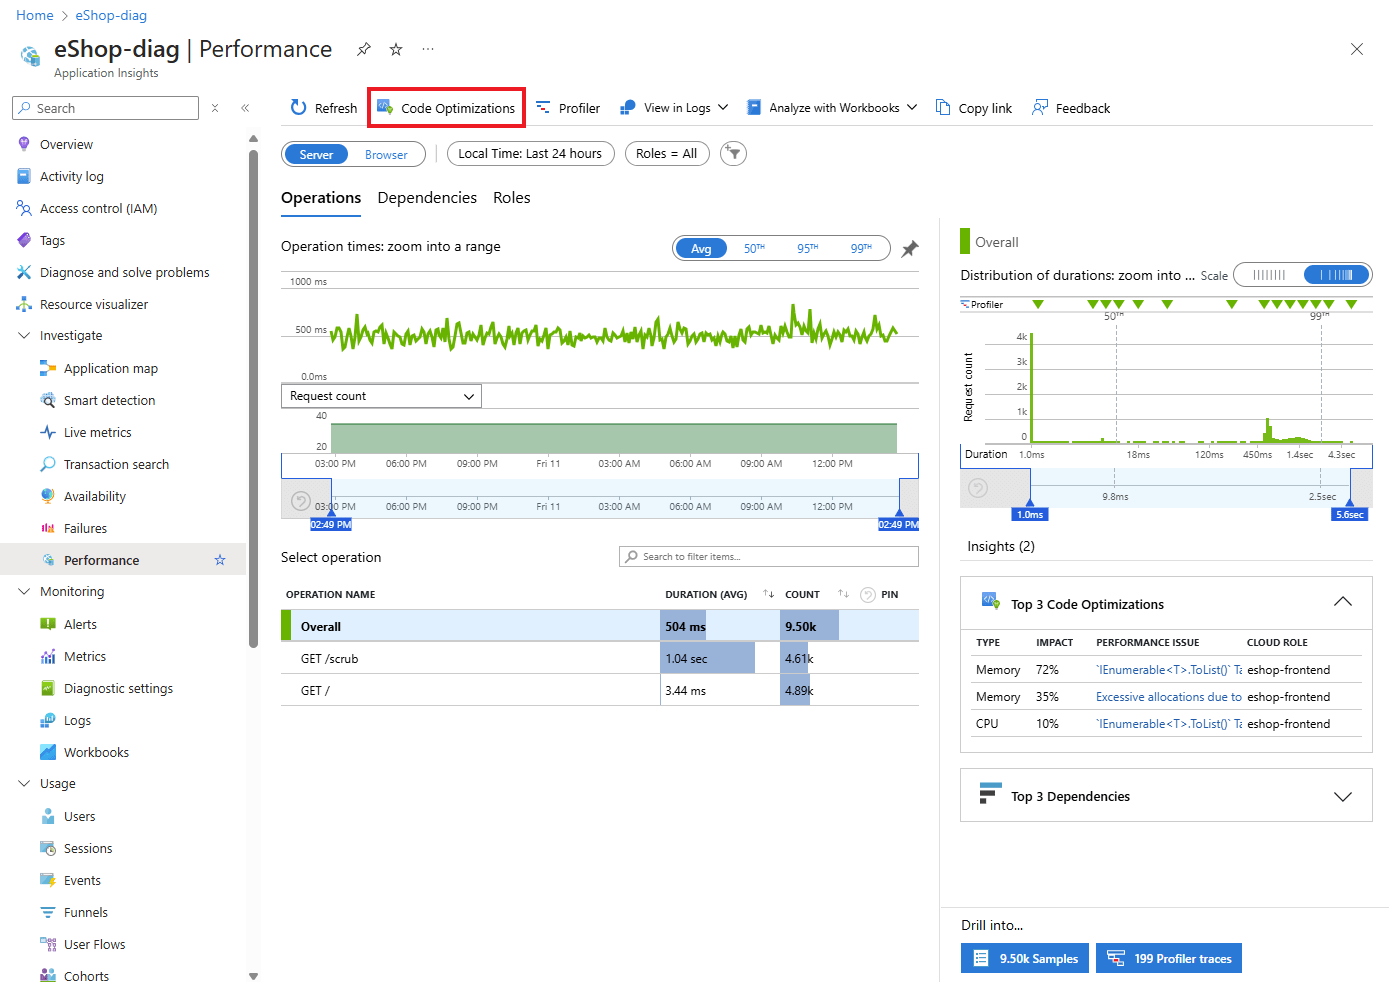
  • Технічний огляд: Оптимізація коду .NET за допомогою Application Insights

    Технічний огляд: Оптимізація коду .NET за допомогою Application Insights

    Оптимізація коду в Application Insights — це інструмент, який допомагає розробникам підвищувати продуктивність застосунків на .NET. Він аналізує роботу застосунку, виявляє вузькі місця та надає конкретні рекомендації на рівні коду для усунення виявлених проблем.

    Як це працює

    Інструмент інтегрується з профайлерами .NET в Application Insights та автоматично обробляє дані трасування, зібрані під час виконання застосунку.

    Основні функції:

    • Постійний аналіз: Система безперервно відстежує трасування профайлера і виявляє неефективні ділянки коду.

    • Виявлення проблем: Ідентифікує ділянки, де підвищене навантаження на CPU або використання пам’яті, що може уповільнювати роботу застосунку.

    • Практичні рекомендації: Надає точні поради щодо покращення коду, доступні безпосередньо в порталі Azure.

    У розділі Performance можна побачити візуальні підказки, які допомагають визначити, які зміни принесуть найбільший ефект.

    Інтеграція в процес розробки

    Рекомендації з оптимізації коду легко інтегрувати у стандартні робочі процеси команди:

    • Системи управління завданнями: Можна експортувати як робочі елементи в Azure DevOps або інші трекери.

    • Підтримка GitHub Copilot: Поради доступні прямо у Visual Studio та Visual Studio Code через GitHub Copilot, що дозволяє швидко застосовувати виправлення.

    • Автоматизація завдань: GitHub Issues, створені на основі рекомендацій, можна призначати агенту Copilot для прискорення процесу оптимізації.

    Нові можливості

    • Аналіз блокуючих операцій: Інструмент тепер виявляє синхронні операції, які можуть блокувати потоки в асинхронних процесах. Раніше аналіз охоплював лише активно виконувані потоки.

    • Пряме призначення завдань Copilot: GitHub Issues тепер можна призначати агенту Copilot безпосередньо зі сторінки Оптимізації коду або вкладки Snapshot Debugger.

    • Підтримка OpenTelemetry (Preview): Попередня підтримка профайлера .NET для OpenTelemetry дозволяє збирати дані про продуктивність застосунків без інтеграції додаткових SDK.

    Як увімкнути Оптимізацію коду

    Щоб почати роботу, потрібно активувати профайлер .NET для застосунку в налаштуваннях Application Insights. Для нових застосунків ця опція доступна під час початкового налаштування моніторингу.

  • Спрощення Kubernetes з AKS Automatic: новий підхід до розгортання

    Керування Kubernetes-інфраструктурою часто нагадує жонглювання безліччю завдань. Це забирає в розробників дорогоцінний час і увагу, які краще спрямувати на створення застосунків. Щоб вирішити цю проблему, Microsoft представила AKS Automatic — новий режим розгортання для Azure Kubernetes Service, що наразі доступний у режимі попереднього перегляду. Його мета — зняти з команд значну частину операційного навантаження та передати її платформі Azure, дозволяючи зосередитися на коді, а не на кластерах.

    У цій статті ми розглянемо, що таке AKS Automatic, які переваги він надає та як розгорнути свій перший автоматизований кластер.

    Що таке AKS Automatic?

    AKS Automatic — це спрощений варіант розгортання кластерів AKS. Замість того щоб вручну налаштовувати, масштабувати й оновлювати інфраструктуру, користувач отримує все «з коробки». Платформа бере на себе оновлення, безпеку та експлуатацію кластера, звільняючи команди для розробки застосунків.

    Ключові можливості та переваги

    1. Інтелектуальне керування вузлами та масштабування

    Головна перевага — повністю автоматизоване керування вузлами за допомогою Node Autoprovisioning (NAP), побудованого на проєкті Karpenter з відкритим кодом. Система аналізує вимоги pod’ів, що очікують запуску, і автоматично підбирає оптимальний тип віртуальної машини для балансу продуктивності та вартості.

    Крім того, AKS Automatic одразу вмикає кілька механізмів масштабування:

    • Horizontal Pod Autoscaler (HPA): масштабує кількість pod’ів залежно від навантаження.

    • KEDA (Kubernetes Event-driven Autoscaling): масштабує застосунки на основі зовнішніх подій (наприклад, повідомлень із черг чи тригерів бази даних).

    • Vertical Pod Autoscaler (VPA): динамічно коригує запити ресурсів pod’ів (CPU, пам’ять).

    Додатково:

    • Автоматичний ремонт вузлів: при збої система намагається відновити вузол.

    • Автоматичні оновлення кластера: забезпечують актуальні версії та патчі безпеки з можливістю планування технічних вікон.

    Важливо: наразі AKS Automatic підтримує лише вузли на Azure Linux, Windows-вузли поки недоступні.

    2. Вбудована безпека за замовчуванням

    Безпека інтегрована від початку та відповідає найкращим практикам Microsoft:

    • Azure RBAC: керування доступом через ролі й дозволи Azure.

    • Microsoft Entra Workload ID: безпечне підключення застосунків до сервісів Azure без секретів і ключів.

    • Політики розгортання: автоматична перевірка на відповідність стандартам Kubernetes за допомогою Azure Policy.

    • Очищення образів: видалення уразливих і невикористовуваних контейнерних образів.

    3. Повністю керована мережа

    Мережеві налаштування у Kubernetes часто створюють труднощі, але AKS Automatic спрощує цей процес, надаючи готову оптимізовану інфраструктуру:

    • Azure CNI Overlay з Cilium: високопродуктивний і безпечний зв’язок між pod’ами.

    • Керований Nginx Ingress: інтеграція з Azure DNS для автоматичного налаштування доменів та Azure Key Vault для керування SSL/TLS-сертифікатами.

    • Керований NAT Gateway: надійне й масштабоване вихідне з’єднання з інтернетом.

    Практичний посібник: створення кластера AKS Automatic

    Крок 1. Налаштування Azure CLI

    Встановіть розширення та активуйте необхідні прапорці:

    az extension add --name aks-preview
    az extension update --name aks-preview

    az feature register --namespace "Microsoft.ContainerService" --name "AKS-Automatic"
    az feature register --namespace "Microsoft.ContainerService" --name "NodeAutoProvisioningPreview"

    az provider register --namespace Microsoft.ContainerService

    Дочекайтеся, поки статус функцій зміниться на Registered.

    Крок 2. Створення кластера через Azure Portal

    1. Відкрийте Kubernetes Services → Create.

    2. У полі «Cluster preset configuration» виберіть Automatic.

    3. Заповніть базові параметри (ресурсна група, назва, регіон).

    4. (Опційно) Налаштуйте моніторинг з Azure Monitor, Prometheus і Grafana.

    5. Натисніть Review + Create.

    Крок 3. Підключення та перевірка

    Отримайте облікові дані:

    az aks get-credentials --resource-group <ResourceGroup> --name <ClusterName>

    Перевірте вузли та системні pod’и:

    kubectl get nodes kubectl get pods -n kube-system


    Крок 4. Розгортання тестового застосунку

    Створіть простір імен:

    kubectl create namespace demo-app

    Розгорніть застосунок:

    kubectl apply -f your-app.yaml -n demo-app

    Отримайте публічний IP Ingress:

    kubectl get ingress -n demo-app

    Відкрийте IP у браузері — застосунок має бути доступним.

    Підсумок

    AKS Automatic — це серйозний крок уперед у спрощенні роботи з Kubernetes. Автоматизація інфраструктури, масштабування, оновлень і безпеки знімає з команд рутинні завдання та дозволяє зосередитися на створенні бізнес-цінності. Попри те, що функція поки в режимі попереднього перегляду, вона вже демонструє величезний потенціал для користувачів Azure Kubernetes Service.

  • Мережева інфраструктура в Azure Kubernetes Service (AKS):

    Azure Kubernetes Service (AKS) став основою для багатьох корпоративних контейнеризованих робочих навантажень, пропонуючи розробникам та операційним командам зручну платформу для розгортання, керування й масштабування застосунків. У центрі AKS знаходиться мережева інфраструктура — ключовий компонент, що визначає зв’язність, продуктивність і безпеку. Розуміння різних мережевих моделей, конфігурацій і найкращих практик в AKS гарантує, що робочі навантаження залишатимуться відмовостійкими, відповідатимуть вимогам та будуть високодоступними.

    У цьому гіді ми розглянемо мережеву архітектуру AKS, від базових принципів до просунутих технічних конфігурацій, щоб допомогти організаціям оптимізувати свої хмарні середовища.

    Основні концепції мереж в AKS

    Модель мережевого кластера

    Під час розгортання кластерів AKS мережа має бути визначена заздалегідь. AKS підтримує дві основні моделі:

    1. Kubenet Networking
      • Легка мережева модель за замовчуванням.
      • Pod-и отримують IP-адреси з приватного діапазону всередині кластера.
      • Вихідні підключення виконуються через NAT.
      • Менш складна, але потребує налаштування маршрутів для зв’язку pod-ів на різних вузлах.
    2. Azure CNI (Container Networking Interface)
      • Pod-и отримують IP-адреси безпосередньо з віртуальної мережі (VNet).
      • Повна інтеграція з Azure VNet.
      • Спрощує взаємодію із зовнішніми ресурсами, але потребує ретельного планування IP-адрес.

    Компоненти мереж в AKS

    • Virtual Networks (VNet): логічна сегментація мережі.
    • Підмережі: виділення IP-діапазонів для вузлів, pod-ів та сервісів.
    • Балансувальники навантаження: керування вхідним та внутрішнім трафіком.
    • Ingress-контролери: маршрутизація HTTP/HTTPS із SSL-термінацією.
    • DNS-сервіси: service discovery всередині кластера.

    Проектування віртуальних мереж для AKS

    Планування VNet і підмереж

    Грамотний дизайн VNet критично важливий для масштабованої інфраструктури AKS. Рекомендується:

    • Виділяти окремі підмережі для системних вузлів, користувацьких вузлів і pod-ів.
    • Використовувати широкі діапазони IP-адрес при застосуванні Azure CNI, щоб уникнути їх вичерпання.
    • Резервувати підмережі для ingress-контролерів і Application Gateway.

    Пірингові з’єднання та гібридна зв’язність

    Часто кластери AKS мають безпечно підключатися до локальних систем або інших VNet. Для цього використовуються:

    • VNet Peering — швидкі приватні з’єднання з низькою затримкою.
    • VPN Gateway або ExpressRoute — захищені гібридні мережі для корпоративних навантажень.
    • Private Endpoints — підключення до сервісів (Azure SQL, Storage) без виходу в інтернет.

    Керування вхідним і вихідним трафіком

    Вхідний трафік у AKS

    Для обробки зовнішніх запитів AKS використовує Azure Load Balancer і Ingress-контролери:

    • Azure Standard Load Balancer: підтримує вхідні та вихідні з’єднання.
    • Nginx Ingress Controller: SSL-термінація, маршрутизація за URL, гнучкі правила трафіку.
    • Azure Application Gateway Ingress Controller (AGIC): керування L7-трафіком з інтеграцією WAF.

    Вихідний трафік у AKS

    Контроль вихідного трафіку забезпечує безпеку:

    • NAT Gateway забезпечує фіксовану вихідну IP-адресу.
    • Azure Firewall надає розширений захист і фільтрацію.
    • Користувацькі маршрути дозволяють точно визначати шлях вихідного трафіку.

    DNS та service discovery

    CoreDNS у AKS

    Кожен кластер AKS включає CoreDNS для внутрішнього розв’язання імен сервісів. Він перетворює назви Kubernetes-сервісів на IP-адреси, забезпечуючи безшовну комунікацію pod-ів.

    Приватні DNS-зони

    Для інтеграції із зовнішніми або приватними ресурсами Azure Private DNS zones забезпечують надійне розв’язання імен між VNet та гібридними мережами.

    Розширені мережеві можливості в AKS

    Мережеві політики безпеки

    Kubernetes Network Policies регулюють взаємодію pod-ів. В AKS доступні:

    • Azure Network Policies — глибока інтеграція з Azure Networking.
    • Calico Network Policies — гнучке open-source рішення для тонкого налаштування правил.

    Політики дозволяють:

    • Блокувати зайвий east-west трафік.
    • Реалізувати zero-trust архітектуру.
    • Відповідати вимогам комплаєнсу.

    Private Clusters

    Для задач із підвищеною безпекою AKS підтримує приватні кластери, де API-сервер доступний лише з VNet. Це усуває доступ через інтернет і посилює контроль.

    Двоадресна мережа (IPv4 + IPv6)

    Сучасні застосунки дедалі частіше потребують dual-stack мережі:

    • Збільшення ємності адресації.
    • Підтримка IoT і edge-пристроїв.
    • Підготовка інфраструктури до майбутніх стандартів.

    Інтеграція безпеки з мережами AKS

    Azure Firewall та NSG

    • Azure Firewall: централізований захист із перевіркою пакетів.
    • NSG (Network Security Groups): правила вхідного/вихідного трафіку на рівні підмережі або NIC.

    Разом вони створюють багаторівневий захист кластерів.

    Web Application Firewall (WAF)

    У поєднанні з Application Gateway, WAF захищає застосунки від вразливостей OWASP Top 10: SQL-ін’єкцій, XSS тощо.

    Масштабування та оптимізація продуктивності

    Керування IP-адресами

    У великих кластерах часто виникає дефіцит IP. Способи вирішення:

    • Використовувати Azure CNI з динамічним виділенням IP.
    • Розподіляти pod-и між кількома підмережами.
    • Застосовувати overlay-мережі, якщо це доцільно.

    Оптимізація балансувальника навантаження

    • Для production-середовищ обирайте Standard Load Balancer.
    • Оптимізуйте бекенд-пули та health-проби.

    Моніторинг і відлагодження

    Використовуйте Azure Monitor та Container Insights для відстеження:

    • Затримок pod-to-pod.
    • Продуктивності DNS.
    • Метрик балансувальників навантаження.

    Найкращі практики для мереж AKS

    1. Завчасно плануйте IP-діапазони.
    2. Використовуйте приватні кластери для підвищення безпеки.
    3. Застосовуйте ingress-контролери для керування L7-трафіком.
    4. Налаштовуйте мережеві політики для реалізації zero-trust.
    5. Впроваджуйте моніторинг для аналізу потоків трафіку.
    6. Використовуйте гібридні мережі для корпоративних задач.
    7. Регулярно перевіряйте правила Firewall і NSG.

    Висновок

    Грамотно спроєктована мережева інфраструктура в Azure Kubernetes Service (AKS) є ключем до безпечного, відмовостійкого й масштабованого запуску контейнеризованих застосунків. Вибір між Kubenet і Azure CNI, впровадження мережевих політик, використання ingress-контролерів і приватних кластерів — кожне рішення напряму впливає на продуктивність і рівень захисту. Дотримуючись найкращих практик, організації зможуть повністю розкрити потенціал AKS і підготувати інфраструктуру до майбутнього.

  • GitHub MCP Registry: найшвидший спосіб знайти MCP-сервери

    Зростання Model Context Protocol (MCP) відкрило нові можливості для розробників, організацій та спільнот з відкритим кодом, дозволяючи пришвидшувати інтеграції та інновації. Щоб розкрити цей потенціал, GitHub представив MCP Registry — центральний хаб, створений для спрощення пошуку, стандартизації та співпраці навколо MCP-серверів. Цей реєстр швидко стає незамінним інструментом для розробників у всьому світі, допомагаючи їм знаходити, впроваджувати та масштабувати MCP-сервери швидше, ніж будь-коли.

    У цій статті ми розглянемо GitHub MCP Registry, його роботу та пояснимо, чому це найефективніший спосіб відкривати MCP-сервери для сучасної розробки.

    Що таке GitHub MCP Registry?

    GitHub MCP Registry — це централізований каталог MCP-серверів, до якого розробники отримують доступ безпосередньо через GitHub. Замість тривалих пошуків у розрізнених репозиторіях і документації реєстр пропонує єдине надійне джерело.

    Організувавши MCP-сервери в одному місці, реєстр усуває фрагментацію й допомагає розробникам знаходити надійні рішення для створення контекстно-орієнтованих застосунків, масштабування інтеграцій і підтримання узгодженості в проєктах.

    Чому GitHub MCP Registry важливий

    Запровадження MCP Registry вирішує три ключові завдання:

    1. Зручний пошук – розробники можуть швидко шукати й фільтрувати MCP-сервери, економлячи години ручного дослідження.
    2. Стандартизація – єдиний реєстр гарантує узгодженість документації, метаданих і версій.
    3. Співпраця – реєстр зміцнює спільноту, поєднуючи розробників з авторами серверів і заохочуючи внески в open-source.

    Інакше кажучи, MCP Registry пришвидшує інновації, роблячи впровадження MCP простішим, швидшим і надійнішим.

    Ключові функції GitHub MCP Registry

    1. Централізований індекс MCP-серверів

    Реєстр виступає як пошуковий індекс, де кожен MCP-сервер має повний набір метаданих, зокрема:

    • Назву та опис сервера
    • Підтримувані протоколи
    • Деталі сумісності
    • Інструкції з установки
    • Посилання на репозиторії

    Такий рівень деталізації дозволяє швидко оцінити сервер перед інтеграцією.

    2. Безшовна інтеграція з GitHub

    Оскільки реєстр інтегрований у екосистему GitHub, розробники можуть переглядати репозиторії, читати документацію й клонувати проєкти безпосередньо. Це зменшує переривання робочих процесів і підвищує продуктивність.

    3. Перевірені й надійні записи

    GitHub MCP Registry виділяє надійні джерела. Перевірені MCP-сервери позначаються спеціальними відмітками, що допомагає відрізнити експериментальні проєкти від готових до продакшну рішень.

    4. Постійні оновлення

    Кожна записана позиція MCP-сервера пов’язана з його репозиторієм на GitHub, тому оновлення відслідковуються в реальному часі. Розробники завжди отримують найсвіжіші версії, не турбуючись про застарілий код або непрацюючі посилання.

    Як MCP Registry спрощує роботу розробників

    GitHub MCP Registry — це не просто каталог. Він змінює сам підхід до роботи з MCP:

    • Швидкий старт: нові команди можуть знаходити готові рішення за лічені хвилини.
    • Покращена документація: кожна позиція має докладні інструкції.
    • Зменшення дублювання: команди можуть повторно використовувати сервери спільноти замість створення власних.
    • Єдині стандарти у проєктах: стандартизовані записи підтримують узгодженість між різними проєктами.

    Ця ефективність безпосередньо скорочує цикли розробки та знижує витрати.

    Як користуватися GitHub MCP Registry

    Процес використання простий:

    1. Перейдіть до реєстру через GitHub.
    2. Знайдіть або відфільтруйте сервери за категоріями, протоколами чи сценаріями.
    3. Перегляньте метадані, щоб перевірити сумісність із вашим проєктом.
    4. Клонуйте або форкніть репозиторій прямо з реєстру.
    5. Дотримуйтеся документації, наданої для кожного сервера.

    Таким чином можна впровадити MCP-сервер за кілька хвилин.

    Сценарії використання MCP-серверів через GitHub Registry

    Реєстр допомагає створювати широкий спектр контекстно-обізнаних застосунків. Найпопулярніші сценарії:

    • AI-рішення: покращення чат-ботів і віртуальних асистентів завдяки контексту.
    • Корпоративні інтеграції: спрощення роботи ERP, CRM та HRM-систем за допомогою готових MCP-серверів.
    • IoT і edge computing: керування контекстом розподілених пристроїв для підвищення ефективності.
    • Інструменти розробників: прискорення тестування, налагодження та розгортання.

    Завдяки централізованому пошуку серверів GitHub дозволяє організаціям масштабувати такі сценарії без додаткових витрат на дослідження.

    Переваги для open-source спільнот

    GitHub MCP Registry корисний не лише корпоративним командам, а й спільноті з відкритим кодом.

    • Видимість для авторів: розробники MCP-серверів отримують більше уваги завдяки публікації у реєстрі.
    • Спільний внесок: інші учасники можуть вдосконалювати код, виправляти помилки й додавати документацію.
    • Єдині стандарти: спільноти можуть узгоджувати практики роботи з MCP, зменшуючи проблеми сумісності.

    Ця демократизація прискорює інновації у глобальному масштабі.

    Майбутнє пошуку MCP з GitHub

    Майбутнє MCP пов’язане з доступністю, автоматизацією та розвитком спільноти. GitHub MCP Registry має всі шанси стати де-факто стандартом для пошуку MCP-серверів, подібно до того, як менеджери пакетів змінили керування залежностями.

    Очікуються нові можливості:

    • Розширені фільтри пошуку для галузей і протоколів.
    • Автоматичне сканування безпеки для захисту серверів.
    • Розширена аналітика для відстеження використання та популярності серверів.

    Ці функції зроблять реєстр ще ціннішим інструментом.

    Найкращі практики роботи з GitHub MCP Registry

    Щоб отримати максимум користі, рекомендуємо:

    • Додавати в закладки ключові сервери, щоб слідкувати за оновленнями.
    • Підписуватися на авторів, отримуючи доступ до їхнього досвіду.
    • Вносити власний внесок у реєстр, підтримуючи розвиток спільноти.
    • Перевіряти сумісність перед розгортанням у продакшні.

    Дотримуючись цих порад, організації зможуть повністю розкрити потенціал MCP і водночас підтримати open-source екосистему.

    Висновок

    GitHub MCP Registry змінює підхід до пошуку й впровадження MCP-серверів. Завдяки централізованому каталогу, перевіреним записам і інтеграції з GitHub, це сьогодні найшвидший і найнадійніший спосіб вивчати MCP-сервери.

    Реєстр спрощує пошук, стандартизацію та співпрацю, скорочуючи складність і пришвидшуючи впровадження MCP як для розробників, так і для компаній. Із розвитком технологій MCP реєстр залишатиметься у лідерах, допомагаючи командам впроваджувати інновації швидше й ефективніше.

  • Як DevOps допомагає компаніям ставати високоефективними

    У сучасному швидкозмінному світі здатність компанії швидко й надійно розробляти та випускати програмне забезпечення є ключовою конкурентною перевагою. Книга Accelerate: The Science of Lean Software and DevOps – Building and Scaling High-Performing Technology Organizations (2018), написана Ніколь Форсґрен, Джезом Гамблом і Джином Кімом, стала фундаментальною працею в цій сфері. Вона ґрунтується на наукових дослідженнях і показує, як організації можуть досягати видатних результатів у доставці програмного продукту.

    Науковий підхід до трансформації

    Висновки Accelerate базуються на чотирирічному дослідженні, розпочатому у 2013 році. Мета полягала у визначенні практик і підходів, що дозволяють компаніям пришвидшувати випуск програмного забезпечення та отримувати вимірювану бізнес-цінність. На відміну від окремих кейсів, це дослідження застосовує академічну строгість, що робить результати надійними й релевантними для індустрії.

    У дослідженні було проаналізовано понад 23 000 анкет із 2000+ організацій у всьому світі. У вибірку увійшли як стартапи, так і великі корпорації, включно з жорстко регульованими галузями — фінансами, охороною здоров’я та державним сектором. Використання крос-секційних опитувань і шкали Лайкерта дозволило авторам виявити значущі статистичні залежності, а не лише поодинокі історії.

    Ключове відкриття: швидкість і надійність взаємопов’язані

    Один із головних висновків книги: компаніям не потрібно обирати між швидкістю та стабільністю. Насправді надійність забезпечує вищу швидкість.

    Високоефективні команди стабільно перевершують інших за всіма показниками. Ба більше, якісні ІТ-практики прямо впливають на бізнес-результати: прибутковість, продуктивність і частку ринку. У 2017 році компанії-лідери вдвічі частіше перевиконували бізнес-цілі, ніж відстаючі.

    Автори також критикують «моделі зрілості», які передбачають лінійний шлях до певного стану. Натомість вони пропонують «моделі можливостей» — гнучкий, безперервний процес удосконалення, що враховує контекст кожної компанії.

    Чотири ключові метрики ефективності

    Виділено чотири універсальні показники:

    1. Частота релізів — як часто код потрапляє у продакшен. Лідери робили це у 46 разів частіше.
    2. Час від коміту до релізу — швидкість доставки змін. У топ-команд він був у 440 разів коротший, іноді менш ніж година.
    3. Середній час відновлення (MTTR) — швидкість усунення збоїв. У лідерів він був у 170 разів швидший.
    4. Відсоток невдалих змін — частка релізів, що спричиняють проблеми. У топ-команд цей показник був у 5 разів нижчий.

    Разом ці метрики створюють повну картину швидкості й якості доставки.

    24 ключові практики для підвищення результативності

    Дослідження виокремило 24 практики, що покращують ефективність. Вони поділені на п’ять категорій:

    • Неперервна доставка: контроль версій усіх артефактів, автоматизація деплою, CI, trunk-based development, автоматизоване тестування, управління тестовими даними, рання інтеграція безпеки.
    • Архітектура: слабозв’язані системи й автономні команди.
    • Продукт і процеси: регулярний зворотний зв’язок від клієнтів, робота малими партіями, прозорість задач, культура експериментів.
    • Управління й моніторинг: спрощене погодження змін, проактивний моніторинг, обмеження WIP, візуалізація прогресу.
    • Культура: генеративна культура, довіра, співпраця, осмислена робота, кросфункціональна взаємодія й трансформаційне лідерство.

    Вплив на людей: менше стресу й вигорання

    Окрім продуктивності, ці практики позитивно впливають на працівників. Автоматизовані й передбачувані релізи знижують рівень стресу та роблять процеси більш стабільними. Успішні команди витрачають менше часу на виправлення проблем і більше — на створення нового функціоналу. Лідери, які підтримують команди, допомагають зменшити ризик вигорання.

    Приклад: ING Netherlands

    У книзі детально описана трансформація ING Netherlands:

    • Структура: компанія перейшла на модель «Tribes» і «Squads», де команди автономні та орієнтовані на клієнта.
    • Візуальне управління: «Obeya»-кімнати й дошки для прозорості цілей і прогресу.
    • Рутини: щоденні 15-хвилинні стендапи та система «catchball» для швидкого обміну інформацією.
    • Культура навчання: виділення часу на вдосконалення й інновації, підтримка лідерів у пріоритизації якості.

    Висновок

    Accelerate — це не лише книга про технології. Це посібник із побудови організацій, де культура, процеси й люди працюють разом для сталого успіху. Висока ефективність не купується і не копіюється напряму — її потрібно формувати через експерименти, навчання й адаптацію. Інвестиції в правильні практики й культуру допомагають компаніям покращувати бізнес-результати та створювати робоче середовище, де команди щасливі й продуктивні.

  • Distributed Application Runtime: Спрощення розробки мікросервісів в Azure

    Створення масштабованих, хмарних застосунків стало основою сучасної цифрової трансформації. Distributed Application Runtime (Dapr) — один із найпотужніших фреймворків для розробників, що працюють із мікросервісами в Azure, який надає єдиний підхід до спрощення розробки розподілених застосунків. У цій статті ми розглянемо, як Dapr підвищує продуктивність розробників, полегшує інтеграцію та допомагає компаніям створювати стійкі, подієво-орієнтовані застосунки у хмарі.

    Що таке Distributed Application Runtime (Dapr)?

    Dapr — це портативне середовище виконання з відкритим кодом, створене для спрощення розробки мікросервісів. Воно надає стандартизовані будівельні блоки, які абстрагують складність розподілених систем, таких як виявлення сервісів, керування станом, подієва комунікація та спостережуваність. Завдяки Dapr розробники можуть зосередитись на бізнес-логіці замість повторного вирішення інфраструктурних задач.

    Основою роботи Dapr є модель sidecar-процесу, що працює поруч із застосунком і забезпечує підтримку будь-якої мови програмування. Застосунки на .NET, Java, Python, Node.js чи Go можуть взаємодіяти з API Dapr через HTTP або gRPC.

    Чому мікросервісам в Azure потрібен Dapr

    Архітектура мікросервісів дозволяє розділяти застосунок на невеликі, незалежно розгорнуті компоненти. Попри переваги, цей підхід має виклики:

    • Виявлення та комунікація сервісів

    • Безпечне керування секретами в розподілених системах

    • Послідовне керування станом у stateless-архітектурі

    • Подієва комунікація (pub/sub)

    • Спостережуваність та телеметрія для багатьох сервісів

    Dapr вирішує ці проблеми завдяки вбудованим компонентам, які легко інтегруються з сервісами Azure, зокрема Azure Kubernetes Service (AKS), Azure Functions, Azure Event Hubs, Cosmos DB та Key Vault. Це робить його ідеальним фреймворком для cloud-native розробки.

    Основні будівельні блоки Dapr

    Dapr надає розробникам набір модульних компонентів, які можна використовувати незалежно. Ось головні з них:

    1. Виклик сервісів (Service Invocation)

    Dapr забезпечує безпечну та надійну комунікацію між сервісами за допомогою механізму виявлення. Замість жорсткого зазначення IP-адрес розробники звертаються до API Dapr, який сам виконує маршрутизацію.

    2. Керування станом (State Management)

    Мікросервіси часто потребують збереження стану. Dapr надає API для роботи зі станом, інтегровані з Azure Cosmos DB, Azure Table Storage, Redis і SQL. Це спрощує збереження та отримання даних без складної синхронізації.

    3. Публікація/підписка (Publish/Subscribe Messaging)

    Dapr спрощує реалізацію подієво-орієнтованих систем завдяки вбудованій моделі pub/sub. Сервіси публікують події, не знаючи, хто є підписниками. Dapr легко інтегрується з Azure Service Bus, Event Hubs і Kafka.

    4. Прив’язки (Bindings)

    Dapr дозволяє підключати застосунки до зовнішніх систем (черг, баз даних, хмарних сервісів) за допомогою вхідних та вихідних прив’язок. Це дає змогу реагувати на тригери чи надсилати дані з мінімальною кількістю коду.

    5. Актори (Actors)

    Модель віртуальних акторів полегшує роботу зі станом та об’єктами. Кожен актор має власний стан і модель конкурентності, що зручно для IoT-пристроїв та користувацьких сесій.

    6. Керування секретами (Secrets Management)

    Замість зберігання паролів і ключів у коді, Dapr інтегрується зі сховищами секретів, такими як Azure Key Vault, забезпечуючи безпечне отримання та ротацію секретів.

    7. Спостережуваність (Observability)

    Dapr автоматично інтегрується з системами моніторингу, такими як Azure Monitor та Application Insights, забезпечуючи метрики, логи й трасування без додаткового коду.

    Як працює Dapr в Azure

    Dapr та Azure Kubernetes Service (AKS)

    У AKS Dapr працює як sidecar-контейнер, розгорнутий поруч із застосунком. Кожен мікросервіс взаємодіє зі своїм sidecar через HTTP/gRPC, а Dapr бере на себе комунікацію, збереження стану й інтеграцію з сервісами Azure.

    Dapr та Azure Functions

    Dapr розширює можливості serverless-застосунків, дозволяючи Azure Functions використовувати його API. Це спрощує створення подієво-орієнтованих рішень з мінімальними налаштуваннями інтеграції.

    Dapr у гібридних та мультихмарних сценаріях

    Оскільки Dapr не залежить від хмарного провайдера, застосунки можна запускати в Azure, AWS, Google Cloud або локальних кластерах Kubernetes. Це гарантує єдиний підхід до розподілених систем.

    Переваги використання Dapr у мікросервісах Azure

    1. Спрощена розробка

    Dapr знімає необхідність вручну вирішувати інфраструктурні завдання, дозволяючи зосередитись на бізнес-логіці.

    2. Портативність

    Застосунки на Dapr не прив’язані до конкретної хмари, що забезпечує гнучкість мультихмарних рішень.

    3. Підвищена стійкість

    Механізми Dapr (ретраї, failover, консистентність стану) роблять застосунки в Azure надійнішими.

    4. Готова інтеграція з Azure

    Завдяки готовим компонентам для сервісів Azure, розробка мікросервісів відбувається швидше.

    5. Швидкий вихід на ринок

    Стандартизовані API дозволяють швидко проєктувати, тестувати й впроваджувати застосунки.

    Найкращі практики впровадження Dapr в Azure

    1. Використовуйте sidecar-патерн для ізоляції та масштабованості мікросервісів.

    2. Поєднуйте Dapr з керованими сервісами Azure (Cosmos DB, Event Hubs, Key Vault).

    3. Налаштовуйте телеметрію від початку для зручного моніторингу й налагодження.

    4. Проєктуйте застосунки з урахуванням портативності, уникаючи специфічного для хмари коду.

    5. Використовуйте pub/sub-архітектуру для масштабованості та слабкої зв’язності.

    Реальні сценарії застосування Dapr в Azure

    • E-commerce — обробка замовлень через pub/sub, збереження кошика через state API, керування сесіями користувачів за допомогою акторів.

    • IoT — збереження стану пристроїв, обробка телеметрії через pub/sub, інтеграція з Azure Functions.

    • Фінансові сервіси — безпечні транзакції, розподілене збереження стану, відмовостійкі виклики сервісів.

    • Медицина — об’єднання різних систем через прив’язки та API з безпечним доступом.

    Майбутнє Dapr у хмарній розробці

    Зі зростанням популярності cloud-native та мікросервісної архітектури роль Dapr в Azure лише посилюватиметься. Підтримуваний Microsoft і спільнотою open-source, він розвиватиметься, пропонуючи нові компоненти, покращені інтеграції та ширше застосування. Dapr стає ключовим інструментом для спрощення розробки розподілених застосунків.

    Висновок

    Distributed Application Runtime (Dapr) змінює підхід до створення мікросервісів в Azure. Він спрощує комунікацію сервісів, керування станом, події та моніторинг, пришвидшуючи розробку й підвищуючи стійкість застосунків. Його незалежність від конкретної хмари та тісна інтеграція з Azure роблять його оптимальним вибором для компаній, що працюють із Microsoft Cloud.